
在 AI 图像生成领域风起云涌的 2025 年,一款名为 Z‑Image AI 的开源模型突然成为社交媒体的焦点。从 Hugging Face 到 Bilibili,再到 X 平台,用户们纷纷分享“6B 参数秒出摄影级图像”“本地跑无审查 NSFW 内容”“Flux 2 杀手级替代品”等体验,教程视频播放量轻松破百万。Z‑Image 由阿里巴巴 Tongyi‑MAI 实验室推出,于 2025 年 11 月 25 日正式开源,短短两周内 GitHub star 数超 5 万,下载量逾 10 万次。 作为一款仅 6B 参数的轻量级基础模型,它在 Elo 图像生成基准上位列开源前列,生成速度快至 1 秒,VRAM 需求仅 8G,远低于 Midjourney 或 DALL‑E 的云端依赖。 YouTube 博主零度解说称:“Z‑Image 是 2025 年最值得入手的免费 AI 工具,无需高配电脑,就能实现专业级编辑。” PCMag 测试显示,其在摄影级真实感图像生成上表现突出,爆火源于“低门槛、高自由度”的完美平衡,在开源社区引发“Z‑Image 革命”。这一现象,不仅凸显中国 AI 研发的全球影响力,还预示图像生成从“云端垄断”向“本地普惠”的转变。
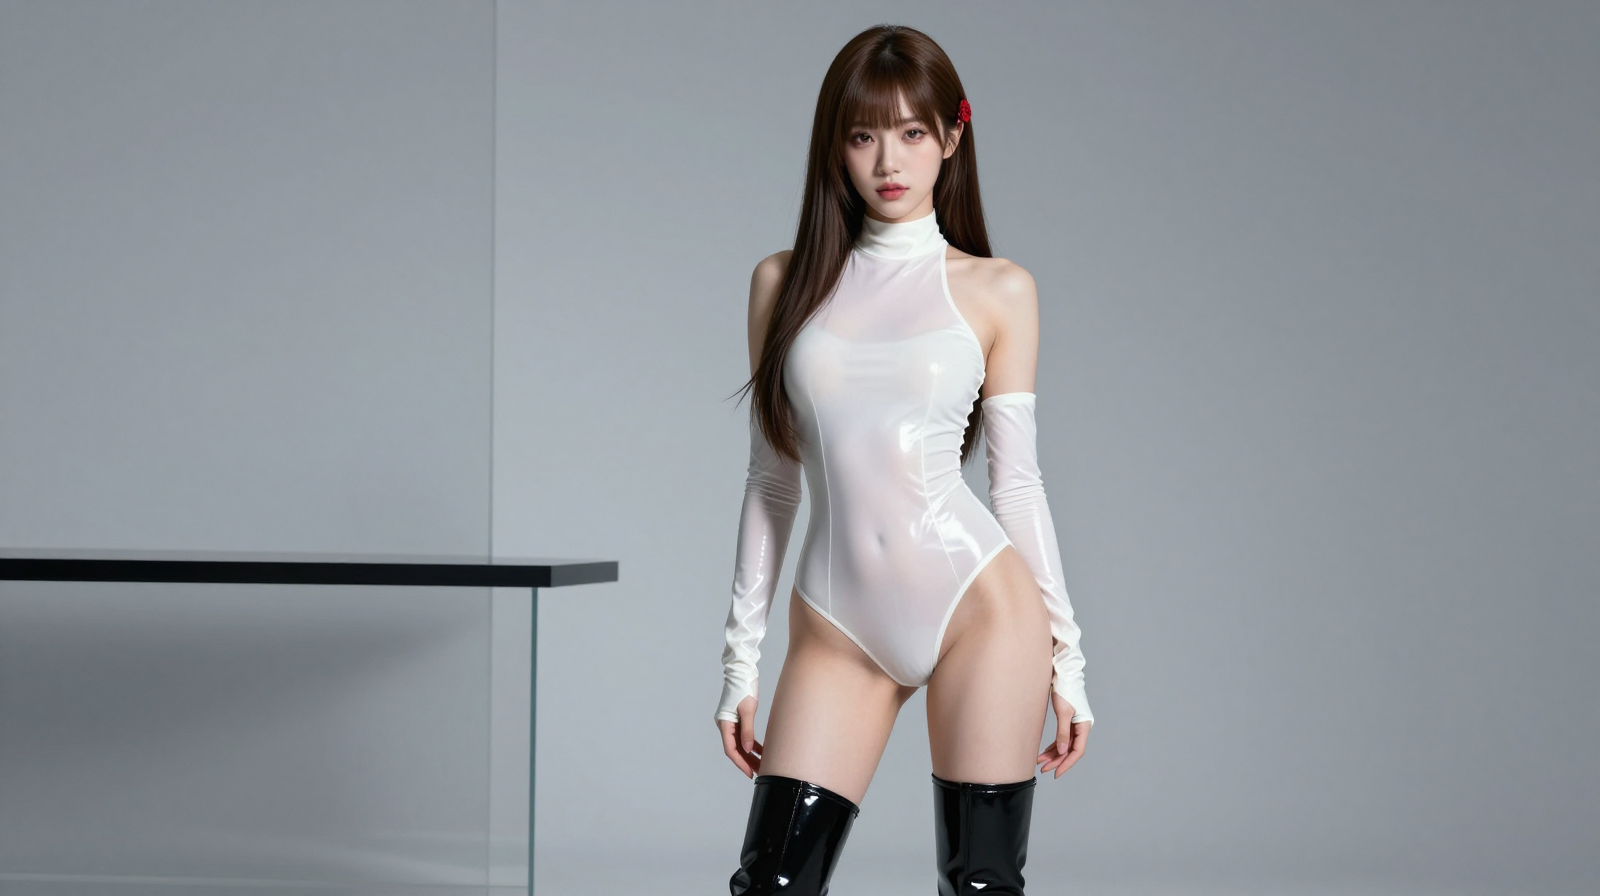
Z‑Image AI 并非凭空出现,而是阿里巴巴 Tongyi‑MAI 实验室的最新力作。该实验室隶属阿里云,专注于多模态 AI 研究,曾推出 Qwen 系列语言模型。 Z‑Image 是其图像生成领域的首款开源产品,基于自主研发的 Transformer 架构,参数规模仅 6B,却在生成质量上媲美 70B 的 Flux 2。 与 Google 的 Nano Banana Pro 不同,后者是 Google 2025 年 11 月推出的图像编辑工具,支持 4K 生成,但需云端 API 且有内容审查。 Z‑Image 并非 Nano Banana 的优化版,而是独立开发,强调“Turbo”速度和本地部署。实验室表示,Z‑Image 训练于海量多语种数据集,支持英文、中文提示,生成图像时注重真实感和细节控制。 爆火源头可追溯到 11 月 27 日,一位名为 Angry Tom 的 X 用户发帖展示 Z‑Image 生成的 HIV 图像,称其“绝对不尊重传统模型”,帖子获 428 赞。 随后,Reddit r/StableDiffusion 和 YouTube 博主如 LuffyTheFox 跟进教程,分享“狐狸精”风格图像,浏览量暴增。 Bpay News 报道称,Z‑Image “成为 AI 美术的新王者”,强调其轻量级和双语支持。
Z‑Image 的核心功能是高效图像生成和编辑,支持文本到图像(T2I)、图像到图像(I2I)和风格迁移。它在摄影级真实感上特别出色,能生成“数码相机拍摄”的高保真图像,细节如光影、纹理和颜色过渡自然流畅。 与 Flux 2 相比,Z‑Image 生成时间更短(6‑9 步推理),VRAM 需求低,适合中端 GPU 用户。用户可输入提示如“一个可爱的狐狸精在森林中”,模型输出摄影风格图像,支持 NSFW 内容无审查。 Medium 文章《Best AI Image Generators of 2025 1H》将 Z‑Image 评为免费工具前五,赞其“6B 参数实现摄影级真实”。 爆火原因还包括社区生态:集成 ComfyUI 和 Stability Matrix,用户可免费训练 LoRA 扩展模型。 Reddit 用户分享 LoRA 训练教程,获数百赞。
安装 Z‑Image 非常简单,支持 Windows、Mac 和 Linux,只需基本 GPU(8G VRAM)。以下基于 Hugging Face 和 YouTube 教程的详细步骤。
步骤1:环境准备(10‑20 分钟)
- 确保电脑有 NVIDIA GPU(RTX 3060+),安装最新驱动(nvidia.com/drivers)。
- 下载 Python 3.10+(python.org)和 Git(git‑scm.com)。
- 安装 CUDA 12.1+(developer.nvidia.com/cuda‑downloads),重启电脑。
- 打开终端,运行:
git clone https://github.com/comfyanonymous/ComfyUI.git
cd ComfyUI
pip install torch torchvision torchaudio --extra-index-url https://download.pytorch.org/whl/cu121
pip install -r requirements.txt
步骤2:下载模型(5‑15 分钟)
- 访问 Hugging Face(huggingface.co/Tongyi‑MAI/Z‑Image‑Turbo),下载“z‑image‑turbo‑v1.safetensors”(约 6GB)。
- 放置到 ComfyUI/models/checkpoints 文件夹。
- 下载 ControlNet 模型(如 control_v11p_sd15_inpaint.pth,1GB),放 models/controlnet。
- 可选:下载 VAEs(如 vae‑ft‑mse‑840000‑ema‑pruned.safetensors),放 models/vae。
步骤3:启动和使用(2 分钟)
- 终端运行:python main.py
- 浏览器打开 http://127.0.0.1:8188,界面如 Stable Diffusion WebUI。
- 使用流程:加载 Z‑Image 模型,选择提示词(如“a cute fox in forest, realistic photography”),设置步数 6‑9,点击 Generate。输出图像保存本地。
- 编辑模式:上传原图,选择 Inpaint,输入修改提示(如“change fox to dog”)。
使用 Z‑Image 时,生成速度快至 1‑3 秒/张,适合初学者。高级用户可通过 LoRA 训练自定义风格:收集 10‑20 张图片,运行训练脚本(Hugging Face 提供),时长 30 分钟。 免费版支持无限生成,但需 GPU;云端版如 waive.online 提供在线试用。
尽管爆火,Z‑Image 也有局限:NSFW 内容易滥用,社区呼吁自制;复杂场景下细节偶尔失真,需多次迭代。 未来,阿里巴巴计划扩展到视频生成,Z‑Image 或成 Flux 2 的开源替代。
Z‑Image 的问世,证明开源 AI 的普惠力量。安装只需半小时,就能开启创意之旅——从自拍编辑到艺术创作,它让每个人都成为“图像大师”。