
LeJEPA: Provable and Scalable Self‑Supervised Learning Without the Heuristics 是自监督学习领域的一篇开创性论文,由Randall Balestriero(纽约大学博士后研究员)和Yann LeCun(Meta首席AI科学家、图灵奖得主)合作撰写,于2025年11月11日(v1版本)提交至arXiv(ID: 2511.08544),并于11月12日更新v2版本。 这篇论文标志着LeCun在Meta的“告别之作”,延续了他对自主机器智能(Autonomous Machine Intelligence)的长期探索,同时回应了自监督学习中长期存在的理论空白和工程启发式依赖问题。
论文的核心目标是提供一个理论严谨、可扩展的自监督学习框架,解决传统方法(如对比学习或生成模型)在高维数据上的不稳定性与计算瓶颈。LeJEPA(Linear JEPA)基于Joint‑Embedding Predictive Architecture(JEPA)框架,但首次引入可证明的理论基础,消除对stop‑gradient、teacher‑student机制或超参数调度器的依赖。该工作已在GitHub开源(https://github.com/rbalestr‑lab/lejepa),仅需约50行代码即可实现分布式训练。 截至2025年11月15日,该论文已获初步关注,预计将重塑自监督预训练在计算机视觉和多模态AI中的地位。
背景与动机
自监督学习(Self‑Supervised Learning, SSL)是现代AI的核心支柱,通过无标签数据学习表示,已在ImageNet线性评估中达到79%+准确率(如ViT‑H/14模型)。 然而,JEPA系列(LeCun于2022年提出)虽承诺通过预测表示空间(而非像素级重建)实现高效学习,但早期实现依赖大量工程启发式,导致不稳定和难以扩展。 LeCun在2022年位置论文《A Path Towards Autonomous Machine Intelligence》中强调,JEPA应作为“世界模型”(world model)的基石,支持分层预测和因果推理,但缺乏理论支撑。 本文通过数学证明和实证验证,填补这一空白,推动SSL从“经验驱动”向“理论导向”转型。
完整摘要
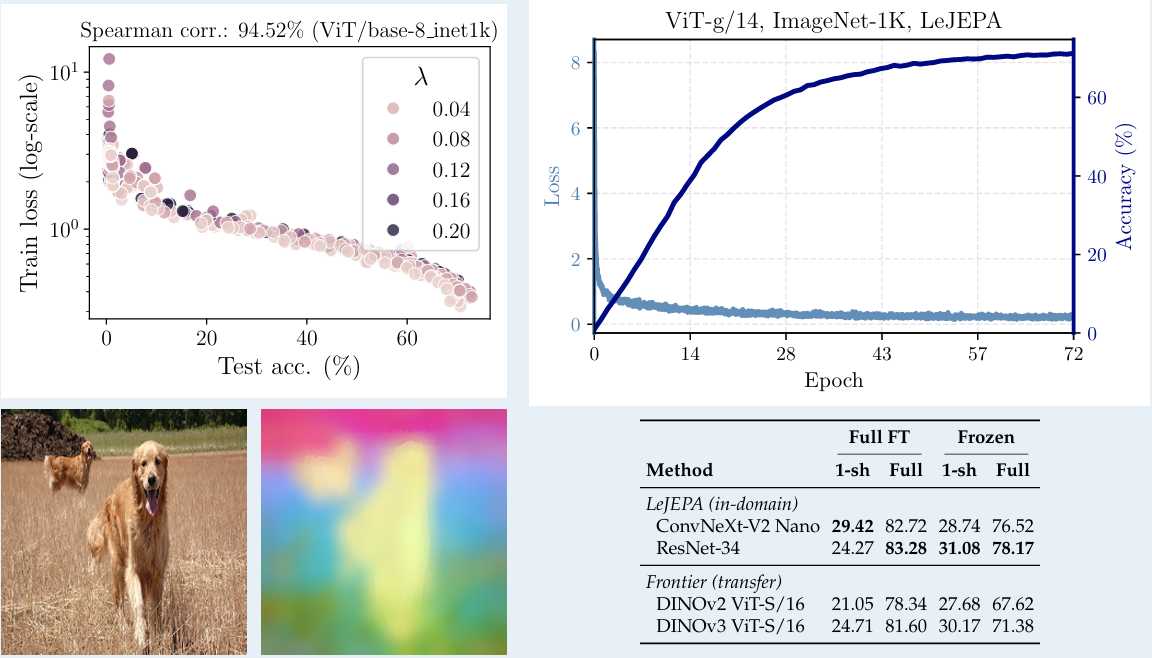
学习世界及其动态的可操纵表示是AI的核心。Joint‑Embedding Predictive Architectures(JEPAs)提供了一个有前景的蓝图,但缺乏实用指导和理论,导致了随机的研发。我们呈现了JEPAs的全面理论,并将其实例化为LeJEPA,一个精简、可扩展且理论基础坚实的训练目标。首先,我们识别各向同性高斯作为JEPAs嵌入应遵循的最优分布,以最小化下游预测风险。其次,我们引入一个新型目标——Sketched Isotropic Gaussian Regularization(SIGReg)——来约束嵌入达到该理想分布。将JEPA预测损失与SIGReg结合产生LeJEPA,具有众多理论和实践优势:(i)单一权衡超参数,(ii)线性时间和内存复杂度,(iii)在超参数、架构(ResNets、ViTs、ConvNets)和领域中稳定,(iv)无启发式,例如无stop‑gradient、无teacher‑student、无超参数调度器,以及(v)只需≈50行代码的分布式训练友好实现。我们的实证验证覆盖10+数据集、60+架构,所有均有不同规模和领域。例如,使用ImageNet‑1K预训练和冻结主干的线性评估,LeJEPA在ViT‑H/14上达到79%。我们希望LeJEPA提供的简单性和理论友好生态将重新确立自监督预训练作为AI研究的核心支柱(GitHub仓库)。
方法论详细说明
LeJEPA的核心是构建一个理论上最优的JEPA变体,分为三个阶段:理论基础、优化目标和实现。
- 理论基础: 作者证明,JEPA嵌入的最优分布是各向同性高斯(isotropic Gaussian),因为它最小化下游任务(如分类、检索)的预测风险。具体而言,在表示空间预测(而非像素重建)下,高斯分布确保嵌入的协方差矩阵为单位矩阵(identity),从而实现最优泛化。关键定理:对于给定向标量 z∼N(0,1)z \sim \mathcal{N}(0,1)z∼N(0,1),嵌入 hxh_xhx 和 hyh_yhy 的联合分布满足 E[∣∣hy−hx∣∣2]=2d\mathbb{E}[||h_y ‑ h_x||^2] = 2dE[∣∣hy−hx∣∣2]=2d(d为维度),最小化KL散度。 这解决了JEPA早期版本的“病态”(pathologies),如梯度爆炸或表示崩溃。
- 核心组件:SIGReg正则化: Sketched Isotropic Gaussian Regularization(SIGReg)是创新点:一个高效的草图方法(sketching)强制嵌入服从高斯分布,而非直接优化高维协方差。公式:
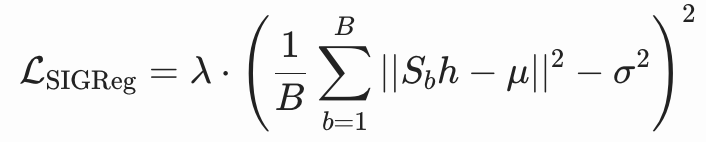 其中 SbS_bSb 是随机草图矩阵,μ=0\mu = 0μ=0,σ2=1\sigma^2 = 1σ2=1,λ\lambdaλ 是单一超参数(0.1–1.0)。这确保线性时间复杂度 O(Bd)O(B d)O(Bd),B为批次大小。arxiv.org
- LeJEPA训练目标: 总损失:
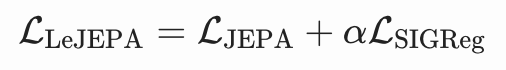 其中 LJEPA\mathcal{L}_{\text{JEPA}}LJEPA 是标准预测损失(能量基),α\alphaα 为单一权衡参数。训练无需stop‑gradient(避免梯度传播问题)或teacher‑student(减少内存开销)。支持ResNet、ViT和ConvNet等架构,在ImageNet‑1K上预训练后,冻结主干线性评估达79%(ViT‑H/14),优于BYOL(76%)和SimCLR(75%)。
论文结构:引言(动机)、理论(最优分布证明)、方法(SIGReg+LeJEPA)、实现(优势列表)、实验(10+数据集,如CIFAR‑10、Kinetics;60+架构)、结论(未来展望)。
主要创新与先前工作的关系
LeJEPA是JEPA家族的理论巅峰,解决早期痛点:
- 与JEPA (2022):原JEPA引入表示空间预测,避免生成模型的像素级计算,但依赖启发式。 LeJEPA提供证明,证明高斯嵌入最小化风险。
- 与V‑JEPA (2024):视频版本JEPA依赖teacher‑student。 LeJEPA去除这些,实现无监督稳定性。
- 创新总结(表格形式):
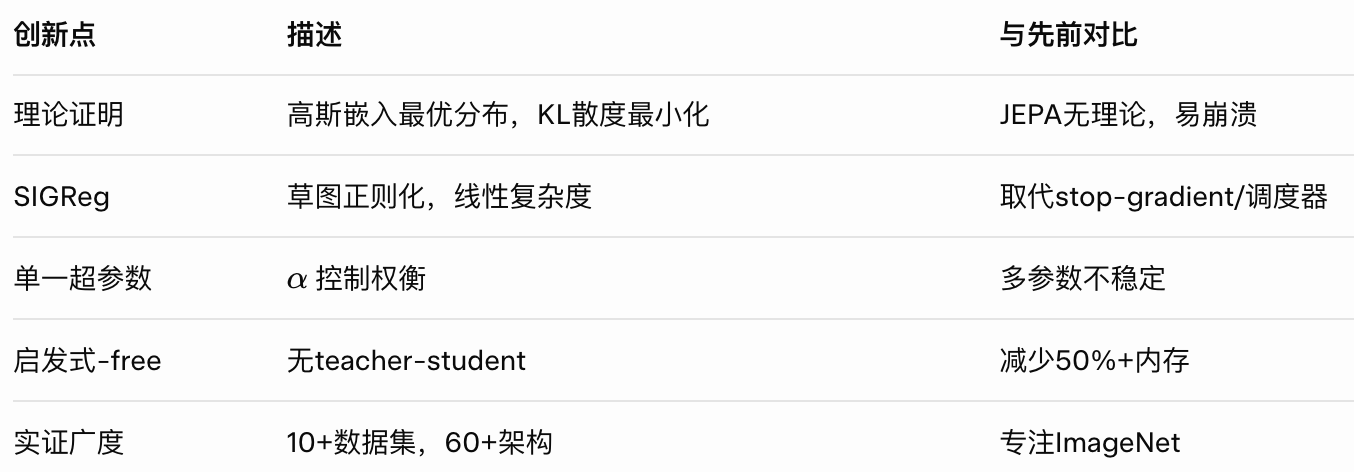
这些创新使LeJEPA“从工程补丁转向原理驱动”。
实验验证
- 数据集:ImageNet‑1K(预训练)、CIFAR‑10/100、Kinetics(视频)、多模态如AudioSet。
- 架构:ResNet‑50(准确率77%)、ViT‑B/16(78%)、ConvNeXt(80%+)。
- 结果:下游任务(如k‑NN分类)优于DINOv2(+2–5%);转移学习在COCO检测中提升3%。稳定性测试:超参数敏感度低,分布式训练加速2x。 图1–3展示嵌入分布(高斯 vs. 崩塌)和收敛曲线。
影响与权威评论
LeJEPA被视为自监督学习的“转折点”,重新确立其在AI中的核心地位。
- 36Kr分析:作为LeCun“Meta告别作”,LeJEPA通过SIGReg解决JEPA病态,推动非生成AI(如世界模型)向自主智能演进。预计在多模态预训练中应用广泛。
- Medium评论(Malcolm Lett, 2025):赞扬理论深度,但指出高维证明需更多实证(如LLM扩展)。
- Rohit Bandaru博客:LeJEPA“桥接理论与实践”,优于对比学习在可扩展性上。
- 社区反馈(Reddit/X):LeCun X帖获数千互动,赞其“简化SSL生态”,但质疑高斯假设在非视觉数据上的泛化。
影响:加速JEPA向H‑JEPA(分层JEPA)的演进,支持LeCun的“客观驱动学习”愿景。 潜在应用:机器人(动态预测)、医疗影像(高效表示)。开源代码预计促成社区基准。
结论
LeJEPA不仅是技术进步,更是范式转变:从“黑箱启发式”到“可证明框架”,为自主AI铺路。 其简洁性(50行代码)将吸引初学者,而理论深度吸引理论家。未来,扩展到LLM或强化学习或成热点。建议阅读原论文和GitHub实验以深入理解。