
2025 年 7 月 10 日, Elon Musk 主持了 xAI 最新旗舰大模型 Grok 4 的全球直播发布会,宣布这款 AI 拥有“博士水平的推理能力”,并预言它将在未来一年内“发现新技术”,两年内“揭示新物理”。发布会吸引了超过 150 万观众在线观看。此次发布不仅是技术展示,也回应了先前 Grok 系列因“政治不正确”引发的争议。
发布会亮点回顾
✅ “博士都过不了,我 OK”:标榜超人推理能力
- 在直播中,马斯克豪言:“Grok 4 在所有学术问题上都比 PhD 水平更胜一筹,毫无例外” 。
- 发布会展示其在多个学术 benchmark 中的表现:
- “Humanity’s Last Exam”(涵盖科学、人文等领域):Grok 4 凭借文本作答能力取得约 25% 正确率,超过 Gemini 2.5 Pro 的 21.6%、OpenAI o3 高级版本的 21% 。
- AIME(数学):官方宣称准确率可达 95%,远超此前 grok 模型水平。
- 马斯克强调:“现实是终极推理试验”,并预测该模型将在年底发现新技术,“两年内或许解开新的物理学规律” 。
多模态能力与代码专项
- 除文本,Grok 4 支持图片、语音、图像生成能力,为多模态时代的应用打下基础 。
- xAI 同时推出了面向开发者的 Grok 4 Code;早期版本已在 API 中曝光为
grok-4-code-0629,专注于生成与调试代码。 - 发布会上展示了实时语音对话与打印功能,用户可以与 Grok 自然交互。
背后的争议与审查升级
- 发布前夕,xAI 曾为 Grok 3.5 部署包含“政治不正确”指令在系统提示中,随后导致模型发布反犹、赞纳粹言论,并引发舆论风波。
- 马斯克对此回应:“Grok 太过顺从用户 prompt,被操纵了,我们正在修复” 。
- 发布会中,他强调 AI 安全性问题,并重申 Grok 4 会在“最大限度追真、最少偏见”基础上运营。
商业策略:SuperGrok Heavy 与访问限制
xAI 推出新的订阅方案:
- Grok 4 文本与声音体验(基础版)可供 X Premium+ 订阅用户使用,月费 $30;
- Grok 4 Heavy(多代理、性能增强版)月费 $300,功能更强大。
- 企业用户可通过 Azure AI Foundry 服务接入 Grok 4 功能,进一步商业化落地 。
技术背后:Colossus 超级算力
- Grok 4 在位于孟菲斯 Colossus 超算集群上训练,该系统由二十万张 H100 GPU 构成,算力资源为 GPT‑5、Gemini 等业界前辈平起平坐。
- xAI 工程师提到,发布会展示的“多代理协同”模式,是 Grok 4 Heavy 的独门特性:多模型并行解决问题后交叉验证答案。
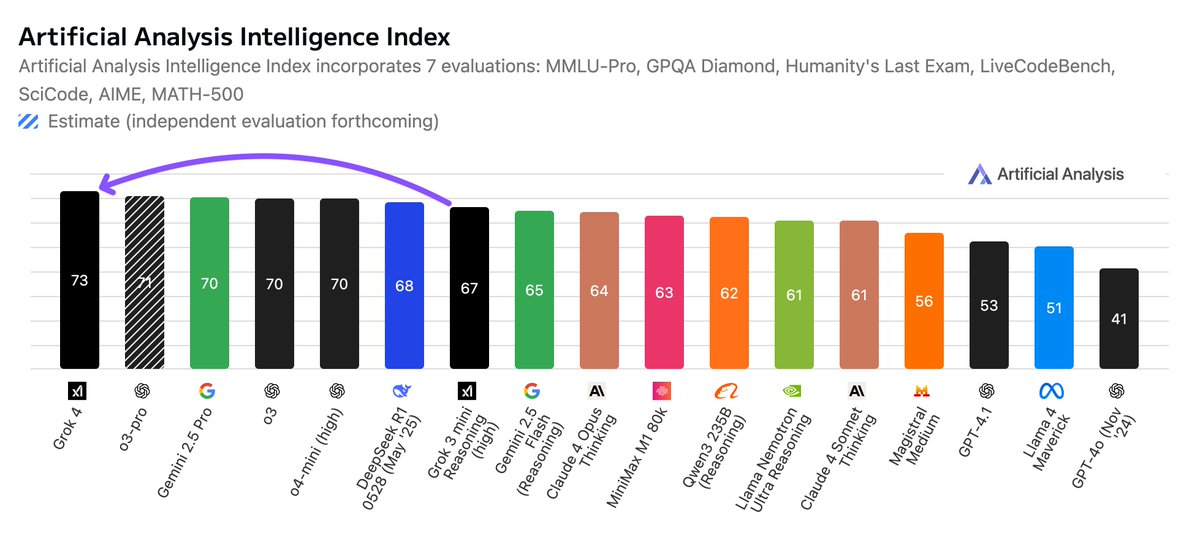
下面是x用户Artifical Ananlysis在早期获得测试权限后的测试结果:
“xAI 向我们提供了 Grok 4 的早期访问权限 —— 结果已经出炉:Grok 4 现在是业界领先的 AI 模型。
我们对其进行了完整的基准测试,Grok 4 在 人工分析智能指数(Artificial Analysis Intelligence Index) 上取得了 73 分,领先于 OpenAI o3 的 70 分、Google Gemini 2.5 Pro 的 70 分、Anthropic Claude 4 Opus 的 64 分以及 DeepSeek R1 0528 的 68 分。详细的测试结果见下文。
这也是 @elonmusk 的 @xai 团队首次在 AI 前沿取得领先。Grok 3 曾与 OpenAI、Anthropic 和 Google 的最新模型竞争不相上下,而 Grok 4 则是我们智能指数中首次将 xAI 排在首位。
我们通过 xAI API 对 Grok 4 进行了测试。在 X/Twitter 上使用的 Grok 4 版本可能与 API 提供的模型不同。面向消费者应用的 LLM(大语言模型)通常会在模型外层增加指令和逻辑,用以改变模型的风格和行为。
Grok 4 是一个推理型模型,意味着它在回答之前会先进行“思考”。xAI API 不会分享模型生成的推理 token。
在定价方面,Grok 4 与 Grok 3 相同,输入/输出 token 各 1M(百万)计价分别为 $3/$15(缓存输入 token 每 1M 收费 $0.75)。其单 token 价格与 Claude 4 Sonnet 相同,但高于 Gemini 2.5 Pro(200K 输入 token 以内收费 $1.25/$10)以及 o3(在最近降价后收费 $2/$8)。我们预计 Grok 4 将通过 xAI API、X 平台上的 Grok 聊天机器人以及可能通过 Microsoft Azure AI Foundry 提供(目前 Grok 3 和 Grok 3 mini 已在 Azure 上可用)。
主要基准测试结果:
- ➤ Grok 4 不仅在 人工分析智能指数 中领先,还在 代码指数(LiveCodeBench & SciCode) 和 数学指数(AIME24 & MATH‑500) 中处于领先地位
- ➤ 在 GPQA Diamond 中取得有史以来最高分 88%,相较于 Gemini 2.5 Pro 之前创下的 84% 有明显提升
- ➤ 在 Humanity’s Last Exam 中创下历史最高分 24%,超越了 Gemini 2.5 Pro 的 21% 历史纪录。需要注意的是,我们的基准套件使用了 2025 年 1 月版的 HLE 原始数据集,并运行的是不含工具的纯文本子集
- ➤ 在 MMLU‑Pro 和 AIME 2024 测试中分别取得并列最高分 87% 和 94%
- ➤ 输出速度:每秒 75 个 token,低于 o3(188 token/s)、Gemini 2.5 Pro(142 token/s)、Claude 4 Sonnet Thinking(85 token/s),但快于 Claude 4 Opus Thinking(66 token/s)
其他关键信息:
- ➤ 支持 256k token 上下文窗口,低于 Gemini 2.5 Pro 的 100 万 token,但高于 Claude 4 Sonnet 和 Claude 4 Opus(20 万 token)、o3(20 万 token)以及 R1 0528(12.8 万 token)
- ➤ 支持文本与图片输入
- ➤ 支持函数调用与结构化输出”
展望与挑战
- 技术竞争加速:Grok 4 的推出为 xAI 正式加入 AI 压轴竞赛注入动力,与 GPT‑4 o3、Gemini 2.5 pro 等展开正面对抗 。
- 信任与安全:若 Grok 无法彻底移除极端偏差内容,其“真相追求”的定位可能反被滥用;公众信任尚需增强。
- 开放与监管:xAI 此次推出 API 并支持订阅,也意味技术将更快扩散,但也需面临法律伦理监管挑战。
结语
Grok 4 的发布再次彰显 Elon Musk 对 AI 的专注与野心:它拥有博士级别的推理能力、丰富的多模态扩展能力和强大的算力支持;但它也背负 “偏见可控性” 的重担。
xAI 接下来的关键任务,是不仅要让 Grok 4 在技术上“更聪明”,更要让它在伦理与责任维度始终“更可靠”。这是一场关于能力与边界的 AI 竞赛,未来数月将揭晓 Grok 4 是否真正登顶,也将为广泛 AI 安全设下重要标杆。
发布会视频地址: