
2026年9月21日,xAI(现以SpaceXAI名义发布)正式推出Grok 4.7,并同步提供加速变体Grok 4.7 Fast。官方将其定位为面向编码、智能体任务与知识工作的主力模型:在更难、更长周期任务上工作更久、更注重自我校验,同时保持与Grok 4.6相同的基础价格与速度档位。Fast版则是同一模型运行在更快基础设施上,输出速度约翻倍,计费也约为标准档的两倍,目前仅在Cursor与Grok Build中提供,不进入公开xAI API。
详细情况
Grok 4.7基于比4.6更大的新基座,并经历更长的强化学习训练,任务配比向“需要数小时才能完成”的难题倾斜。官方强调其在自我验证、长上下文管理方面有改进,并针对Grok Bot智能体框架做了原生适配,从而在对话、文档与演示类知识工作上更稳。
规格要点:
- 上下文窗口:50万token
- 输入:文本与图像;输出:文本(无文本输出上限)
- 知识截止:约2026年5月
- 推理档位:low / medium / high(默认)/ xhigh
- API标识:grok‑4.7
定价(标准档,prompt低于20万token):
- 输入 2美元 / 百万token
- 缓存输入 0.50美元 / 百万token
- 输出 6美元 / 百万token
- 超过20万token后,输入/缓存/输出分别升至 4 / 1 / 12 美元。从4.5到4.7,xAI连续三代维持这一价位,形成明显的性价比策略。
Grok 4.7 Fast为同一权重、更快推理通道,价格约为标准档两倍,面向需要更低延迟的编码工作流,但不对公网API开放。
官方公布的基准表现
在xAI对比表中(Grok 4.7 xhigh vs Grok 4.6 high、GPT‑5.6 Sol max、Fable 5.1 max):
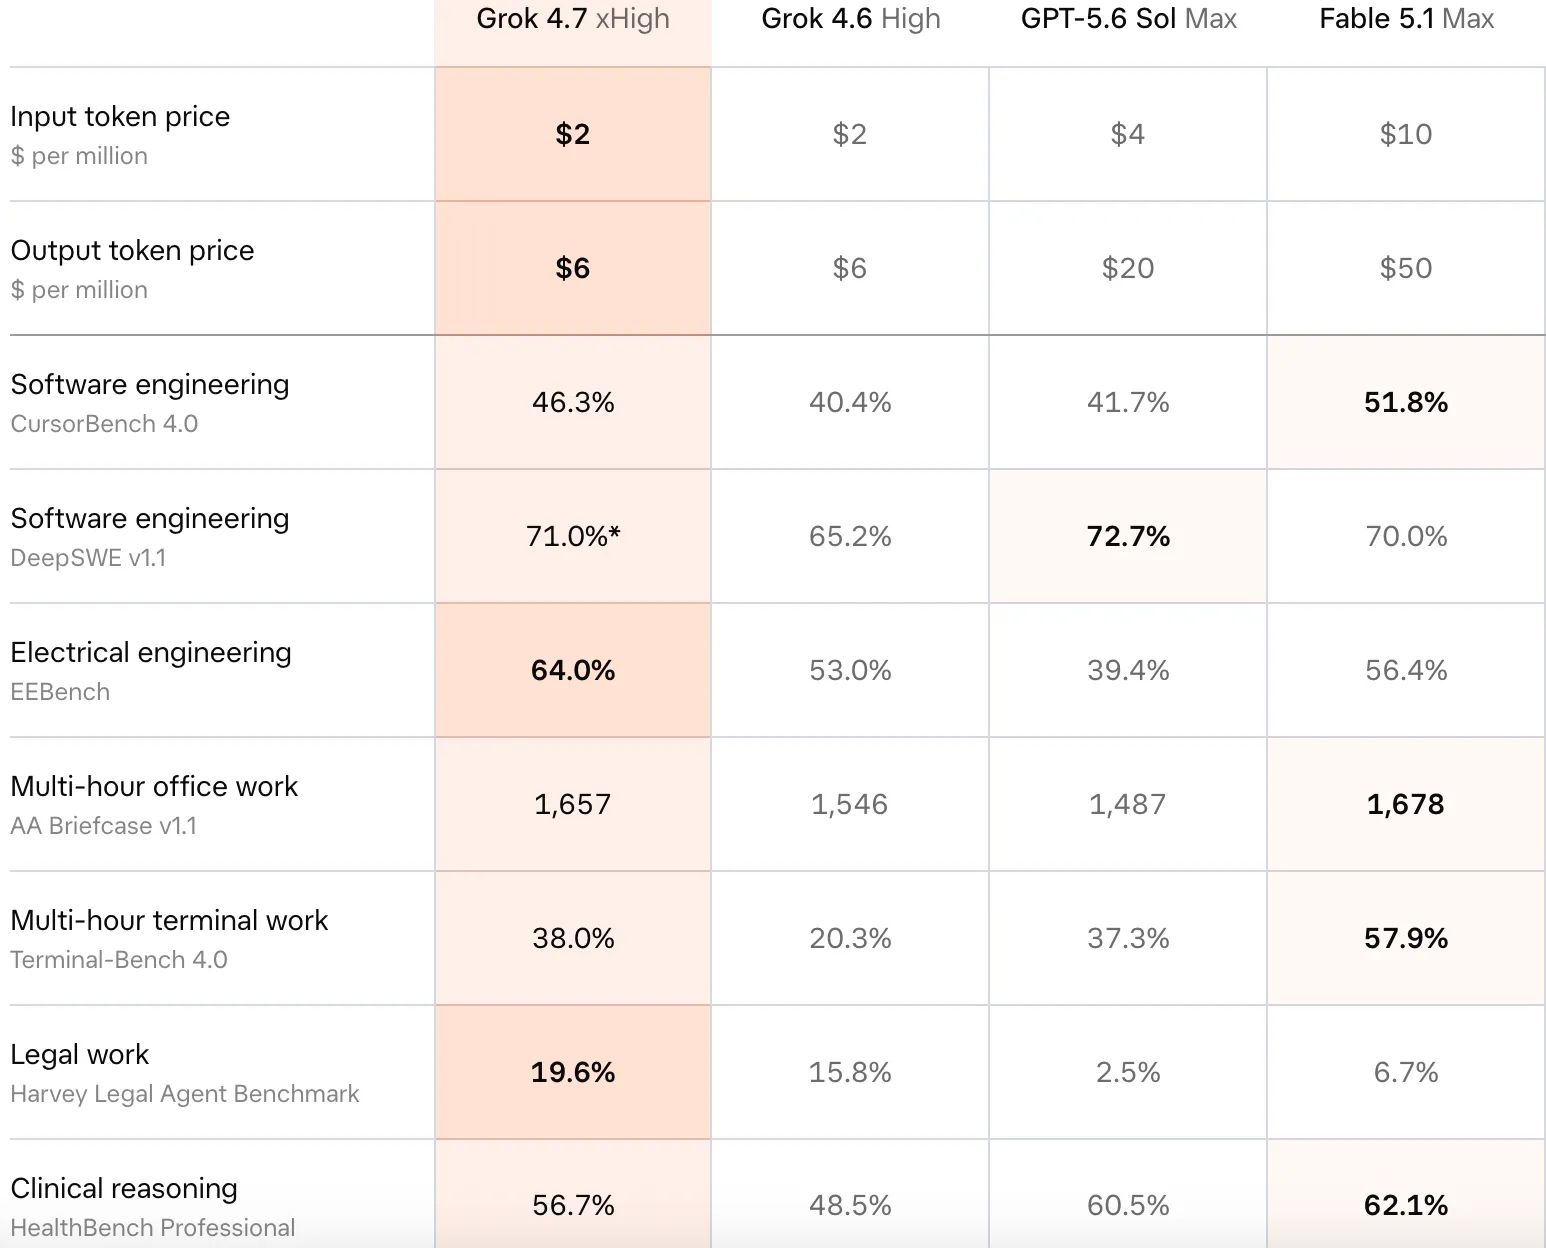
* high effort
- CursorBench 4.0:46.3%(4.6为40.4%)
- DeepSWE v1.1:71.0%(high effort;4.6为65.2%)
- Terminal‑Bench 4.0:38.0%(4.6为20.3%,单代提升最大的一项)
- EEBench:64.0%
- AA Briefcase v1.1:1657
- Harvey Legal Agent:19.6%
- HealthBench Professional:56.7%
整体看,相对4.6全面提升;相对GPT‑5.6 Sol在多项上领先或接近;相对Fable 5.1则互有胜负——编码与长任务部分仍落后,但在电气工程、法律Agent等项上有优势,而价格显著更低。独立评测平台也指出,4.7在智能体知识工作上进入前沿区间,但xhigh档会消耗更多输出token。上述数字多为厂商或初步第三方结果,完整复现仍在进行中。
安全方面,官方称其拒答与越狱抵抗为Grok系列迄今最强,同时对合法安全研究与防御性用途保持较低误拒率。
可能影响
1. 编码工具链竞争加剧。
Grok 4.7即日登陆Cursor与Grok Build,并可通过API及OpenRouter等网关调用。对开发者而言,这意味着在相近延迟下可用更低单价跑更长的Agent循环。Fast版则把“贵一点、更快一点”的选择留在IDE内,适合交互式编码。
2. 价格锚点被进一步钉死。
连续三代维持2/6美元,对标更高价的前沿模型,可能迫使市场把“性价比编码模型”当作独立品类,而不是只看榜单第一。
3. 长任务与自我校验成为卖点。
行业正从单次问答转向数十分钟至数小时的Agent工作流。4.7把训练权重放在长任务与自检上,反映这一方向;但更高推理档位也意味着token账单上升,企业仍需做成本管控。
4. 局限与风险。
Fast版不进公开API,生态覆盖不完整;部分基准为官方自报;独立评测显示综合指数未必全面超越上一代所有维度。参数规模等细节官方并未在发布页完整披露,第三方说法不宜当作定论。
结语
Grok 4.7不是一次改名式小更新,而是在维持价格与基础速度的前提下,把能力重心推向长周期编码与知识工作,并用Fast通道服务低延迟场景。对开发者,它提供了更便宜的长任务选项;对行业,它继续用高频迭代与价格冻结施压竞品。真正决定其地位的,仍将是第三方复现与真实工作流中的稳定性,而非发布日的单一分数。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com