
一、什么是 LLM 的词汇表?(Vocabulary)
在大型语言模型(LLM)如GPT、LLaMA、Claude等的核心组件中,词汇表(Vocabulary,或称Token Set)是模型处理自然语言的基石。它是模型在训练和推理过程中所有可能token(令牌)的集合,直接决定了模型如何将文本转化为可计算的数字序列。
它定义了:
➡ 模型可以识别与处理的最小语言单元
➡ 每个 token 对应一个唯一的整数 ID
➡ 这些 ID 将在 embedding 表中被查找和训练
在 NLP 系统中,这些 token 并不是自然语言中的“单词”,而是子词级别 (subword) 的编码单元。
例如:
“playing” → “play”, “ing”
📌 将文本映射为这些子词单元,就是 tokenization 的过程。
二、词汇表是怎么构建的?
词汇表不是人工写的“词典”,而是从大量语料自动学习出来的:
1) 字符级(Char)
最基本的方式,每个字符作为一个 token。
优点:覆盖所有语言
缺点:序列太长、效率低下。
2) 子词级(Subword):主流方法
⭐ BPE(Byte Pair Encoding)
- 从字符开始(比如所有 Unicode 字符)
- 在语料中统计出现频率最高的子串组合
- 把高频组合合并为新的 token
- 迭代多次直到达到目标词表大小
- 最终得到「最常用子词」集合
- 用于 GPT 系列和很多 autoregressive 模型。
SentencePiece (Unigram / BPE)
- 类似于 BPE,但采用概率模型或 unigram 方式选择 token
- 可以更自然覆盖多语言
- 被很多开源模型采用(如 LLaMA、Mistral)。
WordPiece
- 主要用于 BERT 系列
- 也是基于统计方式构建 subword token
- 不同于 BPE 的合并规则,WordPiece 采用概率搜索最大互信息。
3) 特殊标记
除了子词,还有一些专用 token,比如:
- <PAD> 填充
- <UNK> 未知 token
- <CLS> / <SEP> 结构分隔
- 这些也计入词汇表大小。
三、现在流行的 LLM 词汇表大小是多少?
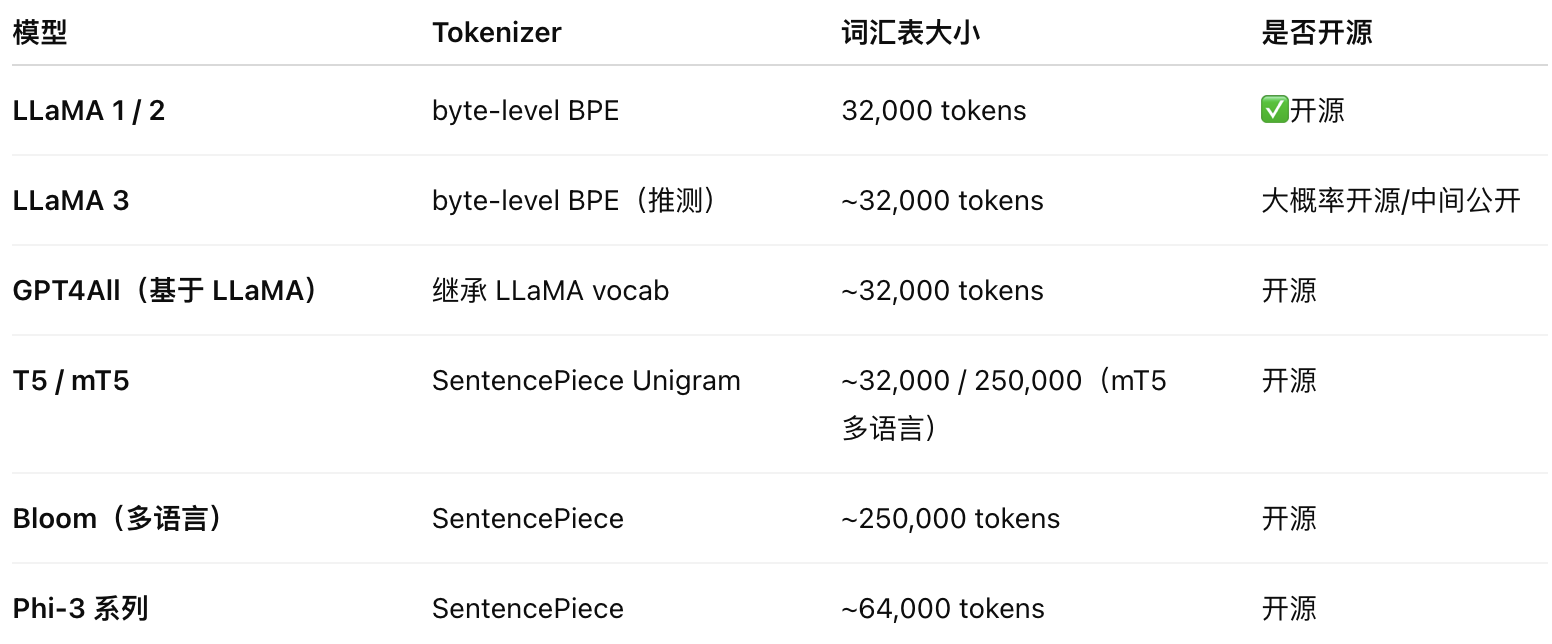
不同模型和 tokenizer 策略的词汇表大小有很大差异,与目标语言、多语言覆盖、token 化策略有关。
以下是较可靠的数字范围和已知信息:
主流开源模型词汇表大小(公开)
商业闭源词表(通常未公开具体数据)
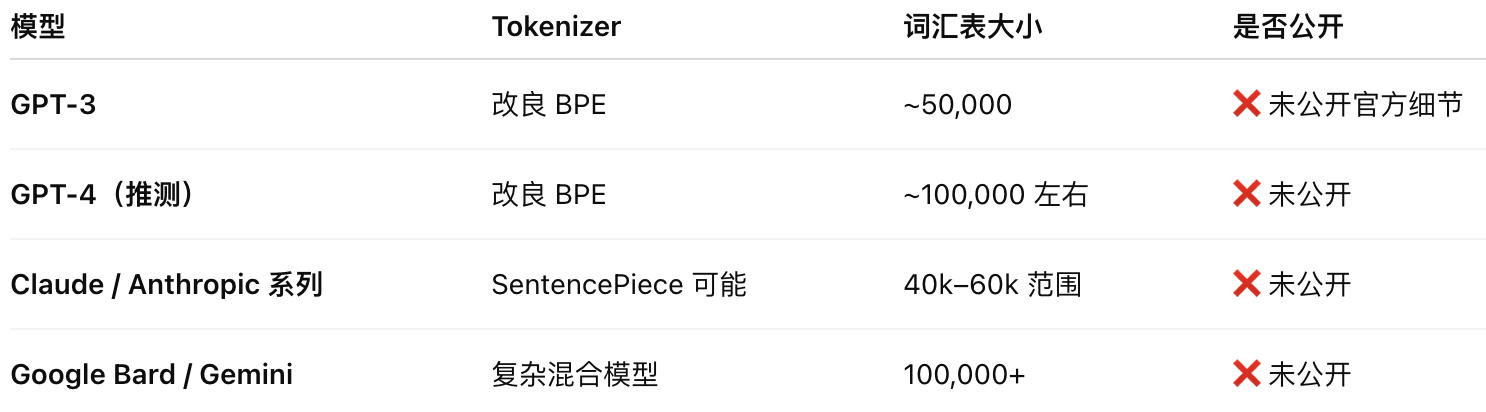
⚠ 这些闭源模型通常不会直接公布词汇表内容或 tokenizer 细节。工程上只能通过推断或社区反推规模。
四、为何不同模型词汇表大小不同?
词汇表大小会影响:
📌 输入序列长度(vocab 小 → 序列更长)
📌 模型参数量(vocab 大 → embedding 参数更多)
📌 多语言覆盖能力(vocab 大更能涵盖各类文字)
因此不同目标下有不同折衷:
- 单语言模型(英语) 词表小一些足够
- 多语言模型 需要更大词表
- 代码/符号丰富任务 也需大词表
这也是为什么 LLaMA 3 扩展到了 ~128k vocab 的原因——更好覆盖中文、特殊符号等。Rohan's Bytes
五、哪些词汇表是已公开且开源的?
✅ 开源词汇表常见来源:
📌 HuggingFace 模型库
几乎所有开源模型的 tokenizer 和 vocab 都能直接下载使用。
👉 例如:
- LLaMA 词汇表
- Bloom 词汇表
- T5 / mT5 词汇表
- Phi 系列词汇表
这些通常是以 vocab.json, merges.txt 或 spm.model 等文件形式提供,可直接用 tokenizer 工具载入。Rahat Ibn Rafiq
六、词汇表有哪些常见文件格式?
格式说明vocab.json + merges.txtBPE(例如 GPT‑2 系列)spm.model / spm.vocabSentencePiece 模型纯 txt 列表单词级或老式词表自定义 bin/jar专有格式
这些文件可以在模型发布包中找到,或在 HuggingFace/Model Zoo 下载。Rahat Ibn Rafiq
七、如何自己训练一个词汇表?
如果你要做自己的 LLM 或定制领域词表(例如法律/医学):
1️⃣ 收集大规模语料
2️⃣ 使用工具训练 tokenizer
SentencePiece(支持 Unigram/BPE)tokenizers库(Rust/C/Python)- 3️⃣ 指定词汇表大小(比如 32k、64k 等)
- 4️⃣ 生成 vocab 文件
- 5️⃣ 用它训练模型或 fine‑tune
这种定制方式在行业应用中特别常见,能显著提升专业词汇识别效率。
八、总结
📌 词汇表是模型理解语言的“基本字典”
📌 通过 BPE / SentencePiece 等算法从大语料自动学习而来
📌 流行开源词表一般在 32k ~ 250k 之间
📌 GPT‑3、GPT‑4、Claude 等闭源模型词表未公开
📌 HuggingFace 和开源社区是获取词汇表最丰富的地方
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com