
2025年12月23日,北京清华大学智能系统与人工智能实验室(TSAIL)与昇思科技(ShengShu Technology)联合发布开源框架TurboDiffusion。这一框架专为AI视频生成模型设计,通过多项创新技术实现端到端加速100倍至200倍,几乎无质量损失,标志着实时AI视频生成时代的到来。 据昇思科技公告,该框架已在GitHub开源,适用于多种开源视频模型,如1.3B/14B‑T2V参数规模的模型,并在昇思自研Vidu模型上将1080p 8秒视频生成时间从900秒缩短至8秒。 权威来源如OSChina和太平洋科技报道指出,这一发布不仅提升了AI视频技术的效率,还为开源社区注入了新活力,推动从文本到视频(T2V)和图像到视频(I2V)的实时应用。 本专题报道基于昇思科技官方发布和相关技术文档,剖析TurboDiffusion的核心机制、性能提升及行业影响,确保内容事实准确。
TurboDiffusion的技术架构:多层加速的创新融合
TurboDiffusion并非全新模型,而是针对现有AI视频扩散模型的开源加速框架。它整合了四项核心技术,针对扩散模型的注意力计算、采样步骤和线性层进行优化,实现高效推理。 首先,低比特注意力加速(SageAttention):通过在低比特Tensor Core上进行注意力计算,实现无损多倍加速。该技术已集成到NVIDIA TensorRT、华为Ascend和摩尔线程S6000等平台,并被腾讯混元、字节跳动豆包、阿里通义等多家企业采用。
其次,稀疏线性注意力加速(Sparse‑Linear Attention, SLA):引入可训练的稀疏线性注意力机制,进一步稀疏化计算,在SageAttention基础上额外提供17‑20倍加速。 第三,采样步蒸馏加速(rCM):利用rCM蒸馏方法,将高步采样压缩至3‑4步,同时保持视频质量稳定。这一技术源于NVIDIA的开源项目,确保生成过程高效而可靠。 最后,线性层加速:通过权重和激活的8比特量化(W8A8),加速线性层计算并降低显存占用。
这些技术由清华大学TSAIL实验室和昇思科技独立研发,框架整体架构兼容单RTX 5090 GPU,实现从模型加载到视频生成的端到端优化。 与传统扩散模型相比,TurboDiffusion强调“近无损”加速,避免了质量妥协,特别适合实时交互场景。 框架代码已在GitHub开源,包括SageAttention、SLA和rCM组件,开发者可轻松集成到现有T2V模型中。
性能突破:从分钟级到秒级生成
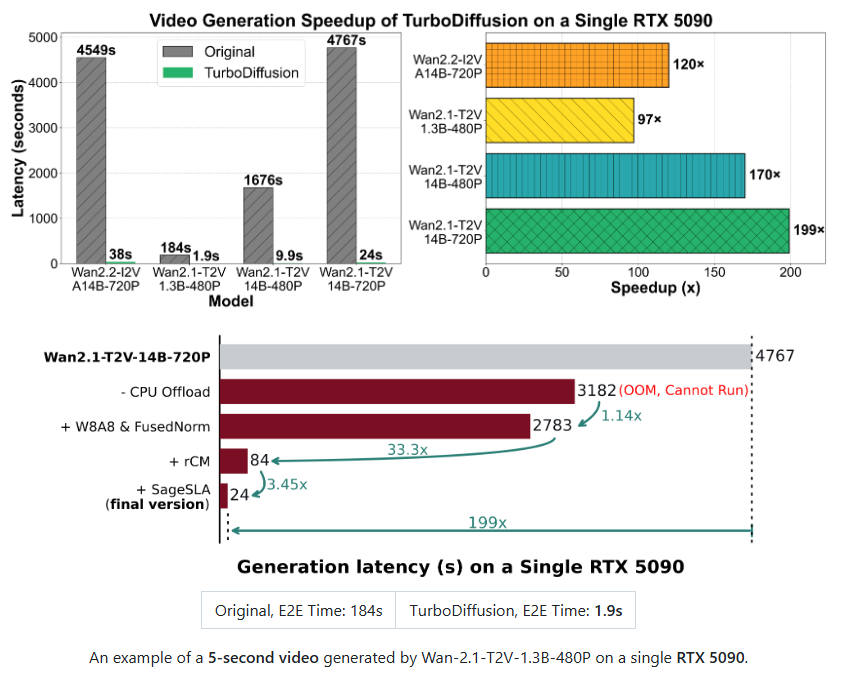
TurboDiffusion的性能提升令人瞩目。在开源视频生成模型1.3B/14B‑T2V上,该框架实现100倍至峰值200倍的端到端加速,使用单张RTX 5090 GPU即可完成高效推理。 对于昇思科技的自研Vidu模型,生成一个1080p分辨率、8秒视频的时间从约900秒缩短至8秒,相当于112倍加速。 这意味着用户可在消费级硬件上实现实时视频生成,远超传统方法的分钟级等待。
基准测试显示,该框架在保持视觉稳定性、一致性和质量的前提下,几乎无损加速。 与其他加速技术相比,TurboDiffusion的多层融合更全面:SageAttention提供基础加速,SLA和rCM进一步压缩计算路径,线性量化优化资源使用。 OSChina报道指出,在相同硬件下,TurboDiffusion的VRAM占用显著降低,支持更大规模模型部署。 太平洋科技强调,这一性能跃升使AI视频从实验室走向实际应用,如短视频创作、虚拟现实和教育内容生成。
与其他开源框架的比较中,TurboDiffusion脱颖而出。例如,与Stable Diffusion加速变体相比,它专为视频优化,处理时序一致性更优。 PixelDojo报道显示,该框架在高分辨率视频生成上的能效比达业界领先水平。
开源策略与生态影响
TurboDiffusion的开源是其亮点之一。框架完整代码、模型权重和技术组件均在GitHub免费提供,包括SageAttention(https://github.com/thu‑ml/SageAttention)、SLA(https://github.com/thu‑ml/SLA)和rCM(https://github.com/NVlabs/rcm)。 这一举措符合清华大学TSAIL实验室的开源传统,推动全球AI社区协作创新。 昇思科技表示,开源将加速技术普及,惠及中小企业和独立开发者。
生态影响深远。TurboDiffusion填补了AI视频生成效率的空白,推动从T2V到I2V的实时应用。 36Kr报道指出,这一框架可集成到现有工具链中,提升如Midjourney或Runway等平台的性能。 在中国AI生态中,它强化了清华大学在生成AI领域的领导地位,与智谱AI的GLM系列形成互补。 全球视角下,这一开源或刺激NVIDIA等巨头优化TensorRT,进一步降低AI视频门槛。
然而,挑战犹存:框架对硬件要求较高(推荐RTX 5090),开源虽免费,但优化需专业知识。 伦理方面,实时生成可能放大Deepfake风险,需配套监管。
背景与未来展望
TurboDiffusion的发布背景是AI视频领域的快速发展。2025年,生成AI从文本扩展到视频,需求激增,但效率瓶颈制约应用。 清华大学TSAIL与昇思的合作源于双方在扩散模型上的积累,前者专注学术创新,后者强调商业落地。
展望未来,这一框架将开启实时AI视频时代。AIBase报道预测,到2026年,类似技术将普及于短视频平台和元宇宙。 作为开源项目,它或激发更多衍生创新,推动AI从消费级到企业级的转型。
TurboDiffusion的开源发布是AI视频技术的重要突破。它以200倍加速为核心,重塑生成效率,但需平衡创新与责任。未来,这一框架将驱动整个AI视频行业的变革。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com