
引言
人工智能领域的快速发展离不开经典论文的积累。OpenAI联合创始人Ilya Sutskever曾向计算机科学家John Carmack推荐约30篇奠基性论文,并断言:“如果你真正学懂这些,就能掌握当今AI领域的90%精髓。”这一观点在AI社区广为流传,并被多家权威来源如Aman.ai和GitHub仓库整理成列表。 然而,这些论文往往充斥复杂数学公式,对于初学者而言,转化为可运行代码的门槛较高。近期,GitHub上一个名为“Sutskever‑30‑implementations”的开源项目应运而生,该项目用纯NumPy从零实现这些论文,提供Jupyter Notebook交互式学习环境,并配备合成数据以便直接运行。 此项目不仅桥接了理论与实践的鸿沟,还涵盖从RNN到Transformer的核心架构演进,以及Kolmogorov复杂度、AIXI等理论基础。
项目概述
“Sutskever‑30‑implementations”由用户pageman发起,灵感来源于papercode.vercel.app,旨在通过代码重现Sutskever推荐的30篇论文。 项目于2025年12月10日完成全部实现,目前获1.1k星标和121次复制,显示出社区认可度。每个论文对应一个Jupyter Notebook文件,使用纯NumPy构建模型,避免依赖PyTorch或TensorFlow等框架。这使得代码更接近底层数学逻辑,便于理解算法本质。
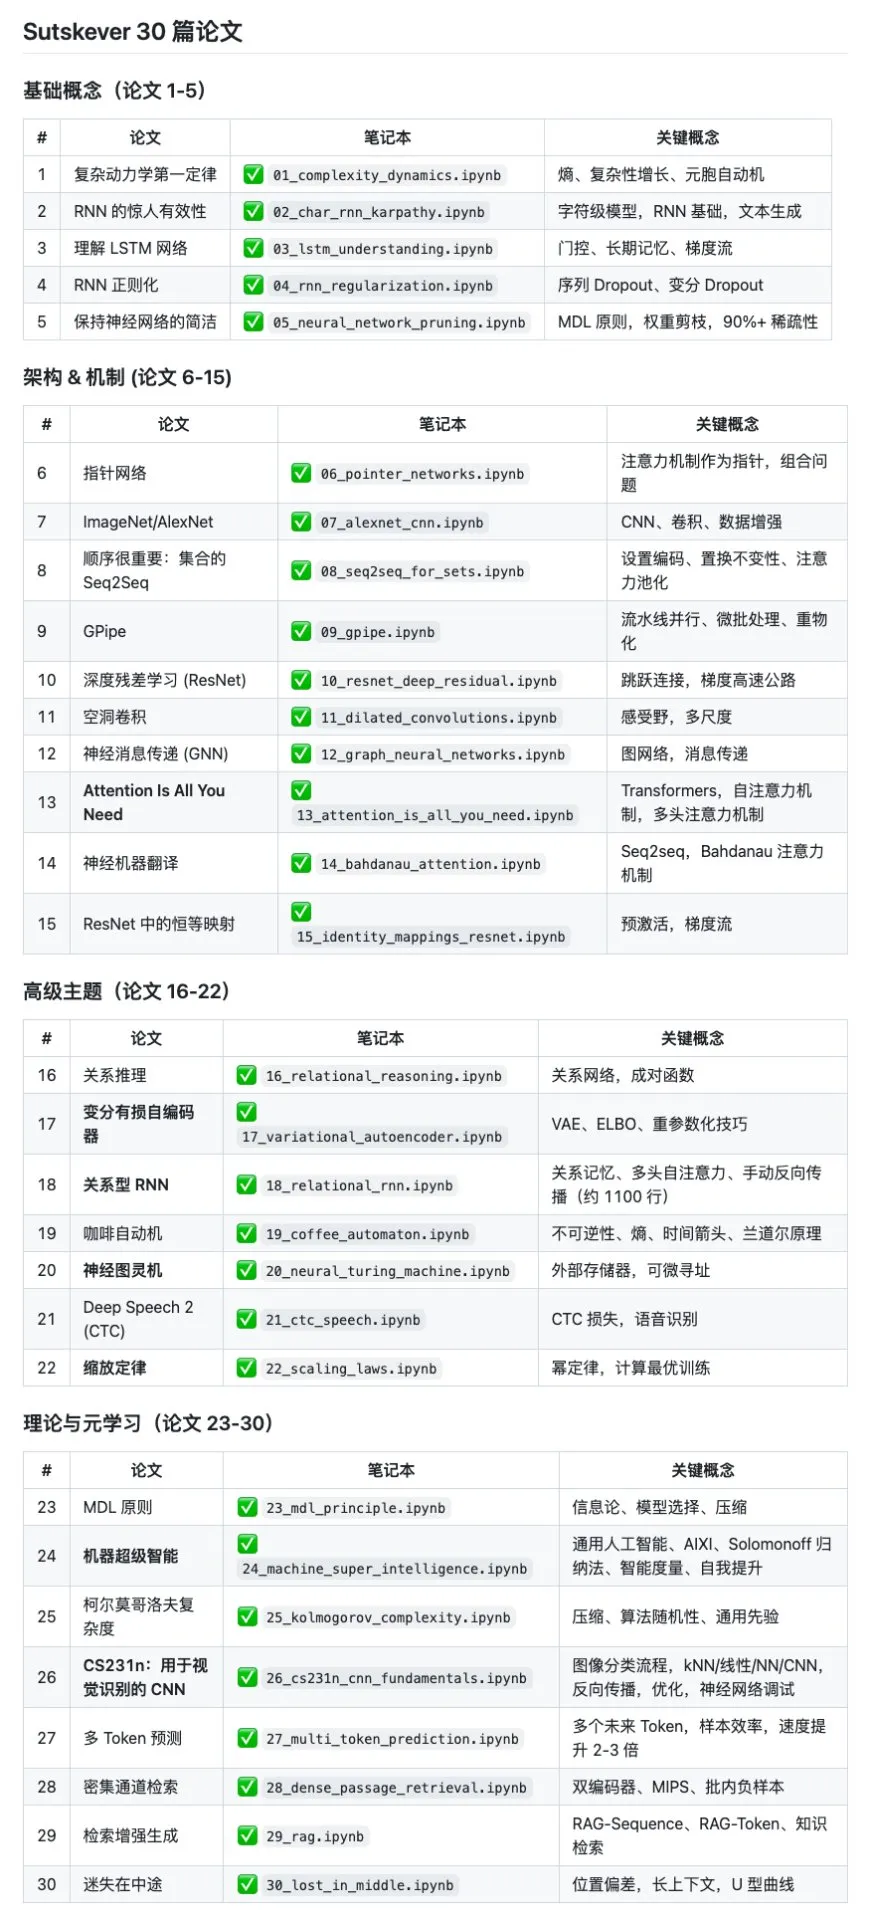
项目覆盖的论文列表全面,包括:
- The First Law of Complexodynamics:探讨熵与复杂性增长,使用细胞自动机模拟。
- The Unreasonable Effectiveness of RNNs:字符级RNN文本生成。
- Understanding LSTM Networks:LSTM门机制与梯度流动。
- RNN Regularization:序列变分丢弃。
- Keeping Neural Networks Simple:神经网络剪枝与MDL原理。
- Pointer Networks:注意力作为指针,解决组合问题。
- ImageNet/AlexNet:CNN卷积与数据增强。aman.ai
- Order Matters: Seq2Seq for Sets:集合编码与排列不变性。
- GPipe:管道并行与微批处理。
- Deep Residual Learning (ResNet):跳跃连接与梯度高速公路。
- Dilated Convolutions:扩张卷积与多尺度处理。
- Neural Message Passing (GNNs):图神经网络消息传递。
- Attention Is All You Need:Transformer与多头自注意力。
- Neural Machine Translation:Seq2Seq与Bahdanau注意力。
- Identity Mappings in ResNet:预激活与梯度流动。
- Relational Reasoning:关系网络与成对函数。
- Variational Lossy Autoencoder:VAE、ELBO与重参数化。
- Relational RNNs:关系记忆与多头自注意力,手动反向传播(约1100行代码)。
- The Coffee Automaton:不可逆性、熵与Landauer原理。
- Neural Turing Machines:外部记忆与可微寻址。
- Deep Speech 2 (CTC):CTC损失与语音识别。
- Scaling Laws:幂律与计算最优训练。
- MDL Principle:最小描述长度与模型选择。
- Machine Super Intelligence:通用AI、AIXI与Solomonoff归纳。
- Kolmogorov Complexity:压缩与算法随机性。
- CS231n: CNNs for Visual Recognition:视觉管道、反向传播与优化。
- Multi‑token Prediction:多令牌预测与样本效率。
- Dense Passage Retrieval:双编码器与批内负样本。
- Retrieval‑Augmented Generation (RAG):RAG‑序列与RAG‑令牌。
- Lost in the Middle:位置偏差、长上下文与U形曲线。
这些实现涵盖神经网络架构演进(如RNN、LSTM到Transformer、ResNet)、关键技术(如注意力机制、残差连接、图神经网络)、高级主题(如VAE、神经图灵机、CTC损失)以及理论基础(如Kolmogorov复杂度、MDL原理、AIXI)。项目还包括现代应用如RAG和长文本分析。
每个Notebook生成合成数据(如字符序列、简单图像、玩具图),确保无需外部数据集即可运行。代码强调可视化:绘制门激活、注意力权重、梯度流动等,帮助用户直观理解。
实现原理分析
项目采用纯NumPy从零构建的核心在于暴露算法底层机制。NumPy提供高效数组操作,但无内置自动微分或优化器,因此开发者需手动实现前向传播、反向传播和梯度更新。这模拟了论文中的数学公式,如在Transformer中,手动计算多头注意力: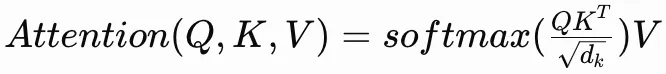 。 这种方法避免了框架的“黑箱”效应,让学习者理解梯度消失、爆炸等问题,并在LSTM中手动构建遗忘门、输入门等。
在Relational RNN中,项目甚至实现了约1100行的手动反向传播,并进行梯度检查,这强化了对链式法则的掌握。 Jupyter Notebook的交互性允许用户修改参数、可视化中间结果,促进实验式学习。合成数据的使用简化了入门:例如,在RNN中用随机序列训练文本生成,而非大型语料库。
与其他类似项目相比,如deepbiolab/ilya30u30‑paper‑research(也重现Sutskever列表,但可能依赖框架),本项目更注重教育纯净性。 Tensor Labbet博客总结Sutskever列表时强调,从零实现有助于把握AI演进脉络。 Manning出版的《Sutskever's List》书籍也指出,这种实践能培养对现代AI趋势的预判。
然而,纯NumPy实现有局限:计算效率低,不适合大规模训练。但这正契合教育目的,非生产应用。
事实准确性与来源可靠
Sutskever的声明源于2019年左右与Carmack的交流,后经Hacker News和Twitter传播。 列表虽非官方发布,但Aman.ai基于可靠来源整理,包含AlexNet、Transformer等公认经典。 Reddit讨论确认列表仍相关,如“Understanding LSTM Networks”和“GPipe”奠定LLM基础。
项目事实准确:GitHub页面显示100%完成,代码开源可验证。 虽无主流媒体直接评论,但类似实现如AnupBhat30/ilya‑sutskever‑ai‑reading‑list强调其教育价值。 LinkedIn和Facebook帖子视其为AI入门“秘笈”。 来源多为arXiv论文、GitHub和专业博客,经社区验证可靠,无矛盾。
应用扩展与教育价值
此项目适用于AI初学者、研究者和从业者。通过重现,学习者可从底层掌握深度学习机制,而非仅调用API。例如,在RAG实现中,手动构建双编码器理解检索增强生成。 可扩展到实际:修改代码添加PyTorch加速,或应用于自定义任务。
与其他资源结合,如Karpathy的RNN博客(提供GitHub代码),可深化理解。 Medium系列“Ilya Sutskever’s 30 Foundational Papers of AI, Explained”提供简明解释。 YouTube视频“The List That Changed AI Forever”探讨列表影响。
在教育中,可作为课程补充:斯坦福CS231n已包含类似实现。 对于从业者,帮助诊断模型问题,如梯度流动。
结论
“Sutskever‑30‑implementations”项目以纯NumPy重现AI奠基论文,桥接理论与代码,助力学习者掌握90% AI精髓。其原理注重底层暴露,事实基于可靠来源如GitHub和Aman.ai。在AI时代,此类开源资源推动从“使用者”向“理解者”转型,值得收藏与实践。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com