
在2026年, AI Agent成为LLM应用的主流,各种Agent和Skill技能库不断涌现,为实现LLM的应用普及打下了良好的基础。与此同时,不同技能的数据累计会大量消耗Token的使用量,造成巨大的浪费。为解决这一痛点问题,2026年5月,中国香港中文大学与佛罗里达大学研究团队在arXiv上发布论文《Dynamic Skill Lifecycle Management for Agentic Reinforcement Learning》,提出了一种名为SLIM(Skill Lifecycle Management)的动态技能生命周期管理框架。该框架针对当前Agentic Reinforcement Learning(代理式强化学习)中外部技能管理存在的局限性,首次将活跃技能集合作为与策略学习联合优化的动态变量,实现了技能的智能保留、退役与扩展。这一工作在ALFWorld和SearchQA等复杂任务环境中平均超越现有最佳基线7.1个百分点,为构建更高效、更可持续的AI智能体提供了重要技术路径。
研究起因:现有技能管理范式的局限
随着大型语言模型(LLM)驱动的Agent越来越依赖外部技能(external skills)来完成复杂任务,现有方法主要面临两大核心问题:
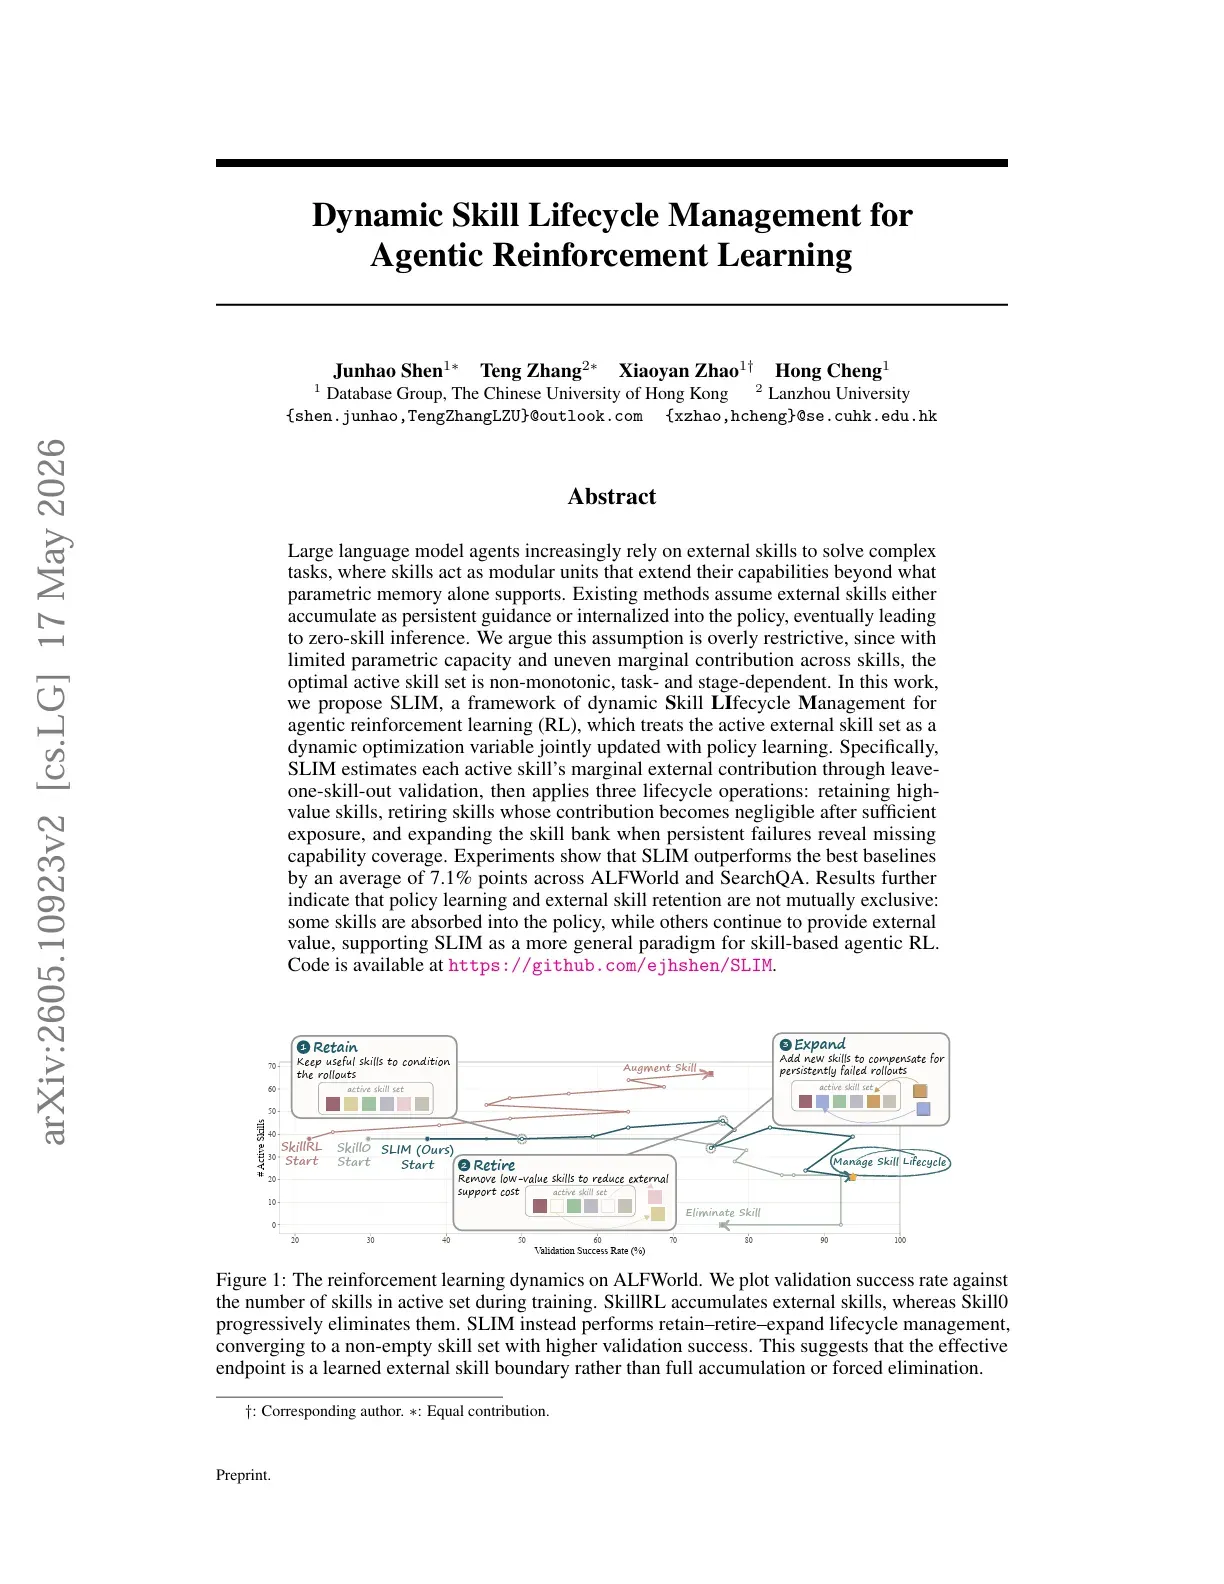
第一种是持续积累范式(如SkillRL):外部技能只增不减,导致上下文过长、路由噪声增加,最终性能下降。 第二种是逐步内化范式(如Skill0):技能逐渐被策略吸收,最终实现零技能推理,但忽略了部分技能在特定阶段仍具有高外部价值。
研究团队指出,这两种假设都过于绝对化。在参数容量有限、技能边际贡献不均的情况下,最优活跃技能集合应该是非单调的、任务依赖和阶段依赖的。现有方法难以动态平衡“内化”与“外部调用”,导致Agent在长期任务中出现效率低下或能力退化的问题。
SLIM框架正是为了解决这一核心矛盾而提出。它不再将技能集合视为静态或单向演化,而是将其视为与策略学习联合优化的动态变量。
SLIM框架核心原理
SLIM的核心创新在于引入技能生命周期管理机制,主要包含以下三个关键操作:
- 边际外部贡献评估(Marginal External Contribution) SLIM采用Leave‑One‑Skill‑Out(LOSO)验证方法:定期移除单个技能,观察策略性能变化,从而量化该技能的边际外部价值。这一机制能准确判断哪些技能仍值得保留,哪些已可被策略内化。
- 三类生命周期操作:
- Retain(保留):对高价值技能持续保留外部调用。
- Retire(退役):当技能贡献低于阈值且暴露次数足够多时,逐步退役,减少上下文噪声。
- Expand(扩展):当Agent持续失败时,主动扩展技能库,引入新能力覆盖缺失场景。
- 与策略学习的联合优化 SLIM将技能生命周期决策与强化学习(GRPO等)过程紧密耦合,通过周期性审计(lifecycle audit)实现动态平衡。实验中使用Qwen3‑4B作为骨干策略模型,在ALFWorld和SearchQA任务上进行了充分验证。
这一框架的核心思想是:技能管理不应是静态的规则,而应是与策略共同进化的动态过程。
实验结果与对比分析
研究团队在ALFWorld(家庭环境多任务)和SearchQA(复杂搜索问答)两个代表性基准上进行了全面实验:
- ALFWorld:SLIM相比最佳基线提升约7.8个百分点。
- SearchQA:SLIM相比最佳基线提升约6.4个百分点。
- 平均提升:7.1个百分点。
更重要的是,实验结果表明策略学习与外部技能保留并不互斥:部分技能被成功内化到策略中,而另一部分高价值技能则长期保持外部调用。这一发现挑战了传统“要么全内化、要么全外部”的二元思维,为Agentic RL提供了更灵活的范式。
与SkillRL(持续积累)和Skill0(逐步内化)等基线相比,SLIM在长期任务稳定性、计算效率和最终性能上均表现出显著优势,尤其在复杂、多步、需要长期记忆的任务中优势明显。
研究意义与未来展望
SLIM框架的提出具有多重重要意义:
- 为Agentic RL提供了一种动态、可解释的技能管理新范式;
- 有效缓解了长上下文带来的计算开销和噪声问题;
- 为未来更复杂的多代理协作系统奠定了技术基础。
研究团队已在GitHub上开源了SLIM的实现代码,为社区进一步探索提供了便利。未来方向包括:将SLIM扩展到多代理场景、结合更大规模的骨干模型、以及探索更高效的边际贡献评估方法。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com