
在人工智能迅猛发展的2025年,强化学习(Reinforcement Learning, RL)已成为提升大型语言模型(Large Language Models, LLMs)推理能力的“杀手锏”,基于强化学习的思维链(Chain‑of‑Think, CoT)广泛应用于各大推力模型之中。为此,清华大学与上海人工智能实验室联合发布的117页(正文部分68页)综述论文《A Survey of Reinforcement Learning for Large Reasoning Models》(arXiv:2509.08827)系统剖析了RL如何将LLMs转型为大型推理模型(Large Reasoning Models, LRMs),在数学、编程、代理任务等领域实现突破。该论文由Kaiyan Zhang等39位作者执笔,发表于2025年10月10日,聚焦RL的核心组件、训练资源、应用场景及挑战,标志着RL从对齐工具向推理引擎的跃升。本文基于该综述,提供深度技术解读,剖析RL的数学基础、创新机制与未来潜力。
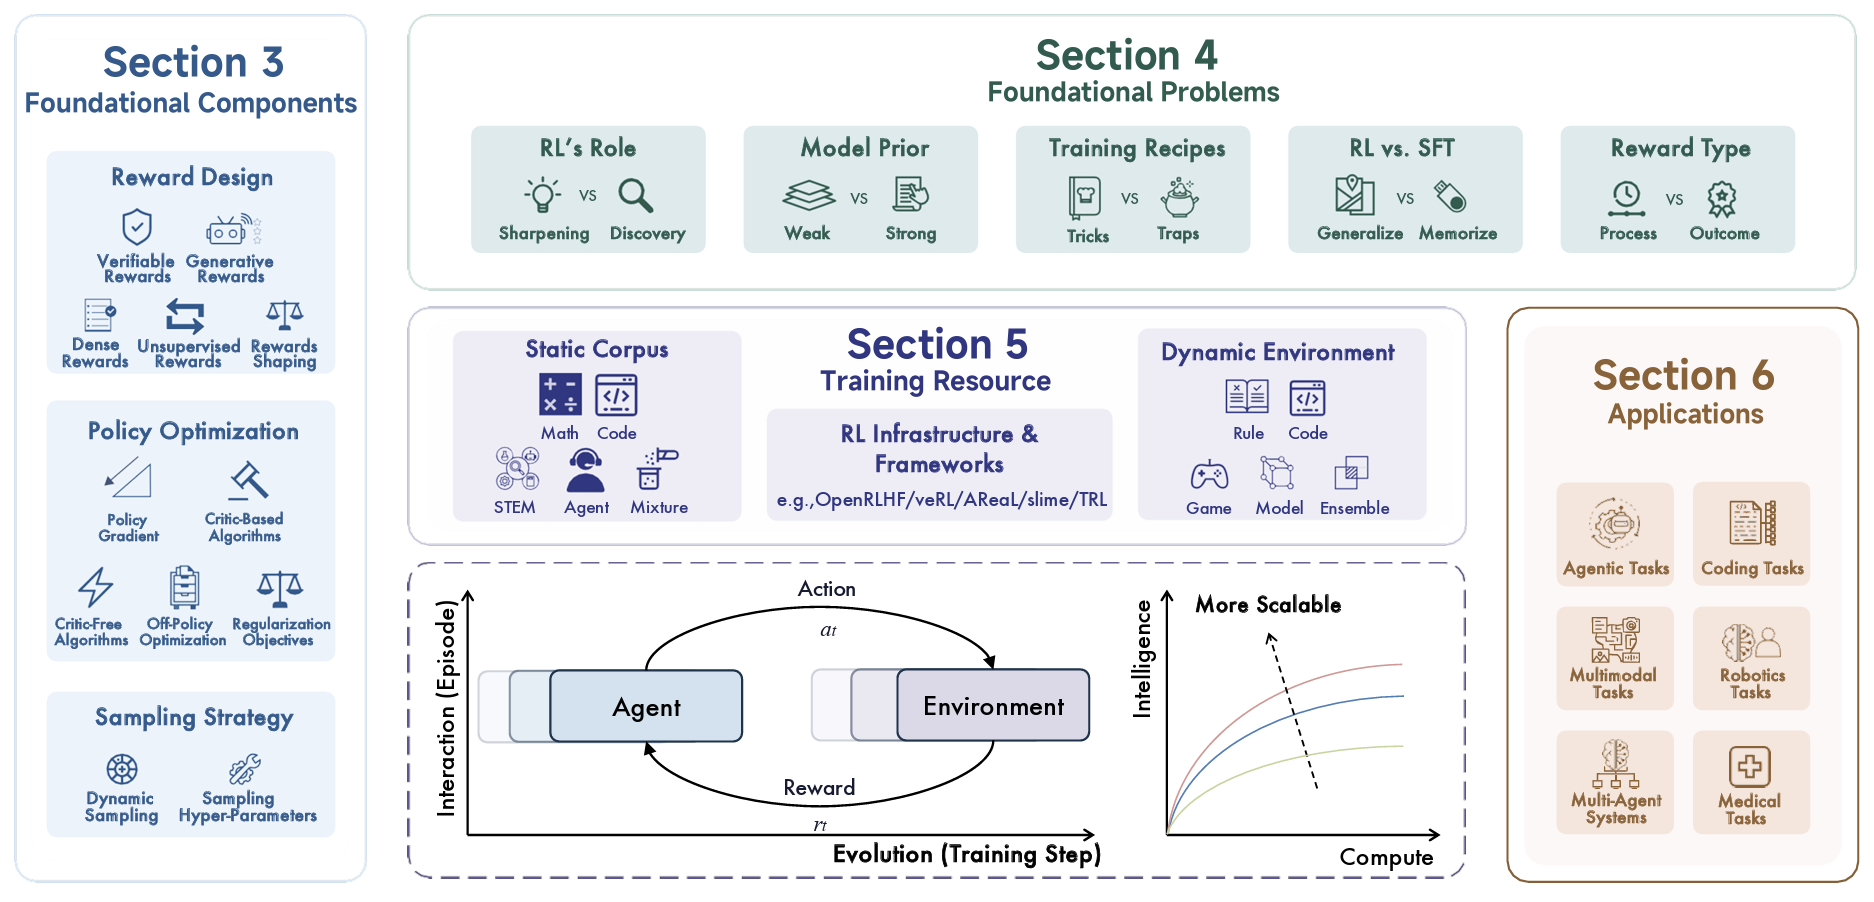
图 | 综述概览 论文介绍了用于大型推理模型(LRMs)的强化学习(RL)的基础组件,以及开放性问题、训练资源和应用场景。本综述的核心聚焦于语言智能体与环境在长期演化过程中的大规模交互。
引言:从LLMs到LRMs的范式转变
传统LLMs如GPT‑4虽在自然语言生成上卓越,但面对复杂推理任务(如多步数学证明或代码调试)往往“卡壳”,依赖静态监督微调(Supervised Fine‑Tuning, SFT)难以捕捉动态决策路径。RL的介入改变了这一格局:通过马尔可夫决策过程(MDP)框架,RL将LLM视为智能体,提示作为初始状态,生成序列作为动作,环境反馈奖励信号,实现策略优化。
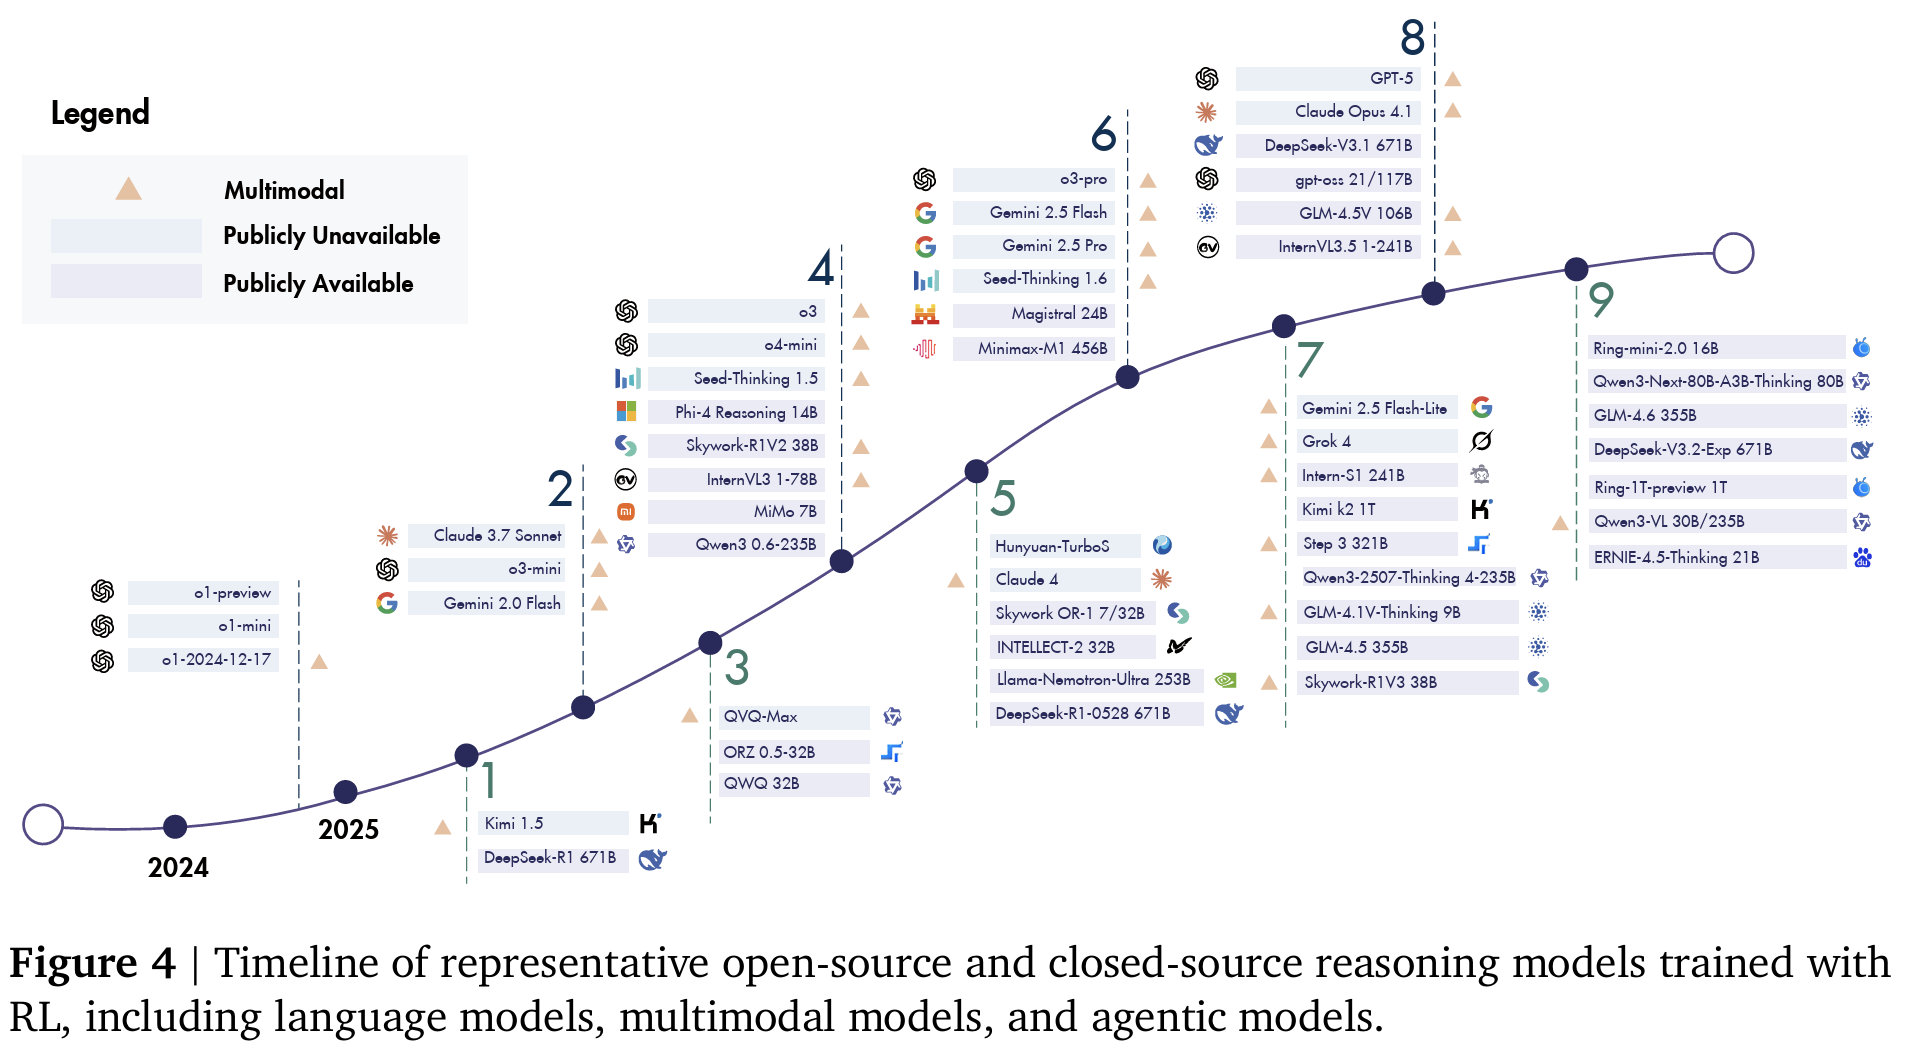
论文强调,RL驱动的里程碑模型如OpenAI o1(闭源,RLVR+推理时计算扩展,在数学推理上SOTA)、DeepSeek‑R1(开源,GRPO+可验证奖励,媲美o1的编程能力)、Claude‑3.7‑Sonnet(多模态RL,擅长工具调用)、Gemini 2.0(动态采样,视觉推理领先)和Qwen3(RL+SFT融合,多任务泛化强),证明RL能激发“长链推理”(Long Chain‑of‑Thought, Long CoT)和自我纠正机制。相较RLHF(Reinforcement Learning from Human Feedback)仅优化“说话方式”,RLVR(Verifiable Rewards)直接针对推理正确性,提供更可靠的梯度信号。
然而,RL并非万能:训练不稳定性、奖励黑客(reward hacking)和计算开销是痛点。论文通过对比RL与SFT/DPO(Direct Preference Optimization),指出RL在分布外泛化上胜出,但需混合策略以平衡效率。该综述填补了现有文献空白,系统梳理RL向通用人工智能(Artificial Superintelligence, ASI)贡献。
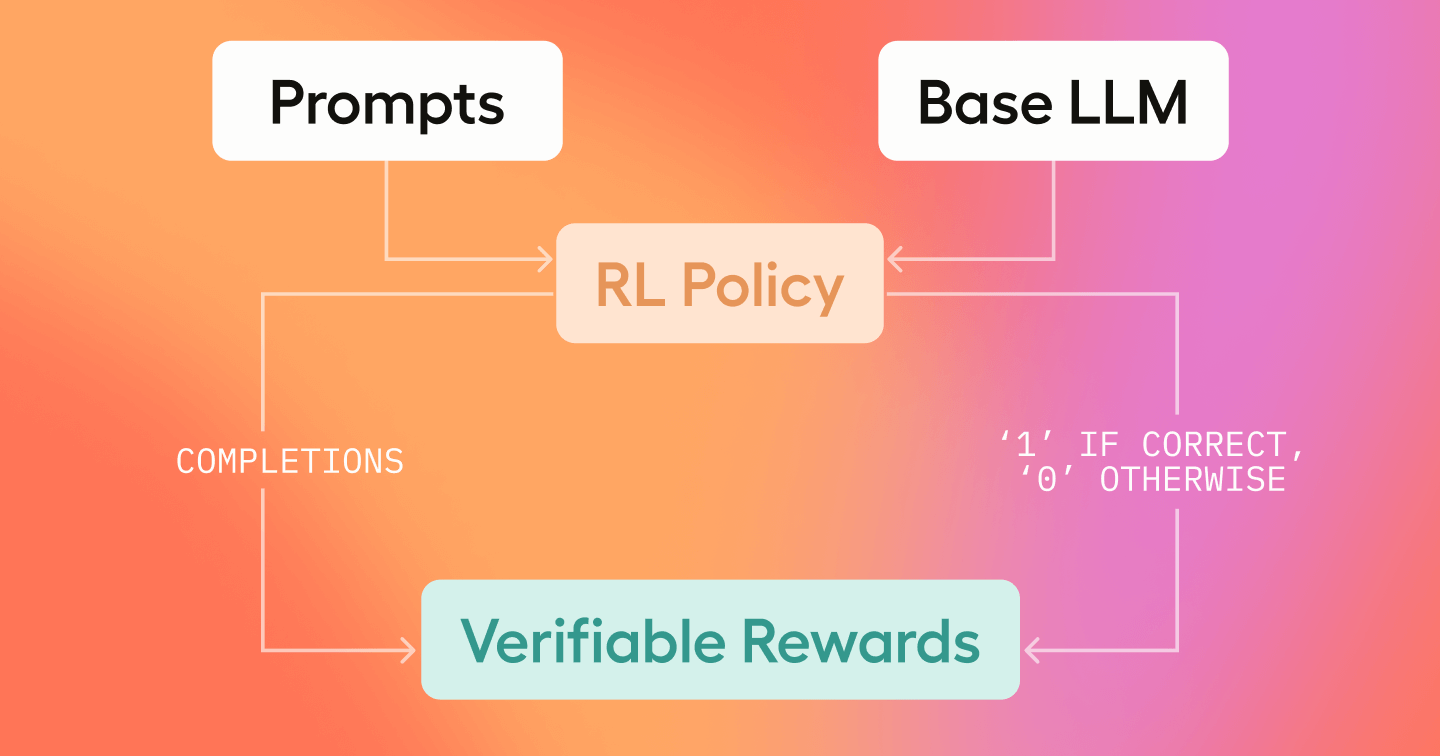
Reinforcement Learning from Verifiable Rewards | Label Studio
预备知识:RL在LRMs中的数学框架
RL的核心是MDP元组(S, A, P, R, γ),其中S为状态空间(提示+生成序列)、A为动作空间(下一个令牌)、P为转移动态(LLM生成概率)、R为奖励函数(正确性分数)、γ为折扣因子(0<γ<1,平衡短期/长期奖励)。在LRMs中,LLM策略π(θ)通过策略梯度最大化期望回报J(θ)=E[∑γ^t r_t],梯度∇J(θ)≈E[∇logπ(a|s) A(s,a)],其中A为优势函数。
论文回顾前沿模型时间线:从RLHF(2022年InstructGPT)到RLVR(2025年o1),开源如DeepSeek‑R1采用弱先验(从头学习CoT),闭源如Claude强调强先验(预训练知识注入)。与SFT的静态标签不同,RL动态生成数据,解决“数据饥饿”问题。但RL需高计算资源:o1训练耗费数万H100 GPU小时。
基础组件:奖励设计、策略优化与采样策略
奖励设计:RL的“指南针”
奖励函数R决定了优化方向,论文分类五类:可验证奖励(规则检查,如DeepSeek‑R1的数学求解器,r=1若正确否则0,可靠但主观任务弱);生成奖励(模型反馈,如Rubric‑based,成本高但灵活);密集奖励(步级反馈,如PRM令牌级熵,缓解信用分配);无监督奖励(内部一致性,如ZeroGUI);奖励整形(稀疏转密集,如Pass@k优化)。
创新点在于混合机制:DeepSeek‑R1融合规则+人类偏好,减少黑客风险。数学上,奖励整形用基线b(s)规范化A(s,a)=r+γV(s')‑b(s),稳定梯度。
Reinforcement Learning from Verifiable Rewards | Label Studio
策略优化:从PPO到GRPO的演进
策略优化是强化学习驱动大型推理模型(LRMs)的核心,目标为最大化期望累积奖励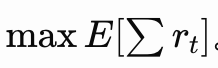 。PPO(Proximal Policy Optimization)通过裁剪比率
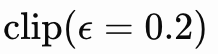 策略更新幅度,防止破坏性大步,确保训练稳定,但计算密集。REINFORCE 作为基础蒙特卡洛梯度,易受高方差困扰。VCPPO 引入价值评论器提供基线,显著降噪。
无评论器算法中,GRPO(Group Relative Policy Optimization)通过组内相对排名构造优势函数,大幅降低方差,适合资源受限场景。CISPO/GSPO 融入对比学习思想,以 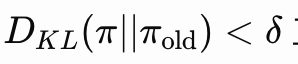 正则化,兼顾探索与保守更新。
论文对比显示:PPO虽稳定但需频繁价值评估;GRPO高效且无需额外网络;离策略方法如 PPER(Prioritized Experience Replay)优先回放高TD误差样本,提升效率。离策略更新公式为 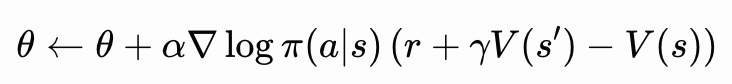 ,结合DQN处理离散动作空间,适用于工具选择等结构化任务。
采样策略:动态探索的艺术
采样策略是强化学习驱动大型推理模型(LRMs)的关键,决定探索‑利用权衡。PRIME 实现动态温度自适应(τ ∝ 奖励),高奖励轨迹降低随机性以强化利用,低奖励时提升温度鼓励探索。TreeRL 采用树状搜索结构,共享公共前缀大幅减少冗余计算,提升长链推理效率。DeepScaleR 通过元学习优化CoT深度超参数,平衡计算与性能。论文特别指出,ARPO(Adaptive Rejection Sampling) 结合拒绝采样与自适应阈值,显著鼓励工具调用(如代码执行器、计算器),在长序列任务中提升生成质量与效率,避免无效探索,适用于数学求解与多步代理场景。
基础问题:七大争议的辩证剖析
论文独辟蹊径,深入探讨强化学习(RL)驱动大型推理模型(LRMs)的七大哲学争议,揭示其方法论本质与实践张力:
- “磨练”还是“发现”?DeepSeek‑R1通过弱先验从头训练,展现“发现”新推理路径的能力,如隐式CoT(无需显式提示即可链式推理);而OpenAI o1依赖强监督与推理时计算,偏向“磨练”已知策略的高效执行。
- RL vs SFT:RL在分布外泛化上更强,能探索未见任务空间;监督微调(SFT)则记忆高效,适合知识密集型任务。**UFT(Unified Fine‑Tuning)**提出融合范式,先SFT注入知识,再RL激发推理。
- 模型先验强度:弱先验(如R1)激发创新,易生成非传统解法;强先验(如Claude)确保稳定性,减少幻觉。
- 训练配方:KL散度正则、价值裁剪等技巧提升收敛,但熵崩溃、模式崩溃等陷阱需警惕。
- 奖励粒度:过程监督(密集奖励)引导中间步骤,结果验证(可验证奖励)确保终局正确,混合奖励兼顾探索与精度。
6–7. 多模态与代理扩展:RL赋能视觉‑语言推理与工具调用,但放大偏见、伦理风险需透明审计与对齐机制。
这些争议凸显RL的双刃剑本质:潜力驱动突破,风险要求标准化训练协议与伦理框架。未来需建立统一基准、开放可复现流水线,方能安全迈向通用推理智能。
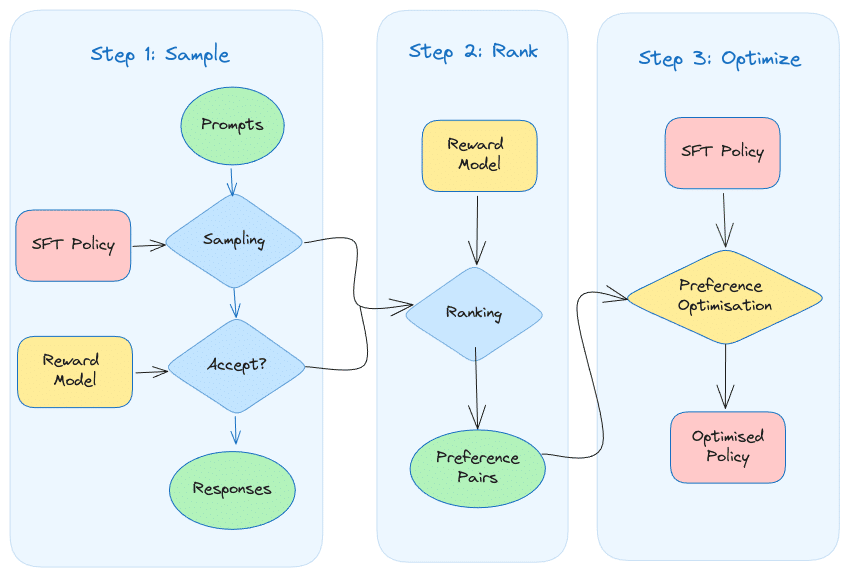
A Deep Dive into Policy Optimization Algorithms & Frameworks for ...
训练资源:从静态数据到动态环境
强化学习驱动大型推理模型(LRMs)依赖丰富训练资源,分为静态语料与动态环境两大类。
静态语料包括:Big‑Math(10,000道数学推理题)、HumanEval(164个编程任务)、MedXpertQA(医疗诊断问答)等,提供高质量监督信号。
动态环境则支持实时交互反馈,分类为:规则基(如SymPy数学求解器)、代码基(在线编译执行单元测试)、游戏基(Minecraft构建与导航任务)、模型基(GUI模拟器驱动视觉‑语言交互)。论文表4对比显示,SWE‑bench 包含超2,000个真实GitHub仓库,覆盖复杂软件工程场景。
RL基础设施显著降低训练门槛:OpenRLHF 支持异步策略‑价值更新;TRL 集成工具调用与拒绝采样;veRL 实现可中断长序列生成;AReaL 扩展至多模态RL。这些开源框架加速社区创新,推动从实验室原型向工业级LRMs的快速迭代。
应用场景:RL的多维落地
编码与代理任务
在编码,Claude‑4.1‑Opus用单元测试奖励优化SWE‑bench,准确率超40%;R1‑Code‑Interpreter融合监督+RL,提升调试。代理任务中,Kimi K2多轮交互,UI‑TARS GUI grounding(IoU奖励)达85%精度。
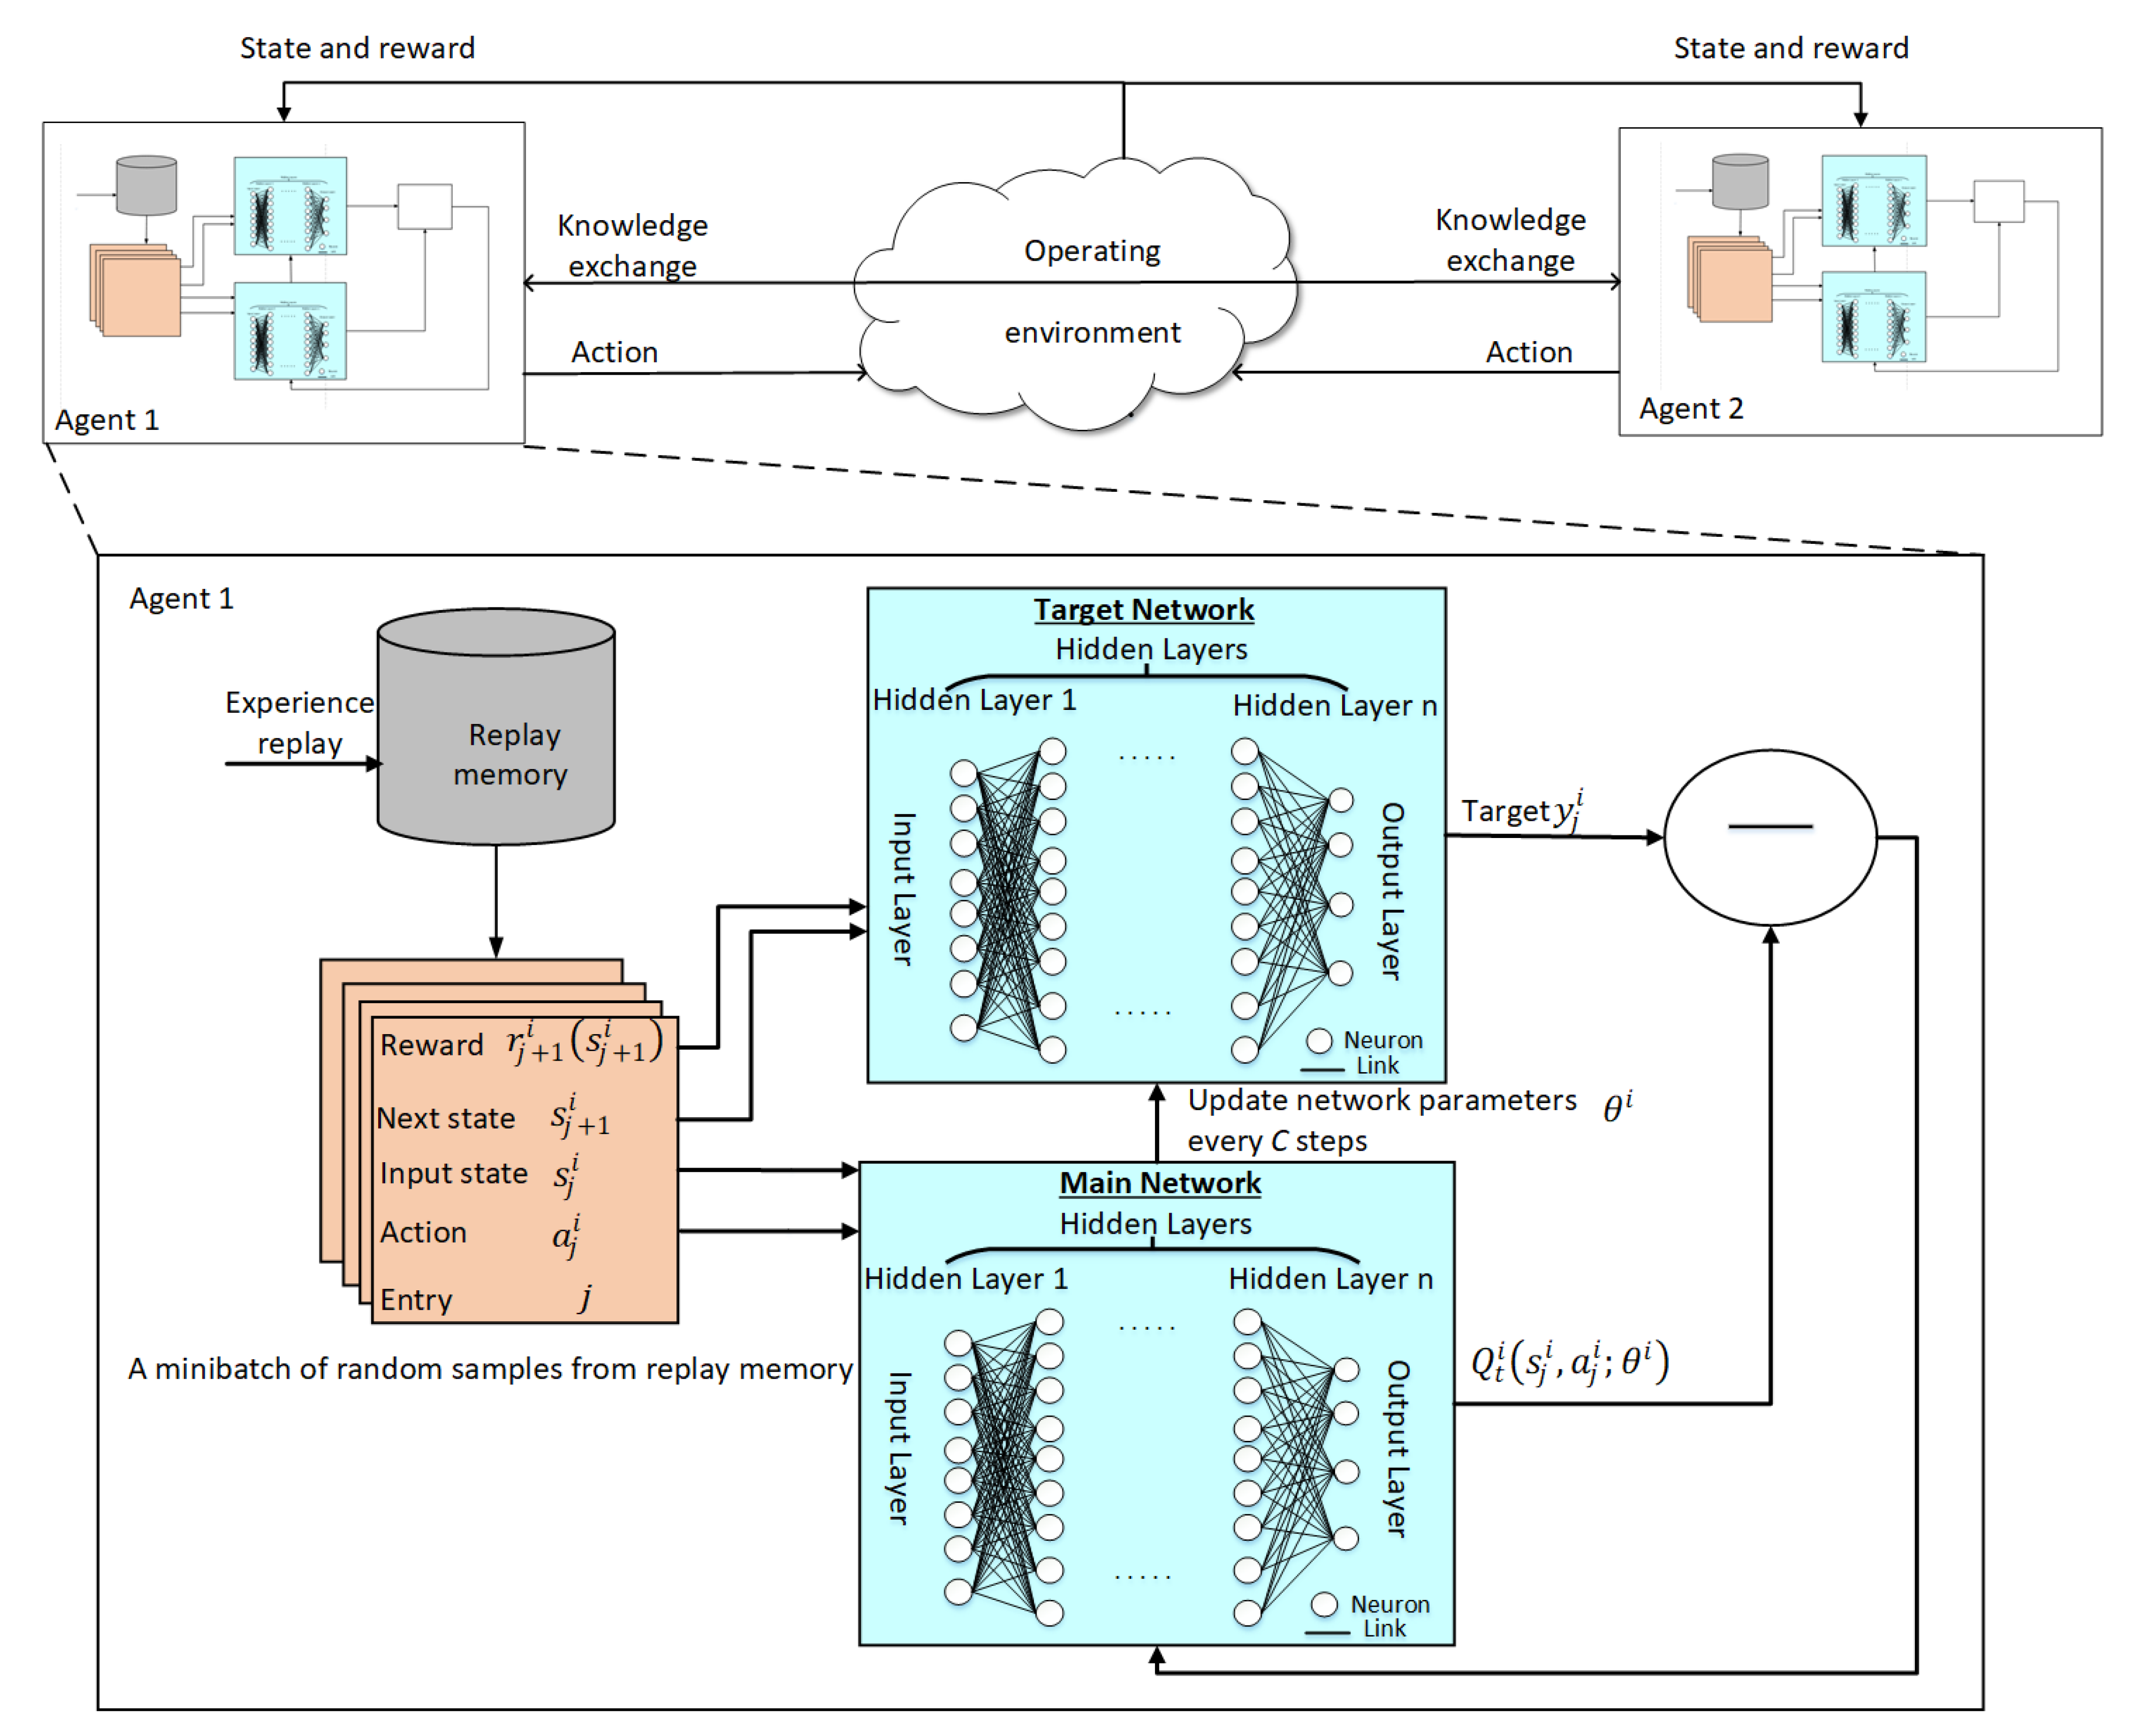
Applications of Multi‑Agent Deep Reinforcement Learning ...
多模态、机器人与医疗
强化学习在大型推理模型(LRMs)中的应用扩展至多模态、机器人与医疗领域,展现跨界潜力。
- 多模态:InternVL3.5通过Cascade RL框架(离线+在线阶段)领先视觉推理,提升MMMU等任务16%性能,支持GUI交互;Video‑R1引入T‑GRPO算法,强化时序CoT,融合图像‑视频数据,在VSI‑Bench达35.8%准确率,超越GPT‑4o。
- 机器人:SimpleVLA‑RL采用GRPO优化动作模型,解决数据稀缺,通过二元成功奖励与探索调制,提升长时序规划与仿真‑现实转移,在LIBERO基准泛化超SFT。
- 医疗:Med‑U1利用混合规则奖励(二元+长度罚项),诊断准确率升20%;BoxMed‑RL强调格式奖励,确保报告结构化输出,提升临床一致性。
多代理如LLaMAC借actor‑critic框架协作推理,优化大规模决策;MARTI支持自然语言反馈的多代理RL训练,强化团队决策效率,推动集体智能演进。
挑战与未来方向:从瓶颈到突破
大型推理模型(LRMs)在强化学习驱动下虽展现出强大潜力,但仍面临五大核心挑战:
- 1. 训练不稳定,易陷入熵崩溃(entropy collapse),导致策略过早收敛至低多样性输出,可通过熵正则化 H(π)>β H(\pi) > \beta H(π)>β 强制探索维持策略多样性;
- 2. 探索不足,传统固定温度采样难以平衡探索‑利用,ε‑greedy 或自适应温度机制(如PRIME)可动态调节;
- 3. 计算开销高,长链推理需海量GPU时,混合专家模型(MoE)与并行采样协同可显著降本;
- 4. 泛化能力弱,在分布外任务(如新型数学问题)表现不佳,需通过对抗性数据增强与元学习提升鲁棒性;
- 5. 可解释性差,黑箱决策难以审计,注意力权重可视化、归因分析与因果干预成为关键。
LRMs未来方向涵盖十二大前沿突破:持续强化学习(经验回放缓冲长时记忆);记忆增强(外部向量数据库存储历史轨迹);模型基奖励(世界模型预测未来状态生成内在奖励);高效教学(自适应计算预算分配);潜在空间优化(将离散令牌映射至连续空间以加速梯度);RL预训练(以next‑token预测为奖励构建通用策略);扩散式RL(将ODE求解器扩展为SDE,支持图像/视频生成);科学发现闭环(自生成假设‑验证循环);架构协同(MoE动态路由+RL联合训练);自监督奖励(Self‑Rewarding模型自我评估);测试时强化学习(TTRL,在推理阶段在线微调);多代理链式推理(Chain‑of‑Agents,子代理分工协作)。这些方向共同指向自我进化、长程规划与世界理解的超智能LRMs。
结论:RL通往ASI的桥梁
本综述聚焦强化学习驱动的大型推理模型(LRMs)前沿进展,通过可验证奖励强化学习(RLVR),成功将大型语言模型从“会说”升级为“会推理”。不同于RLHF等人对齐方法,RLVR以结果正确性为导向,系统梳理了奖励设计、策略优化、采样策略等核心机制,剖析训练争议,汇总静态/动态资源与基础设施,并展望编码、代理、多模态等应用场景。未来,RL或将成为通往超智能的关键引擎,推动语言模型实现长链推理、自我进化与世界建模的突破性飞跃。