
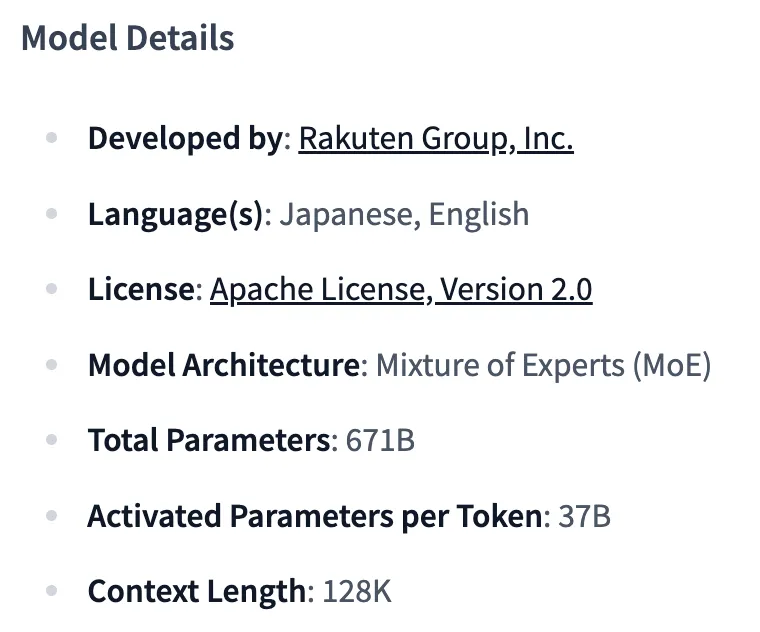
2026年3月17日,日本乐天集团(Rakuten)高调发布号称“日本国内最大规模高性能AI模型”的Rakuten AI 3.0。该模型参数总量约6710亿、激活参数约370亿,为MoE架构,专为日语优化,并在日语文化、历史、指令遵守等多项基准上宣称超越GPT‑4o。乐天强调这是GENIAC(生成式AI加速挑战)项目成果,利用“开源社区最优成果”结合自家双语数据开发,并以Apache 2.0许可证在Hugging Face免费开源,引发日本国内一片赞誉。
然而,发布不到12小时,技术社区便在Hugging Face仓库中发现惊人真相:模型核心配置文件config.json明确显示“model_type”: “deepseek_v3”,架构字段为“DeepseekV3ForCausalLM”,参数配置与参数规模与中国的DeepSeek V3完全一致。网友迅速扒出:这并非“自主研发”,而是基于DeepSeek V3进行日语微调的“换皮”版本。更严重的是,乐天在初始上传时直接删除了DeepSeek原始的MIT许可证文件(LICENSE),仅保留自家Apache 2.0声明。此举被视为严重违反开源协议,瞬间点燃全网争议。
违规细节与开源精神冲突
DeepSeek V3由中国深度求索公司开源,采用极度宽松的MIT许可证。MIT协议唯一核心要求就是:任何衍生作品必须完整保留原始版权声明和许可证文本。乐天却在仓库中彻底移除LICENSE文件,同时在官方新闻稿中模糊表述“充分利用开源社区最优成果”,全程未提及DeepSeek名称,极力塑造“日本自主研发”形象。
日本网友和开源社区迅速截图证据:config.json直接暴露底细,模型回答文化相关问题时也明显偏向中方视角。更离谱的是,乐天最初连版权归属都不标注,被曝光后才慌忙在仓库中新增一个名为NOTICE的文件,内容包含“Copyright (c) 2023 DeepSeek”及MIT协议全文,提交说明仅为“Add the permission notice”。这一“事后补救”被批评为“吃相太难看”——法律上勉强合规(MIT不强制文件名必须为LICENSE),但严重违背开源社区的透明与尊重精神。
多家媒体与技术论坛迅速跟进:虎嗅网、IT之家、Landian News、AIBase等报道一致指出,乐天此举不仅涉嫌误导公众,更与日本政府GENIAC项目“培育国产AI”的补贴初衷形成鲜明反差。部分网友直言:“拿纳税人补贴搞中国模型换皮,还想瞒天过海?”
乐天回应与社区反弹
面对舆论压力,乐天目前尚未发布正式道歉声明,但已通过仓库commit完成补救。目前Hugging Face页面已显示Apache 2.0 + NOTICE双重许可,模型卡也补充了“基于开源社区优秀成果”说明。部分分析认为,乐天此举可能源于品牌包装考虑:Apache 2.0更具企业正式感,便于构建自身生态,而直接标注DeepSeek会削弱“日本最强AI”的宣传效果。
然而,日本技术社区反弹强烈。Reddit、X平台及国内论坛充斥吐槽:“前代Rakuten AI‑7B还老实写‘基于Mistral’,这次直接玩消失?”“日本前十大AI模型里6个都靠DeepSeek或Qwen微调,现在连承认都不敢?”甚至有声音质疑:如此依赖海外开源,是否真正体现了“国产AI”实力?
开源生态的警示意义
从法律角度看,DeepSeek V3的MIT许可证允许商业使用与二次开发,乐天行为并未构成侵权。但开源社区强调:透明度才是开源的灵魂。删除原始许可证的行为,不仅伤害了DeepSeek贡献者的权益,更可能引发连锁效应——未来其他公司效仿,将进一步破坏全球开源信任。
这一事件也暴露了当前AI发展现实:即使是“日本最大模型”,底层架构仍高度依赖国际开源成果(日经此前报道,日本企业前十大AI多基于DeepSeek/Qwen)。在中美AI技术竞争加剧的2026年,日本企业如何平衡“自主创新”宣传与实际开源依赖,成为业界热议焦点。
结语:透明才是最大竞争力
乐天AI 3.0从“日本骄傲”到“套壳争议”,仅用12小时完成翻车。紧急补救虽让法律合规,但社区信任已受重创。事件提醒所有AI从业者:开源不是“拿来主义”的免死金牌,尊重原作者、公开归属,才是可持续发展的根本。
随着事件持续发酵,乐天是否会进一步说明微调细节、公开训练数据来源,或成为下一波关注焦点。无论结果如何,这一争议已为全球开源AI生态敲响警钟——在追求“最强”标签的同时,别忘了最基本的诚信。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com