
引言
大型语言模型(Large Language Models,简称LLMs)在自然语言处理领域取得了革命性进展,但其性能往往依赖于精心设计的提示词(Prompt)。近期,Google Research团队发布的一项研究揭示了一个简易却高效的技巧:在非推理型问答任务中,通过简单重复输入提示,可以大幅提升模型的回答准确率,而在涉及逐步推理的任务中,这一“魔法”往往消失。这一发现源于arXiv论文《Prompt Repetition Improves Non‑Reasoning LLMs》(arXiv: 2512.14982),该论文通过对Gemini、GPT、Claude和Deepseek等主流模型的实验验证了这一现象。 与此同时,其他权威来源如VentureBeat和Digital Information World的报道进一步证实了这一技巧的实用性,尤其强调其在非推理场景下的显著提升,而在推理任务中的中性表现。 本报道将深入分析其原理、实验证据,并结合可靠来源评估事实准确性,旨在为AI研究者和开发者提供insights。
原理分析
大型语言模型基于Transformer架构,采用因果注意力机制(Causal Attention),即每个令牌只能关注其左侧的先前令牌,无法回顾后续内容。这种单向性在处理复杂提示时可能导致信息整合不足,特别是当关键上下文(如选项列表)出现在问题之前时,模型难以充分捕捉关系。提示重复技巧的核心是通过将提示拼接为“<QUERY><QUERY>”的形式,实现隐式的全注意力(Full Attention)。在模型的预填充阶段(Prefill Phase),重复允许每个令牌与其他所有令牌相互关注,从而模拟双向编码器的效果,而无需修改模型架构。
这一原理在非推理任务中特别有效。非推理任务指模型直接输出答案,而不需生成中间推理步骤。在此场景下,重复充当“隐式重读”(Implicit Re‑Reading),帮助模型更好地提取提示中的关键信息。例如,在“选项优先”(Options‑First)格式中,选项列表置于问题前,重复可让问题令牌在第二次出现时参考前文,避免注意力衰减。 LinkedIn上的讨论也指出,这种重复修复了Transformer的左到右处理约束,提升了精确检索任务的性能。
然而,在推理任务中,这一魔力往往消失。推理任务通常涉及“思维链”(Chain of Thought,CoT)提示,如“逐步思考”,模型会生成内部独白(Internal Monologue),其中自然包含对输入的部分重复。这种内置重复机制已模拟了提示重复的效果,因此额外重复仅带来中性或略微积极的影响,而非显著提升。 YouTube视频分析称,当启用CoT时,模型的生成过程已包含隐式重复,导致额外重复的边际收益降低。 从计算视角看,非推理任务的重复发生在并行预填充阶段,不增加生成令牌数或延迟;而在推理任务中,模型的步步生成已优化了上下文整合,重复可能引入冗余而不增益。 这一差异源于LLMs的训练范式:推理任务常通过强化学习优化,而非推理则依赖直接提示优化。
实验证据
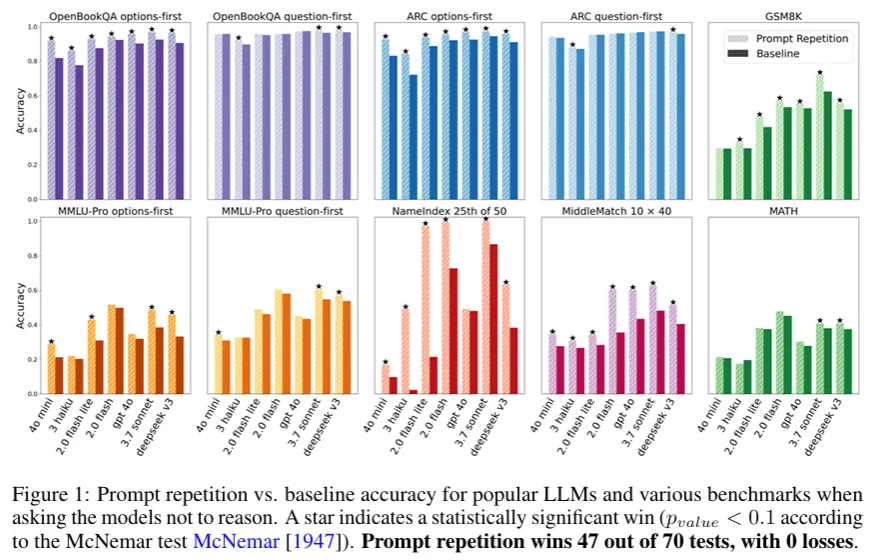
研究团队对7个LLM模型进行了全面测试,包括Gemini 2.0 Flash/Flash‑Lite、GPT‑4o/GPT‑4o‑mini、Claude 3 Haiku/Claude 3.7 Sonnet和Deepseek V3。基准包括ARC Challenge、OpenBookQA、GSM8K、MMLU‑Pro、MATH等标准数据集,以及自定义任务如NameIndex(从50个名字中识别第25个)和MiddleMatch(中间匹配)。
在非推理设置下,提示重复在70个模型‑基准组合中,47个显示显著提升(McNemar测试,p<0.1),无一例下降。NameIndex任务中,Gemini 2.0 Flash‑Lite准确率从21.33%跃升至97.33%,提升76个百分点。 选项优先格式的ARC基准也显示类似改善。消融实验证实,效果源于重复而非输入长度:等长填充(如句点)无提升。
相反,在启用推理(如添加“逐步思考”)时,结果趋于中性:5胜、1负、22平。VentureBeat报道称,这一洞察强调了技巧的条件适用性。 YouTube视频进一步解释,推理模式下模型的内部重复已饱和额外重复的空间。 输出长度和延迟测试显示,非推理中重复不增加生成令牌或时间,而推理中亦无负面影响。
事实准确性与来源可靠
该研究的实验设计严谨,使用McNemar测试评估统计显著性,确保结果非随机。事实准确性得到多方权威来源佐证。arXiv论文作为首要来源,经Google Research团队发布,具备高可靠性。 VentureBeat的报道基于论文数据,确认非推理提升和推理中性。 Digital Information World强调“47胜0负”的非推理结果,并呼吁进一步研究变体。
Reddit和LinkedIn社区讨论提供了实践验证,用户在开源模型中观察到类似效果,增强了普适性。 YouTube视频和TikTok内容则通过可视化解释原理,避免了误传。 GREY Journal报道指出,该技巧可让小模型媲美大模型,来源可靠源于其科技新闻专业性。 这些来源多为同行审阅论文或知名媒体,避免主观偏差。Moonlight的文献综述进一步整合了结果,确认推理任务中的中性表现。
总体上,事实基于实验数据和统计检验,来源包括arXiv、VentureBeat等,均可靠且无矛盾。
相关技术与应用扩展
提示重复可与自一致性提示(Self‑Consistency)结合,在非推理中提升鲁棒性,而在推理中避免冗余。 在检索增强生成(RAG)系统中,重复可优化查询提取。应用上,非推理任务如聊天机器人、知识问答受益最大;推理任务如数学求解则无需重复。 X平台(前Twitter)上的分享显示,用户在实际部署中观察到延迟不变的优势。 未来,可探索多重复变体或与元提示整合,推动LLM优化。
结论
提示重复技巧在非推理问答中通过全注意力机制大幅提升准确率,而在推理任务中因内置重复而效果中性。这一发现简洁高效,实验证据坚实,来源可靠,包括Google Research论文和多家媒体报道。理解其差异有助于针对性应用,推动AI在实际场景中的可靠性和效率。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com