
项目概述
在用 ChatGPT 或 Claude 聊天时,最令人吐槽的一点永远是:“说过的事转头就忘。”
尽管大语言模型有强大的上下文处理能力,但一旦会话上下文窗口关闭,之前的对话、用户偏好、甚至特定人物设定,都得靠反复提示“Prompt 注入”来重新构造。
为了填补这一块空白,GitHub 上最近出现了一个开源小工具——Persistent AI Memory,由开发者 savantskie 维护,主打功能就是四个字:“对话记忆”。
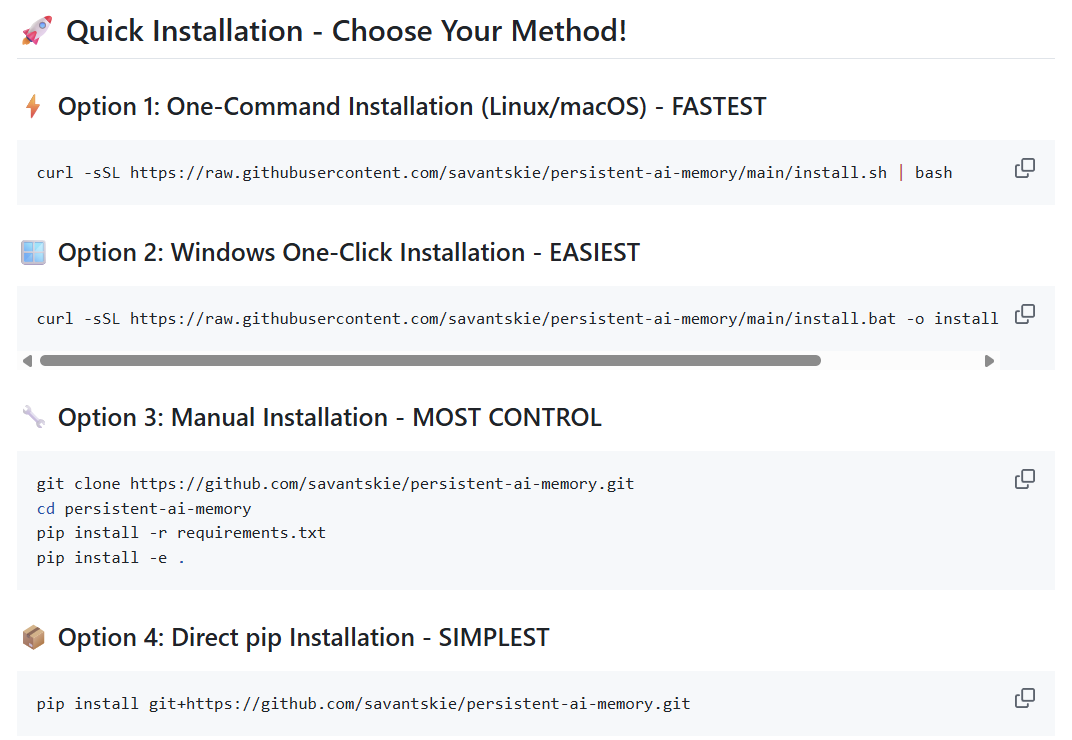
这个仓库背后其实没什么神秘的黑科技,但它把几件平时 LLM 工程师要重复写的“记忆持久化逻辑”做成了一个可插拔 Python 模块,重点解决两件事:
1️⃣ 把用户输入和模型输出存在本地或数据库里,按对话 Session 自动归档。
2️⃣ 提供一个可选的向量化索引(目前默认是用 OpenAI Embeddings + SQLite),把旧对话转成向量向量存储,支持相似度检索。
在项目的核心代码里,memory.py 是主角。
它暴露了一个 PersistentMemory 类,初始化时可以指定:
- 存储方式(本地 JSON 文件、SQLite,或者接 PostgreSQL)
- Embedding 生成方式(默认 OpenAI,但预留了自定义接口)
- 检索时是否启用相似度过滤,阈值是多少
比如,如果在你的对话循环里插一句:
python
Copy
Edit
memory = PersistentMemory()
memory.store(user_input, ai_response)
那么这条对话就会被自动写到 memory.db 或 memory.json,里面不仅有原文,还会有向量化后的字段。
真正的“记忆检索”是在调用时发生的。
当用户输入新问题时,memory.retrieve(prompt) 会先把 prompt 转 Embedding,然后在已保存的所有对话向量里跑相似度匹配,找出最 relevant 的几段历史对话,拼到上下文里,再交给主模型生成回复。
这一步在很多商业化方案里其实就是所谓的 RAG(检索增强生成) 的最小版本,只不过把知识库换成了你自己的对话历史。
在 Readme 里,savantskie 给出的一个典型用例是:
假设你用的是 OpenAI 的 GPT‑4o,用户跟助手对话了 20 条消息,其中提到生日、家乡、最喜欢的电影,然后关闭了浏览器。
下次用户回来再说“帮我订个生日蛋糕”,如果只用普通对话窗口,这些信息根本不会存在。但如果挂了 PersistentMemory,模型会自动从向量库里捞到“生日”相关的那一条,然后把“哪天生日、什么口味”作为上下文提示,再送给 GPT。
这一步就让对话看起来“记得住”,而且不需要重新硬 prompt。
从设计思路看,Persistent AI Memory 并没有帮你把所有记忆都丢给大模型,它只是:
- 自动保存所有对话的“可索引片段”
- 用 Embedding 检索最 relevant 的片段
- 把这些拼到系统 prompt
换句话说,真正执行记忆的是主模型,PersistentMemory 是“记忆数据库 + 检索插件”。
这套方法和市面上一些高阶对话产品(比如 Poe、Character.AI)内部用的记忆策略基本一致,只是人家没开源。
目前 Persistent AI Memory 默认用的是本地 SQLite,也有社区 fork 了 Milvus、Weaviate 等向量库版本,支持做成真正的云端多用户记忆池,或者挂到 FastAPI 做成多端调用。
在 Issues 区,有开发者已经在做前端聊天盒子对接,打算把这个 Memory 接到自己做的个性化助理里。
对大多数想自己玩 LLM bot 的开发者来说,这个库的意义不在于多复杂,而是让“长期记忆”这个词从纯粹的理论 prompt,落成了可执行的数据库 + 检索。
想让 GPT 不再健忘,没那么神秘,但得有人先把“记什么、怎么存、怎么捞”做成工具,这就是 Persistent AI Memory 正在做的事。