
Anthropic从未发布过任何关于Claude Mythos的技术论文。权重未公开,架构未披露,官方对其内部工作机制保持沉默。然而,这并未阻止研究社区进行一场大胆的智力实验——22岁的Swarms智能体框架创始人Kye Gomez在GitHub上发布了OpenMythos项目,一个基于公开研究文献、从零开始理论重建的PyTorch实现,试图回答一个核心问题:如果Claude Mythos真的存在,它的架构可能长什么样?
核心假设:Mythos是"循环深度Transformer"
OpenMythos的核心赌注是Recurrent‑Depth Transformer(RDT,循环深度Transformer),又称Looped Transformer。这与当前主流的GPT、LLaMA等前馈架构存在本质差异。
在传统Transformer中,输入token依次流经数十至上百个独立层,每层拥有独立权重,能力扩展依赖于层数和参数量的堆叠。而RDT将计算分为三段式结构:Prelude(前奏层)→ Recurrent Block(循环块,运行T次)→ Coda(尾声层)。其中,Prelude和Coda是仅运行一次的标准Transformer层,而中间的循环块使用同一组权重反复迭代,每次将输出反馈为下一次输入。
Gomez用一句话概括其设计哲学:"堆叠循环,而非堆叠参数"(Stack loops, not parameters)。具体而言,循环块在每次迭代时更新隐藏状态的公式为:
h_{t+1} = A·h_t + B·e + Transformer(h_t, e)
其中h_t为第t次循环后的隐藏状态,e为Prelude编码的输入(在每次循环中重新注入以防止信号漂移),A和B为可学习的注入参数。
这种设计的理论优势在于:推理深度不再由存储的参数数量决定,而由推理时的迭代次数决定。Saunshi等人2025年的论文已形式化证明,RDT的每次循环迭代在功能上等价于一步链式思维(Chain‑of‑Thought),但所有"思考"发生在连续的潜在空间中,不生成中间token。
关键组件:MoE、MLA与稳定性机制
OpenMythos并非简单的循环Transformer,而是整合了当前最前沿的若干技术组件:
混合专家模型(MoE):循环块中的前馈网络被替换为MoE层,采用DeepSeekMoE的设计——大量细粒度路由专家加少量始终在线的共享专家。关键在于,路由器在每次循环深度选择不同的专家子集,使得同一权重在不同迭代中执行不同计算。Gomez总结:"MoE提供领域知识的广度,循环提供推理的深度"。
多潜在注意力(MLA):默认使用DeepSeek‑V2的MLA机制,缓存压缩的低秩KV潜在表示而非完整键值张量,可在生产规模下将KV内存减少10‑20倍。
LTI稳定性约束:训练循环模型历史上 notoriously 不稳定,隐藏状态可能在迭代中无界增长(残差爆炸)。OpenMythos借鉴了2026年UCSD与Together AI的Parcae论文,通过参数化约束确保注入矩阵A的谱半径(spectral radius)严格小于1,从而保证稳定性。具体实现为:
A = exp(-exp(log_dt + log_A))
初始化时log_A和log_dt均为零,此时A = exp(-1) ≈ 0.3679,天然满足稳定条件。
自适应计算时间(ACT):为解决"过度思考"问题(循环过深导致隐藏状态越过解空间进入噪声),ACT为每个位置学习一个标量,动态决定何时停止循环——简单token提前退出,困难token获得更多计算。
深度LoRA适配器:在每个循环迭代添加小型低秩适应矩阵,使各次循环在共享大权重的基础上拥有微调行为差异,弥合纯权重共享与完全独立层之间的表达力差距。
实测验证:从理论到硅片
OpenMythos并非纸上谈兵。技术博客TinyComputers.io的作者使用搭载AMD Ryzen AI MAX+ 395 APU(集成Radeon 8060S GPU,60GB统一内存)的设备,成功运行了1B参数版本。
实测数据显示:batch=1、序列长度128、16次循环、bfloat16混合精度下,前向推理耗时2.07秒,峰值显存占用6.44GB。作者进行了五项关键验证:
- 谱半径验证:初始化时实测
ρ(A) = 0.367879,与理论预测匹配至六位小数,确认Parcae的稳定性约束正确实现。 - 循环有效性:对比不同循环次数的输出,1次循环与16次循环的argmax一致性仅35.2%,KL散度0.19 nats;随着循环增加,分布单调收敛,证明循环确实在执行有意义的计算而非空转。
- 稳定性消融:移除LTI约束后,训练在20步内梯度范数崩溃至机器零,损失冻结在均匀分布熵值;而稳定版本持续产生有效梯度,精确复现了Parcae论文预测的失败模式。
- 隐藏状态增长:当强制
ρ=2.0时,8次循环后隐藏状态从91膨胀至23,232,几乎精确遵循理论预测的每轮2倍增长。 - 吞吐量测试:循环次数与延迟呈完美线性关系(16循环时62 token/秒),ACT机制在随机初始化模型上未显示加速效果,因批内所有位置需同时停止才能提前退出。
参数效率:770M追平1.3B
Parcae论文提供了关键的效率实证:在相同数据上训练,770M参数的RDT可达到1.3B标准Transformer的下游质量,参数量近乎减半。最优循环次数和最优token数均遵循幂律缩放,建立了循环训练的首个可预测扩展定律。
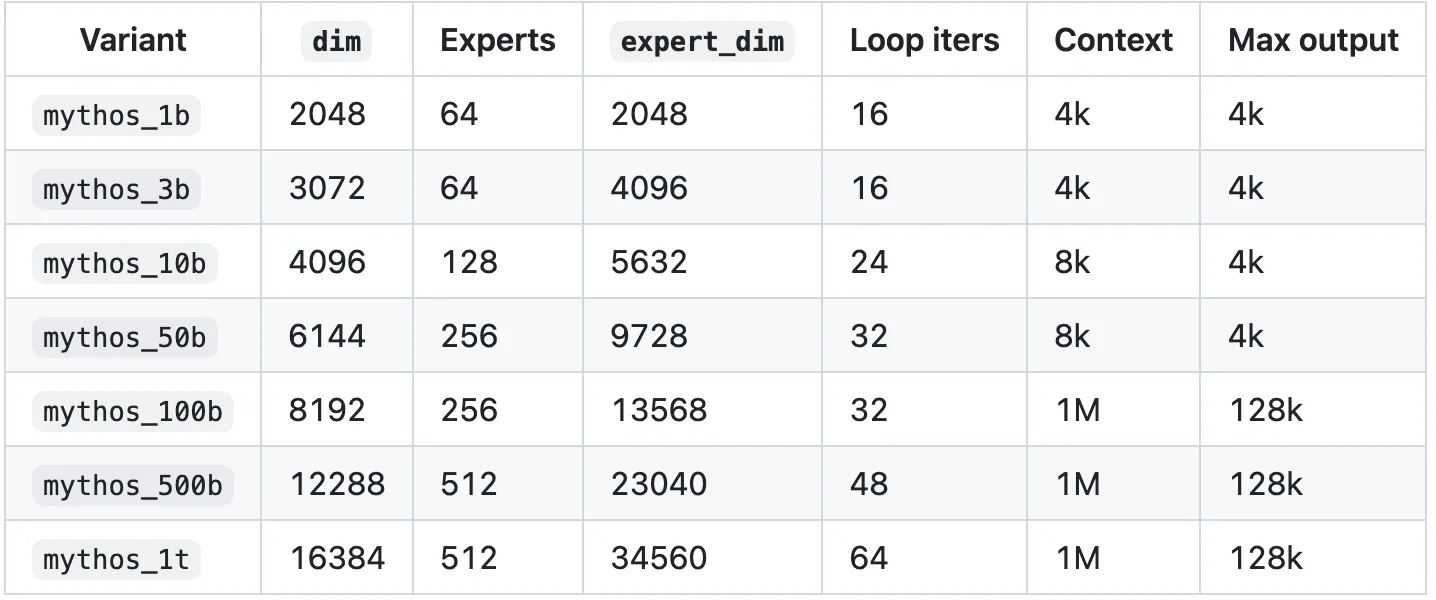
OpenMythos项目提供了从1B到1T参数的完整配置表。其中1B版本配置为:维度2048、64个专家、专家维度2048、16次循环、4K上下文。项目采用MIT许可证,代码约1000行,支持单GPU和多GPU分布式训练。
认知边界:重建不等于还原
TinyComputers.io的作者在验证后写下了一句意味深长的结论:"架构已验证,神话依然完整"(Architecture Verified, Mythology Intact)。
这揭示了OpenMythos的根本局限:它验证的是"循环Transformer作为一类架构是否可行",而非"Claude Mythos是否确实使用该架构"。作者明确指出,运行推测性重建只能告诉你重建本身是否内部自洽、是否与所引用的公开研究匹配,但无法告诉你重建是否映射到被重建的对象。
一个意外的发现也佐证了这一点:当作者尝试运行24次循环时,遭遇IndexError,原因是每循环适配组件被实现为固定大小max_loop_iters的查找表。这意味着深度外推(depth extrapolation)——训练于5步推理链、测试时运行10步或20步的能力——在该实现中受限于预设的最大循环数,无法简单通过"拧旋钮"在推理时无限扩展。这一细节在论文的理论主张中消失,却在具体实现中浮现。
结语
OpenMythos的价值不在于它"破解"了Anthropic的商业秘密,而在于它提供了一件可运行的教学 artifacts和可修改的研究基线。它将Parcae论文中数页数学推导浓缩为一行Python代码,将循环Transformer从抽象符号转化为可在家庭实验室测量的物理对象。
正如项目声明所言:"这是一个独立的、社区驱动的理论重建,基于公开研究和推测。它与Anthropic或其专有系统无任何关联、认可或联系"。在AI前沿模型日益成为"端点"(endpoint)——只暴露输入输出契约、隐藏一切内部机制——的时代,OpenMythos代表了一种逆向的开放精神:即使无法触及黑箱本身,社区仍能通过第一性原理的推理,在公开文献的碎片中拼凑出一个可运行的假设,并让它在硅片上真实运转。
无论Mythos的真实架构是否如此,OpenMythos已经证明:循环深度Transformer是一类可行的、参数高效的、具备推理扩展性的架构路径。而这,或许比猜测Anthropic的"神话"本身更具长远价值。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com