
2026年9月22日,就在Anthropic刚刚发布Opus 5.5之后,OpenAI正式推出GPT‑6 Sol与GPT‑6 Luna,进一步扩充GPT‑6系列。此前本月已发布旗舰模型GPT‑6 Astra,此次两款新模型将Astra在推理、事实性、编码、计算机使用与对齐等方面的改进下沉到更快速、更低价的层级,并实现相对GPT‑5.6对应型号约50%的API价格下调。发布时机紧随Anthropic Claude Opus 5.5之后约90分钟,体现了当前前沿模型竞赛的高强度。
详细情况
定位与能力
- GPT‑6 Sol:面向日常复杂任务与软件开发,适合编码、调试、重构、多步骤工作流及跨工具协作。官方称其在内部事实性评估中错误率约为前代GPT‑5.6 Sol的一半,达到接近Astra级别的可靠性,同时在编码与计算机使用能力上有提升。
- GPT‑6 Luna:系列中最高效的模型,针对高并发、目标明确的轻量任务,如摘要、信息抽取、分类与路由。支持可调节推理力度,以平衡质量、速度与成本。
两款模型均继承Astra的训练方法改进,支持约100万token上下文窗口,并在ChatGPT Work、Codex及API中可用。Plus、Pro、Business、Enterprise与Edu用户可使用Sol与Luna;Free与Go用户可在桌面端体验Luna。普通Chat界面初期未同步开放。
定价
官方公布的API价格(每百万token)为:
- GPT‑6 Sol:输入2美元、输出10美元(较GPT‑5.6 Sol促销价下降50%)
- GPT‑6 Luna:输入0.10美元、输出0.50美元(输入下降50%,输出下降约58%)
缓存读取享受大幅折扣(约输入价的10%)。OpenAI表示,缓存与推理效率提升使其得以将成本节约直接回馈用户。更高用量限额与更低单价,旨在支持更大规模迭代与Agent工作流。
基准表现
OpenAI公布的对比显示,Sol在AutomationBench等业务工作流测试中,以明显更低的单任务成本达到或超过部分更高价竞品(包括前代Anthropic模型)的表现;在DeepSWE等软件工程任务上接近顶级分数且成本显著更低。独立评测指出,价格腰斩使两款模型在“智能‑成本”帕累托前沿上占据有利位置,幻觉率也有下降,但综合智能指数与前代大体持平,部分编码Agent指标互有涨跌。需注意,多数数据仍以厂商报告与初步第三方结果为主。
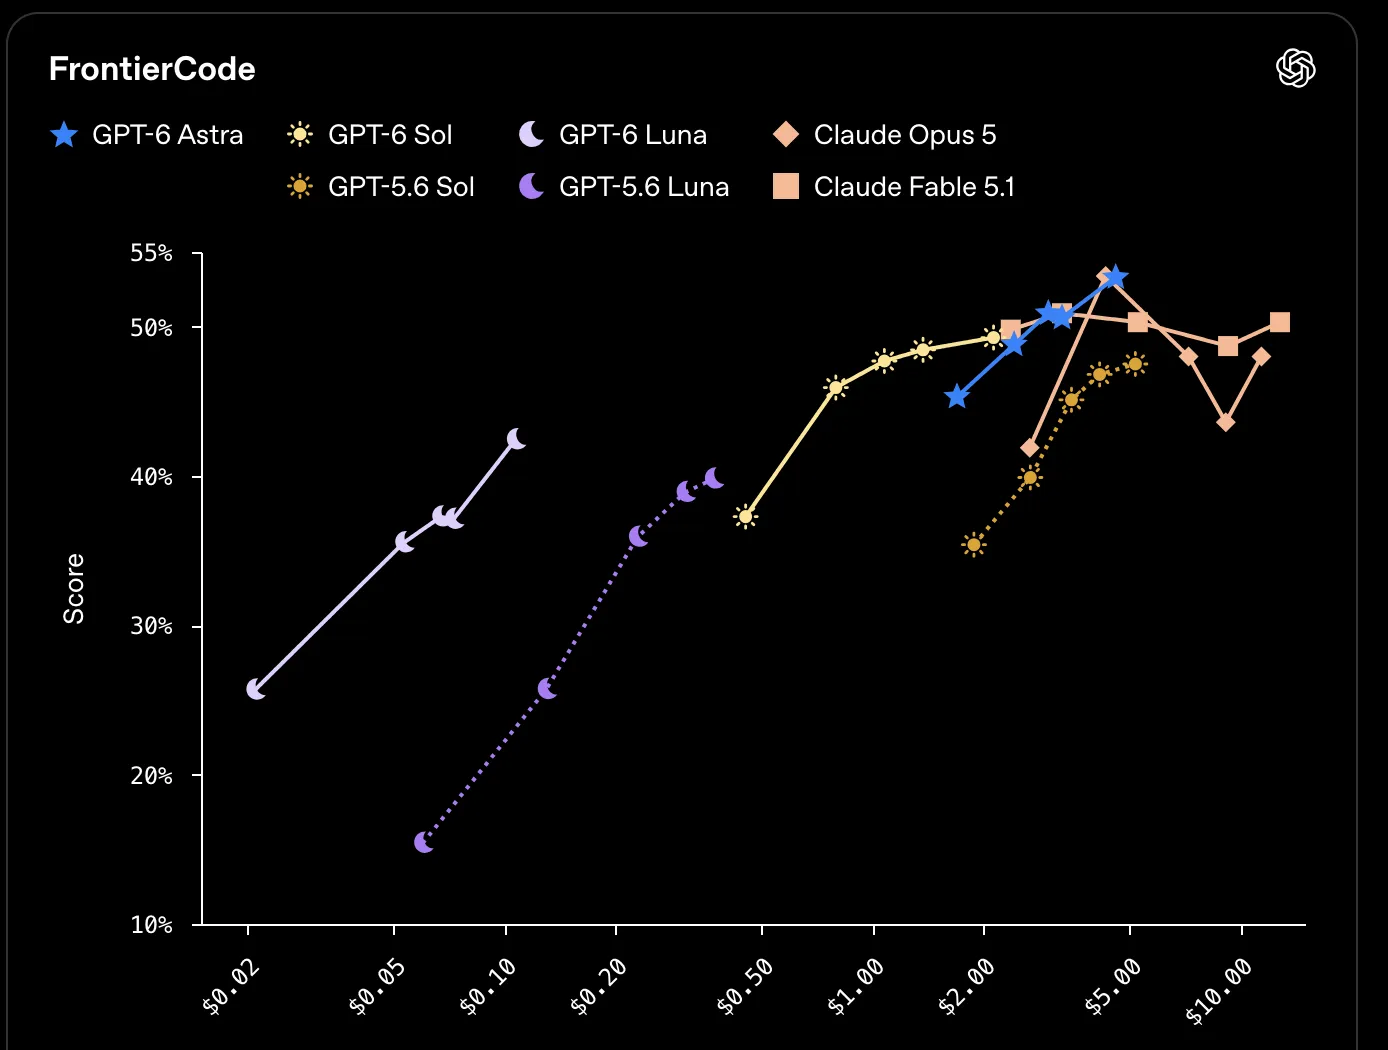
Cost per task
可能影响
1. 中端与高性价比市场竞争加剧
Sol与Luna的半价策略,直接回应了Anthropic同日发布的Opus 5.5(也大幅降价)。两者共同把“能力接近旗舰、价格显著更低”变成行业标配,迫使开发者与企业重新评估模型选型:旗舰用于最难任务,中端用于规模化生产。Terra层级在此次更新中未同步出现,产品线进一步向Sol/Luna聚焦。
2. Agent与规模化应用门槛下降
更低单价与更高限额,使长周期Agent循环、大规模代码处理与高并发分类/抽取任务在经济上更可行。结合缓存优化,实际单任务成本可进一步压缩,有利于推动AI从试点走向日常生产。
3. 事实性与可靠性成为卖点
OpenAI特别强调错误率减半与对齐改进,反映行业在追求能力的同时,正把“更少幻觉、更可靠输出”作为差异化重点。对专业工作与自动化场景,这比单纯刷榜更具实际价值。
4. 发布节奏与竞争格局
与Anthropic几乎同步的降价与能力更新,显示头部实验室正以周为单位争夺中高端市场份额。用户将受益于更快迭代与更低价格,但也需面对型号快速更迭带来的迁移与评测成本。后续独立复现与真实工作流数据,将决定Sol/Luna能否真正替代部分更高价调用。
结语
GPT‑6 Sol与Luna的发布,标志着OpenAI在旗舰Astra之外,系统性地把前沿进展下沉到可规模化使用的层级,并以半价策略强化性价比优势。它们并非追求绝对最强,而是在速度、成本与足够智能之间取得平衡,适合编码Agent、知识工作与高流量任务。结合同日Anthropic的动作,2026年下半年的模型竞争已从“谁更强”进一步转向“谁能在可接受成本下提供足够强且可靠的能力”。真正检验其价值的,仍将是开发者在生产环境中的长期使用反馈。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com