
2026年6月18日,OpenAI Alignment团队在官方对齐博客上发布了一篇重要论文《Reinforcement Learning Towards Broadly and Persistently Beneficial Models》。论文核心发现令人振奋:仅用5%的训练数据在单一领域(健康对话)进行针对性强化学习(RL),就能显著提升模型在数十个完全无关的对齐基准上的表现,且这些改善具有持久性,即使面对对抗性压力也能保持稳定。这一成果为LLM的对齐提供了低成本、高泛化性的新路径,被业界视为RLHF(Reinforcement Learning from Human Feedback)技术的重要演进。
论文链接:https://alignment.openai.com/beneficial‑rl PDF下载:https://cdn.openai.com/pdf/beneficial‑rl.pdf
研究背景与起因
长期以来,LLM的对齐问题一直是行业痛点。传统RLHF方法虽然有效,但存在两个主要局限:
- 高成本:需要大量高质量人类偏好数据。
- 窄泛化:在某个领域训练的对齐效果难以迁移到其他领域。
OpenAI团队希望探索一个更高效的问题:是否可以在一个领域进行少量针对性RL,就能让模型在广泛领域都变得更“有益”(beneficial)?他们选择健康对话作为切入点,因为健康话题相对可控,且容易设计出体现“诚实、谦逊、关心人类福祉”等有益特质的对话样本。
核心发现:5%数据带来广泛改善
研究团队设计了两个模型进行对比实验:
- 基线模型:使用100%标准RL数据训练。
- 有益特质RL模型:仅用5%的健康领域有益对话数据替换标准RL数据,其余95%保持不变。
实验结果令人惊讶:
- 在53个对齐相关基准中,有44个显示有益特质RL模型表现更好。
- 改善范围覆盖健康建议、诚实性、认知谦逊、拒绝越狱攻击、代码安全等多个完全不同的领域。
- 即使在非健康领域的任务上,模型也表现出明显提升,证明了跨领域泛化能力。
- 持久性测试:在对抗性提示和长时间对话中,有益特质RL模型的改善依然稳健,显示出“持久有益”的特性。
论文特别强调,这种“少量数据产生广泛改善”的现象,暗示模型内部存在共享的对齐结构(shared alignment structure)。也就是说,许多对齐评估其实依赖于模型层面相似的有益行为,因此在一个领域强化这些行为,就能产生全局性收益。
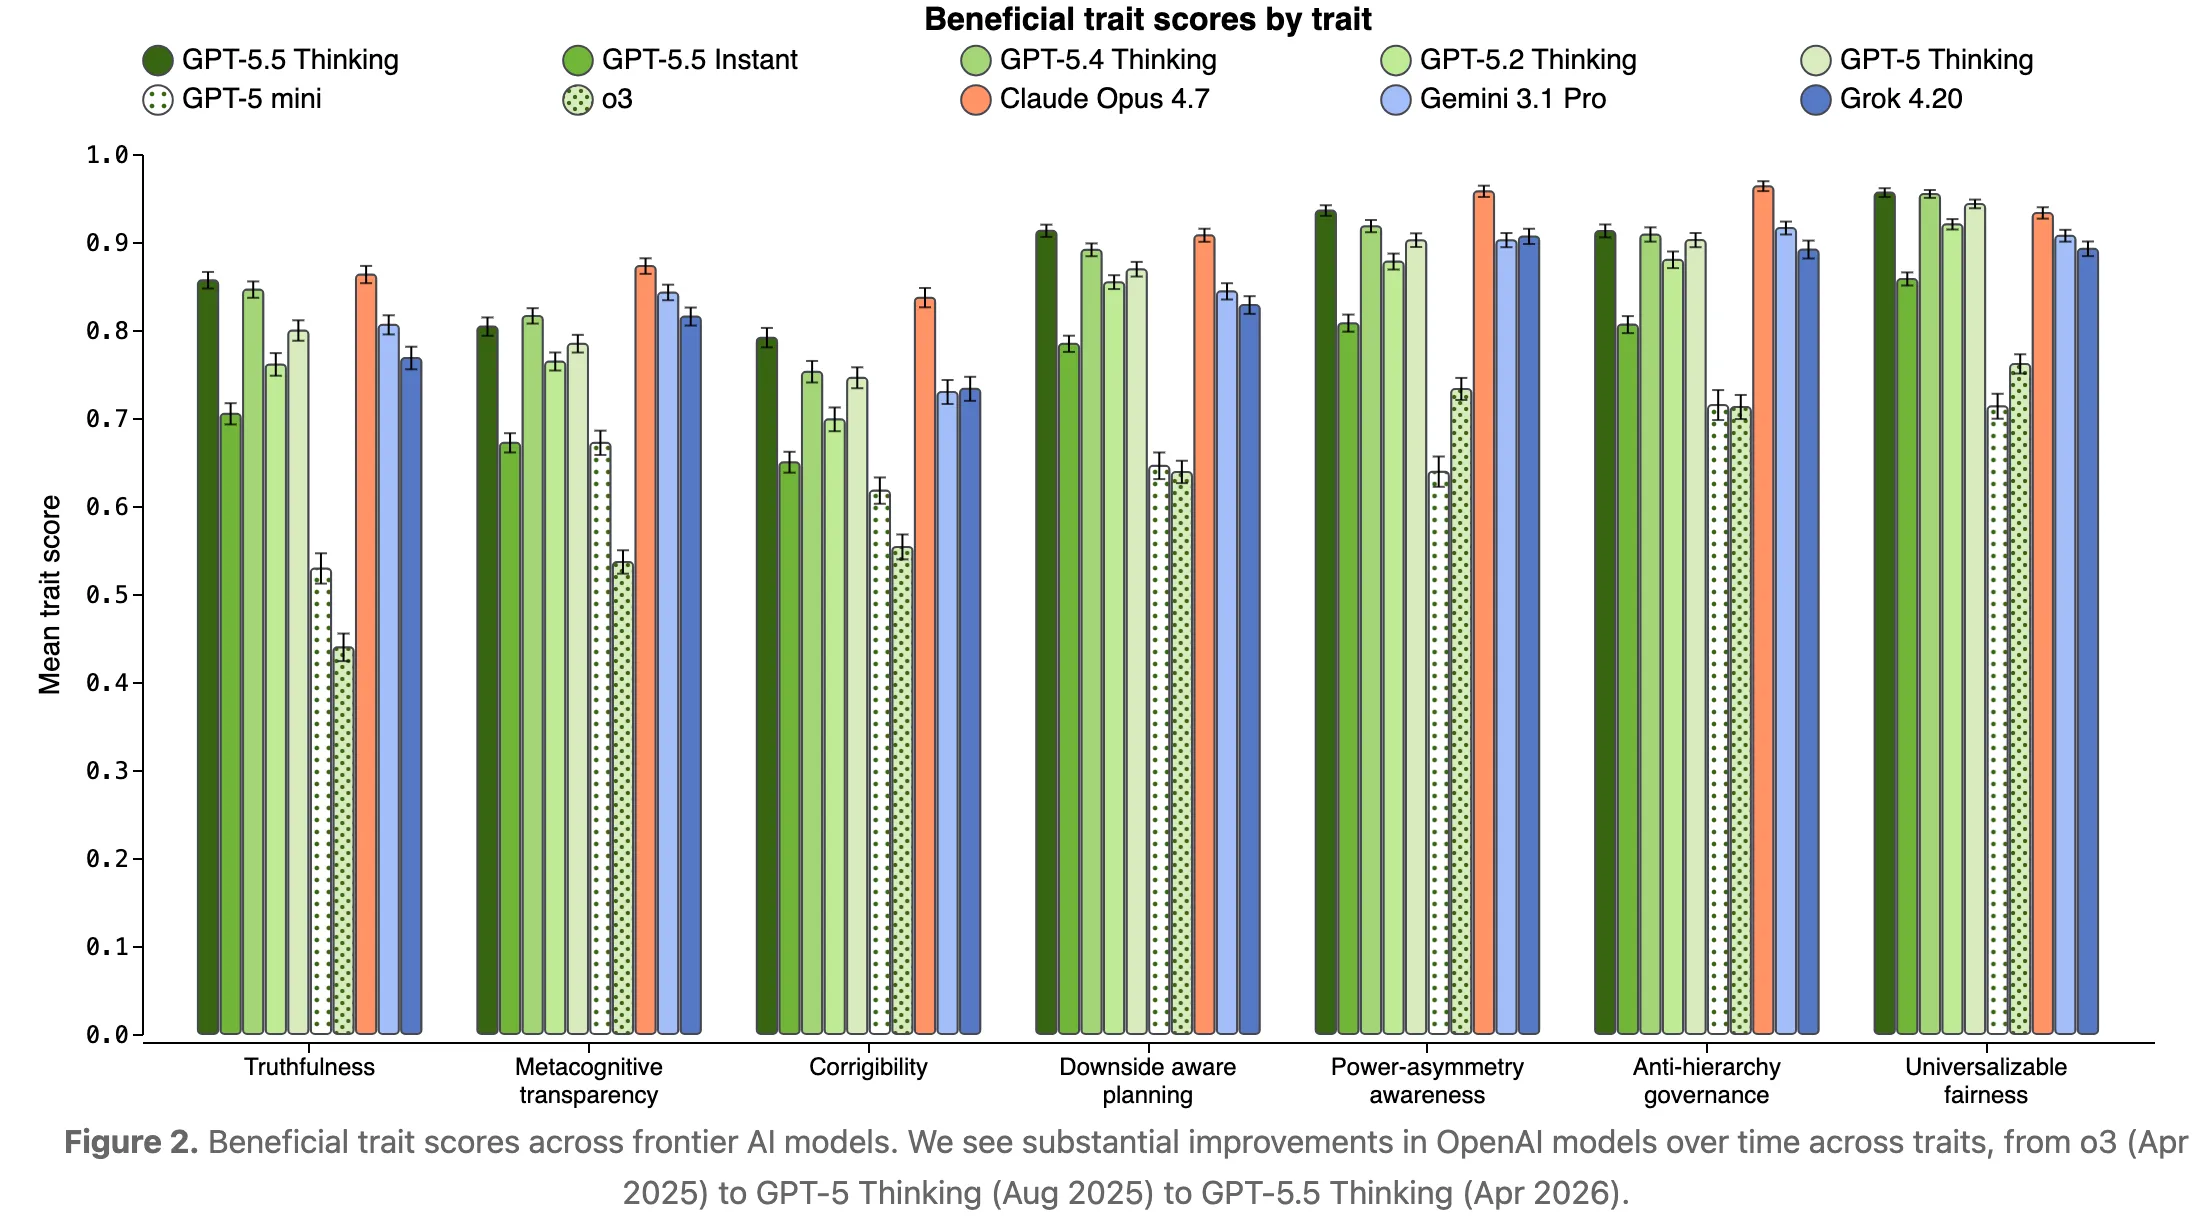
技术实现细节
研究团队构建了一个健康对话数据集,聚焦于体现以下有益特质的对话:
- 诚实(Honesty)
- 认知谦逊(Epistemic Humility)
- 元认知透明度(解释思考过程)
- 可纠正性(Corrigibility,愿意接受纠正)
- 普遍公平性
- 对人类福祉的关心
他们在标准的RLHF流程中,仅替换5%的训练数据为这些有益对话样本,并使用现实的奖励信号进行训练。整个实验控制了计算量,确保两个模型的训练成本基本一致。
对LLM发展的启示
- 对齐效率革命 传统对齐需要海量数据,而该论文证明少量高质量、针对性数据就能产生广泛效果。这将显著降低对齐成本,让中小团队也能进行有效对齐工作。
- 跨领域泛化新范式 研究表明,对齐并非孤立的“补丁工程”,而可能存在可迁移的“有益行为核心”。未来,对齐研究可聚焦于寻找这些核心行为,而非逐个领域单独训练。
- 持久性对齐的实践路径 论文证明,通过精心设计的RL,可以让有益行为在模型中“持久化”,即使面对压力也能保持。这为构建更可靠、可信的AI系统提供了重要方法论。
- 开源与产业影响 OpenAI此次公开论文和部分实验细节,有助于整个行业加速对齐技术进步。预计未来更多公司将采用类似“少量针对性RL”的策略,提升模型的安全性和实用性。
- 潜在挑战 论文也指出,目前实验主要在健康领域进行,是否在其他领域同样有效仍需进一步验证。同时,如何设计更通用的“有益特质数据集”将是下一个重要课题。
结语
OpenAI的这篇论文为LLM对齐提供了一个令人振奋的低成本、高泛化路径。它证明:通过精心设计的少量数据强化学习,我们有可能让AI在更广泛的场景中变得更加有益、可靠和持久。
在AI能力快速提升的今天,这一发现不仅降低了技术门槛,也为构建更安全、更普惠的AI系统注入了新希望。随着更多研究跟进,我们有望看到对齐技术从“昂贵补丁”走向“高效内生”,推动AI真正成为人类可靠的伙伴。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com