
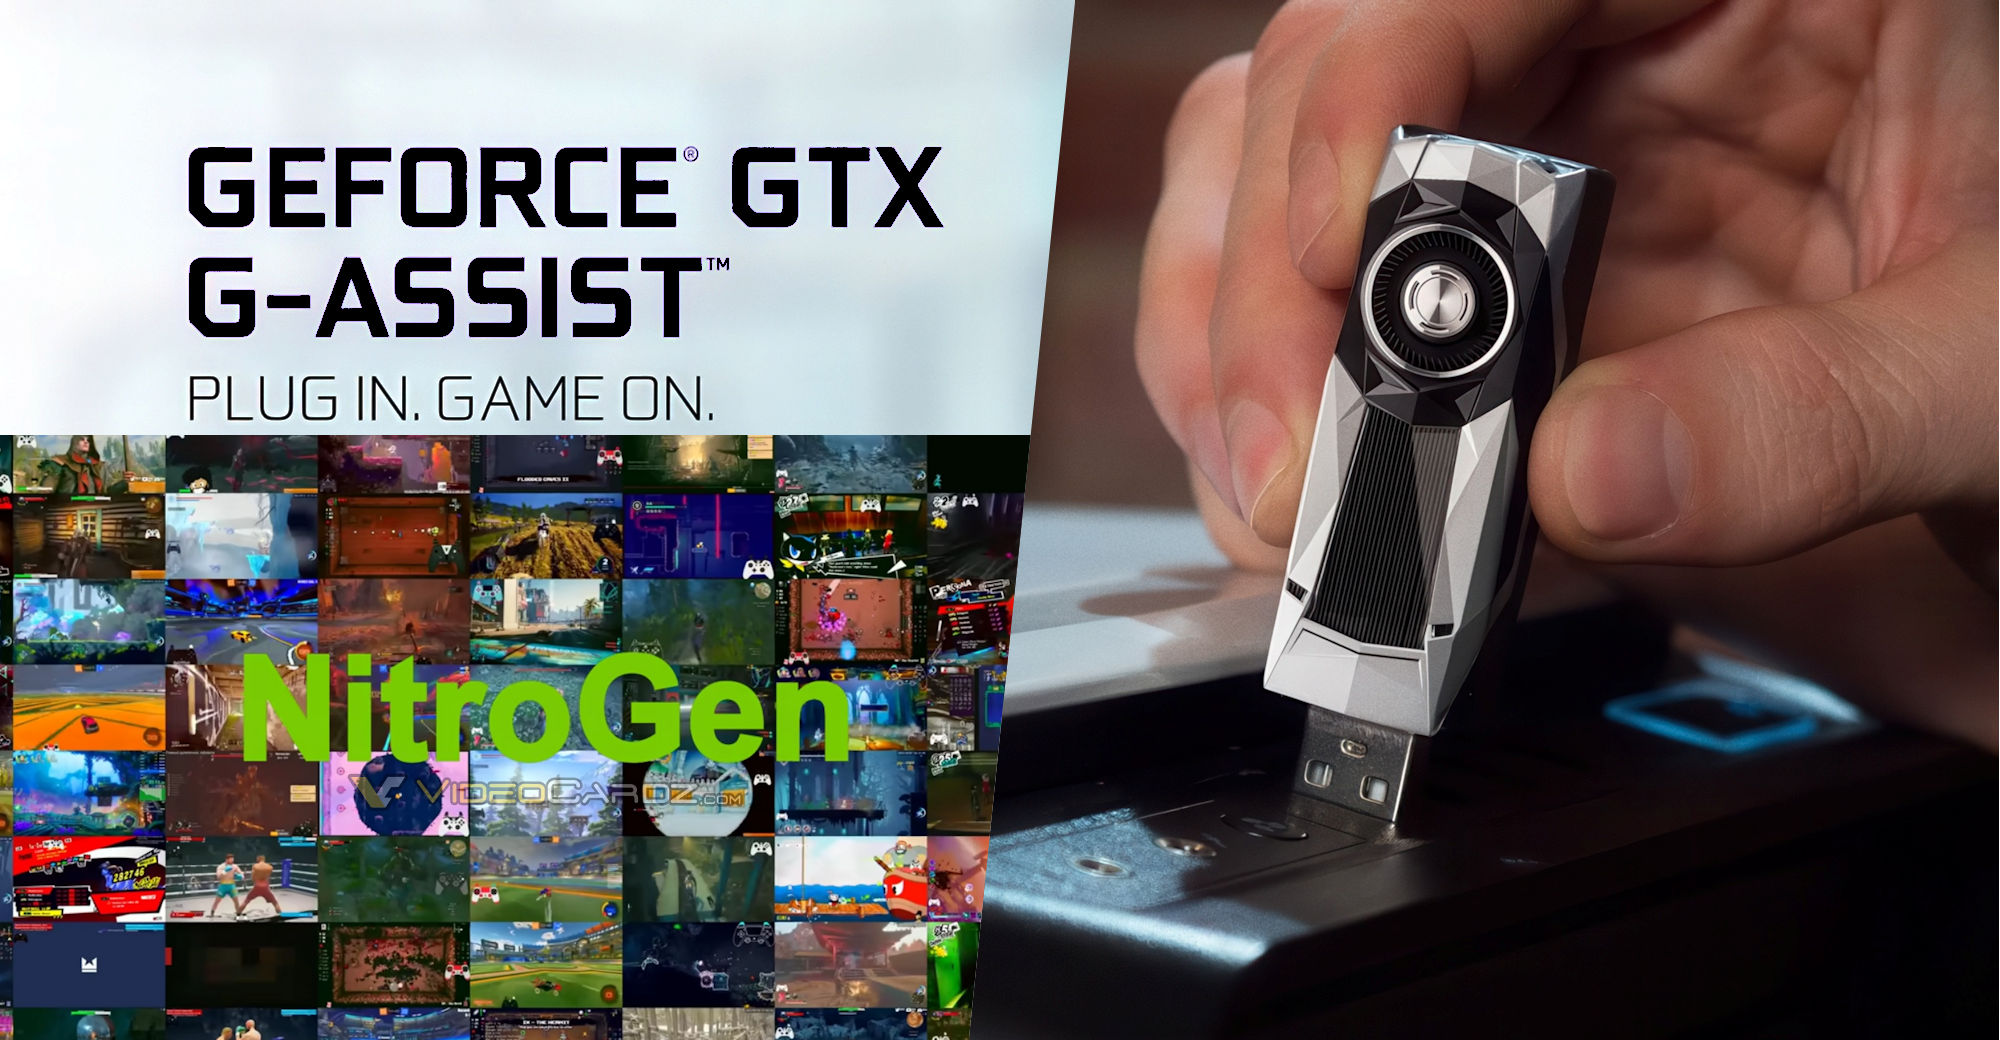
2025年12月20日,NVIDIA研究人员携手MineDojo团队正式发布NitroGen,一个开源的视觉‑动作(vision‑to‑action)基础模型。该模型专为通用游戏代理设计,通过处理原始游戏画面像素,直接输出游戏手柄动作,能够零样本玩转超过1000款游戏,涵盖动作RPG、平台跳跃、赛车等多种类型。 这项成果源于NVIDIA 2017年愚人节视频“G‑Assist”——一个AI替你玩游戏的玩笑概念,如今通过大规模行为克隆训练“变现实”。NitroGen不仅在游戏领域展现通用智能,还为具身AI和机器人学提供可扩展管道,标志着互联网规模数据驱动的代理训练新时代。
NitroGen的诞生解决了一个核心瓶颈:传统游戏AI依赖手工标注或专属模拟器,数据稀缺且泛化差。研究团队利用公开游戏实况视频(总计4万小时,覆盖1000+游戏),自动提取玩家动作标签,构建首个互联网规模视频‑动作数据集。 数据集托管于Hugging Face(nvidia/NitroGen),包含3万段标注视频、约150亿帧,每20秒块存储Parquet格式动作(17个按钮布尔值+2个摇杆[‑1,1]向量)和元数据(如游戏名、手柄类型、源URL)。846款游戏超1小时数据,91款超100小时,15款超1000小时;动作RPG占34.9%,平台跳跃18.4%。
动作提取管道是关键创新。全自动流程:从视频采样25帧,使用SIFT/XFeat关键点匹配定位手柄叠加层(支持Xbox/PS等多种类型),裁剪后由混合分类‑分割网络预测摇杆位置和按钮状态。为防“作弊”,网络仅从叠加图像推断,屏蔽游戏画面。质量控制显示,摇杆相关性R²达0.84,按钮帧准确率0.96,对比地面真相数据验证可靠。 此管道无需人工干预,适用于压缩 artifact 和透明度变异的真实视频,极大降低了标注成本。
模型架构基于流匹配GR00T(源于NVIDIA机器人项目),参数规模4.93亿。输入RGB游戏帧经预训练SigLip2视觉Transformer编码,输出经扩散匹配Transformer(DiT)生成动作序列(21x16形状:双摇杆连续值+17按钮)。训练采用纯行为克隆(imitation learning),在大规模噪声数据上预训练,无需奖励或任务目标,模拟语言模型的“规模即能力”范式。 推理优化于NVIDIA Hopper/Blackwell GPU,支持Linux/Windows,H100测试硬件。项目还提供通用模拟器:Gymnasium API包装Windows游戏二进制,支持一键控制和 rollout 记录。
性能基准令人印象深刻。研究构建多游戏基准,评估3类任务(5次 rollout/任务),覆盖3D动作、2D俯视/侧滚等视觉风格。预训练模型零样本即展非平凡能力,如3D战斗高精度控制、程序生成世界探索。转移实验更亮眼:预训练+在新游戏微调,任务成功率较从零训练提升高达52%;低数据场景(30小时)平均10%相对改善,证明规模数据注入通用技能(如导航、战斗、解谜)。演示视频展示模型玩《巫师3》、《赛博朋克2077》、《火箭联盟》等,动作流畅自然。
开源资源全面:Hugging Face模型权重(nvidia/NitroGen,非商业NVIDIA许可)、数据集、评估套件、代码尽释出。项目页(nitrogen.minedojo.org)含论文PDF,详述方法与结果。合作者包括NVIDIA(Loïc Magne、Linxi "Jim" Fan等)、斯坦福(Anas Awadalla)、加州理工(Georgia Gkioxari)等。 局限性明确:专注手柄游戏(鼠标键盘弱,如RTS/MOBA);噪声数据可能限泛化;需用户自备游戏二进制。
这一发布引发热议。VideoCardz称其“让G‑Assist成真”,Tom's Hardware强调对机器人学的启示:游戏作为丰富模拟器,可训练通用具身代理。 Reddit和X平台讨论聚焦其潜力:下一代NPC、游戏QA自动化,甚至浏览器/OS代理。Jim Fan LinkedIn发帖介绍,获广泛转发。 与OpenAI SIMA、DeepMind VPT比较,NitroGen首创互联网视频管道,成本低、覆盖广。
NitroGen的深远影响不止游戏。它验证了“网络抓取+自动标注+大规模克隆”的可扩展路径,推动通用代理从实验室走向现实。未来,结合RL或多模态输入,或扩展至机器人臂控制。NVIDIA此举强化开源领导力,助力开发者构建下一代AI游戏生态。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com