
作为人工智能领域的“奥斯卡”,第39届神经信息处理系统大会(NeurIPS 2025)于12月2日至8日在美国圣迭戈和墨西哥城双城举办,吸引逾2.5万名研究者、企业领袖和开发者参会。 此次大会收到约2万篇投稿,最终接受5858篇,接受率仅25%,创历史新低。 统计数据显示,美国和中国机构主导了绝大部分论文:美国约2450篇,中国2370篇,差距不足5%,共同占据全球AI前沿研究的近90%。 顶级50贡献机构中,美国以企业实验室(如Google DeepMind、Meta、Microsoft)领跑,中国则以学术与政府机构(如清华大学、中国科学院、北京大学、上海交通大学)见长。 这一“双雄争霸”格局,不仅体现在论文数量,还在最佳论文奖(Best Paper Awards)中显露无遗:4项最佳论文中,2项由中国团队主导,1项中美合作,1项美国独占。 此外,Test of Time Award授予10年前的经典论文《Faster R‑CNN》,作者包括中国学者何恺明(Kaiming He)和孙剑,进一步凸显中国在计算机视觉领域的深厚积累。 NeurIPS 2025的奖项与亮点,折射出AI从“规模竞赛”向“深度推理与可持续创新”的转向,也预示中美AI领导力的“并驾齐驱”将重塑全球科技生态。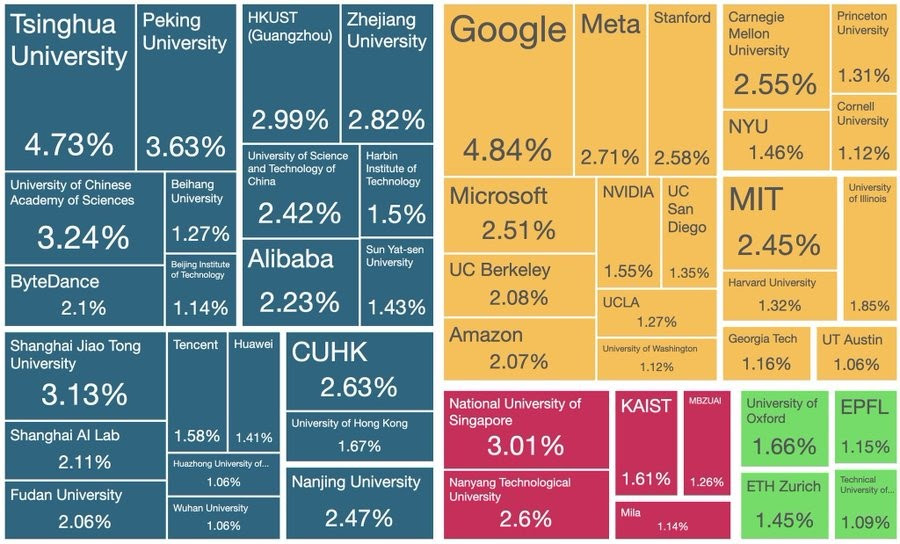
NeurIPS作为机器学习与神经网络领域的顶级会议,自1987年起已发展为AI创新的风向标。2025年大会新增“位置论文轨道”(Position Paper Track),鼓励探讨AI的社会影响,投稿量激增30%。 主题聚焦大型语言模型(LLM)、多模态学习、强化学习(RL)和扩散模型,接受论文中LLM相关占比高达35%,推理与评估论文占比13%。 奖项评选由数百名审稿人参与,标准严苛:创新性、可重复性和影响力。大会官网于11月26日公布获奖名单,引发全球热议。 以下逐一剖析主要奖项,揭示其技术内核与意义。
最佳论文奖(Best Paper Awards)是NeurIPS的“皇冠”,2025年共评选4项,覆盖生成式AI理论、RL和LLM架构创新。其中,中国团队的《Gated Attention for Large Language Models: Non‑linearity, Sparsity, and Attention Sink Free》斩获一席,由阿里巴巴通义千问(Qwen)团队Zihan Qiu等作者完成。 该文针对LLM的注意力机制痛点,提出在Scaled Dot‑Product Attention(SDPA)后添加头特定sigmoid门控(head‑specific sigmoid gate),引入非线性与稀疏性,提升模型稳定性、学习率容忍度和长上下文性能。 实验对比30种15B MoE模型和1.7B稠密模型,训练于3.5万亿token数据集,结果显示门控机制改善性能5‑10%,并解释了其在低秩映射上的非线性作用及查询依赖稀疏门控对SDPA输出的调制。 评审委员会赞其“简单修改带来系统性提升”,这不仅是LLM架构的微调,更为“注意力沉没”(attention sink)问题提供理论框架。 作为中国唯一最佳论文,该奖项凸显阿里巴巴在基础模型领域的全球竞争力。
另一最佳论文《Artificial Hivemind: The Open‑Ended Homogeneity of Language Models (and Beyond)》由华盛顿大学、卡内基梅隆大学和Allen Institute的Liwei Jiang等作者完成。 论文揭示LLM在开放式生成任务中趋向“同质化”:不同模型输出相似,缺乏人类般的多样性,引发对“思想同化”担忧。 团队引入Infinity‑Chat数据集,首次大规模测量开放提示的多样性,并证明训练数据偏差是根源。评审称其“揭示LLM的隐忧,并为评估多样性提供新工具”。 这项中美合作成果(作者包括中国背景学者)强调AI伦理,影响生成式内容的安全评估。
第三项《Why Diffusion Models Don’t Memorize: The Role of Implicit Dynamical Regularization in Training》探讨扩散模型的泛化机制。 作者分析训练动态,证明隐式正则化防止过拟合,确保模型不“记忆”训练数据。该文发表于OpenReview,评审突出其理论深度:“为扩散模型的鲁棒性提供数学解释。” 中国作者占比高,体现了中方在生成模型理论的贡献。
第四项《Does Reinforcement Learning Really Incentivize Reasoning Capacity in LLMs Beyond the Base Model?》质疑RL在LLM推理提升中的作用。 作者通过实验证明RL仅放大基模型能力,而非创造新推理路径。评审称其“挑战RL神话,推动更高效训练”。 这项美国主导的研究,引发对RL范式的反思。
Test of Time Award授予2015年的《Faster R‑CNN: Towards Real‑Time Object Detection with Region Proposal Networks》,作者Shaoqing Ren、何恺明、Ross Girshick和Jian Sun。 该文引入Region Proposal Network(RPN),实现5fps实时检测,奠基现代计算机视觉。10年后,其影响超万次引用,推动YOLO等后续工作。 评审强调:“R‑CNN从提案到端到端训练的转变,定义了检测时代。” 作为中国学者主导的经典,该奖项彰明显著贡献。
此外,NeurIPS 2025新增Sejnowski‑Hinton Prize,表彰桥接生物脑与AI的论文,首获奖项授予一项模拟皮层触觉计算的RL工作。 Datasets & Benchmarks轨道的最佳论文探讨创意内容多样性。
中美主导的原因多维。美国优势在于企业生态:Google DeepMind、Meta和Microsoft实验室贡献超40%论文,这些机构拥有海量计算资源(如Nvidia Blackwell GPU)和跨学科人才。 硅谷“人才磁场”吸引全球精英,2025年AI博士薪资中位数超30万美元。 中国则靠学术与政府合力:清华大学等机构获国家“双一流”支持,AI专利占全球70%。 政府投资超1000亿元,推动“新一代AI”计划,培养本土人才。 投稿数据显示,中国论文平均引用率2.8,美国4.2,但中国数量增长更快。 共同驱动是AI“规模定律”:中美掌握70%全球投资,61%人才。 欧洲碎片化(仅一机构入前50)凸显中美“国家战略”优势。
后续影响将重塑全球AI版图。首先,竞争加剧:中美“并驾”或催生“双轨”生态,美国企业主导应用,中国学术领跑理论。 奖项中中国占比50%,预示开源模型如Qwen将蚕食Llama份额。 其次,全球合作机遇:NeurIPS的双城举办象征包容,中美合著论文占比20%。 但脱钩风险上升:美国芯片禁令或延缓中国创新。 对其他国家启示:新加坡(NUS、NTU)和阿联酋(MBZUAI)入前50,证明“针对性投资”可弯道超车。 欧洲需整合资源,避免“碎片化”。 长期,奖项推动AI伦理:如“同质化”论文警示思想多样性缺失。
NeurIPS 2025不仅是学术盛宴,更是AI“中美时刻”的镜像。在“代理时代”,这些奖项预示推理与生成模型的融合,将驱动万亿美元产业。 作为全球AI灯塔,NeurIPS提醒:创新不止于数量,更在质量与责任——中美主导,或成全球共赢的起点。