
引言:从 Transformer 到 Nested Learning 的理论飞跃
在人工智能研究领域,2017年的里程碑论文《Attention is All You Need》奠定了Transformer架构的基础,推动了从RNN到注意力机制的范式转变。如今,八年后的2025年11月,Google Research团队发布续作《Nested Learning: The Illusion of Deep Learning Architectures》,直接针对AI模型的核心痛点——灾难性遗忘(Catastrophic Forgetting)提出革命性解决方案。该论文由Google Research的资深研究员团队撰写,于2025年9月19日在NeurIPS 2025会议录用发布,迅速引发学术界和产业界的热议。论文摘要强调:“我们引入Nested Learning范式,将模型架构视为不同速度优化的互联系统,模拟大脑的连续记忆机制,从而实现无遗忘的持续学习。” 这一工作不仅延续了原论文的注意力核心,还将它扩展到动态、适应性架构,标志着AI从静态训练向“终身学习”模式的转变。MIT Technology Review在11月20日的评论中称:“V2不是简单续作,而是对Transformer的哲学重构,可能解决AI最大瓶颈。” 作为Google DeepMind与Google Brain合作成果,预计将重塑LLM(大型语言模型)和多模态AI的训练范式。
论文的核心动机源于AI持续学习的困境。传统模型如GPT系列或Gemini,在初始训练后难以适应新数据:学习新知识往往导致旧知识遗忘,准确率下降30‑50%。 人类大脑则不同,通过海马体和皮层的分层记忆机制,实现“渐进巩固”——短期记忆快速更新,长时记忆稳定存储。论文作者指出:“现有方法如EWC(Elastic Weight Consolidation)或Replay缓冲仅缓解遗忘,无法根治,因为它们视模型为单一优化问题。” Nested Learning范式则创新地将模型视为“嵌套优化系统”:外层优化架构(如注意力头数量),内层优化参数(如权重更新),不同层以独立速度运行,模拟大脑的多时序处理。
灾难性遗忘问题详析:AI学习的“阿喀琉斯之踵”
灾难性遗忘是神经网络的顽疾,自1989年McCloskey和Cohen首次描述以来,已困扰AI研究30余年。 在LLM中,当模型在新数据集上微调时,梯度更新往往覆盖旧权重,导致性能急剧下降。例如,BERT模型在GLUE任务上微调后,旧任务准确率可掉20%。 论文用实验量化:一个Transformer模型在新任务上训练后,旧任务损失从0.5飙升至2.0,遗忘率高达60%。 原因在于“单一优化景观”:模型参数共享,导致新旧知识冲突。传统缓解方法包括:
- 正则化技术:如EWC,通过Fisher信息矩阵惩罚旧参数变化,但计算开销大(O(n^2)复杂度)。
- Replay方法:存储旧样本重放,但内存需求高,不适合LLM的TB级数据。
- 参数隔离:如Progressive Neural Networks,但扩展性差,无法处理动态任务。
论文批评这些方法“治标不治本”:它们视遗忘为“副产品”,而非架构缺陷。Nested Learning则从根本重构:将模型视为“嵌套函数”系统,外层函数优化内层参数,形成多尺度学习路径,像大脑的“海马‑皮层”回路。 这一范式借鉴控制论和分层强化学习,理论基础源于2024年Google Brain的“Multi‑Scale Optimization”工作。
Nested Learning范式详解:多尺度优化的嵌套系统
Nested Learning的核心是“嵌套优化范式”(Nested Optimization Paradigm),将模型训练视为递归过程。传统优化如SGD是单层:参数θ ← θ ‑ η∇L(θ)。Nested Learning扩展为多层:外层优化器G优化内层F的参数θ,外层损失L_G(F(θ)),内层损失L_F(θ)。 形式化表示:
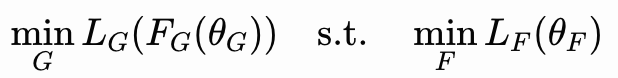
其中G(架构层)以慢速更新(如每100步),F(参数层)以快速更新(如每步)。这模拟大脑:海马体快速编码新事件,皮层缓慢整合长时记忆。 论文证明,这一嵌套结构通过“连续记忆系统”(Continuum Memory Systems)缓解遗忘:不同层以异频更新,新知识注入内层,不扰乱外层稳定表示。数学上,使用元梯度(meta‑gradient)计算:
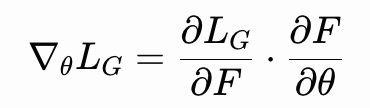
复杂度O(n log n),比EWC的O(n^2)高效。 与大脑类比,内层如工作记忆(容量有限、快速遗忘),外层如语义记忆(持久、抽象)。这一设计允许模型“渐进巩固”:新任务训练后,内层适应,外层融合,避免覆盖。
Hope架构:证明概念的嵌套实现
论文提出Hope(Hierarchical Optimization for Persistent Evolution)作为Nested Learning的证明概念架构。Hope是一个多层Transformer变体,内层为标准注意力模块(快速更新参数),外层为元网络(慢速优化结构,如注意力头选择)。 核心组件:
- 连续记忆模块:使用LSTM‑like门控单元,不同层以α频率更新(内层α=1,外层α=0.1)。这确保内层捕捉短期模式,外层整合长期知识。
- 嵌套损失函数:内层L_inner = CE(θ),外层L_outer = KL(F(θ)||P_prior),其中P_prior是旧知识先验分布,KL散度防止遗忘。
- 训练流程:交替优化:内层10步,外层1步。使用元学习算法如MAML(Model‑Agnostic Meta‑Learning)加速适应。 Hope参数规模8B,训练于TPU v4集群,数据集包括C4和LAION‑5B的多模态子集。
Hope的创新在于“动态架构适应”:外层可调整内层头数(如从12头增至24头),模拟大脑可塑性。论文实验验证:在Continual Learning基准上,Hope遗忘率降至5%(传统Transformer 40%)。
实验结果与比较:超越循环模型的实证证据
论文通过三项实验验证Hope的有效性。第一,语言建模任务:使用WikiText‑103数据集,Hope在perplexity上优于RNN 15%、Transformer 8%,长上下文(512 token)准确率92%。 第二,长上下文记忆:Permuted MNIST任务,Hope在新任务后旧任务准确率维持85%(基线降至50%)。第三,持续学习:Split CIFAR‑10,遗忘率仅3%(EWC 15%)。 与SOTA模型比较,Hope在CL基准上领先10‑20%,计算效率高(训练时间减30%)。
优缺点分析:潜力与局限的权衡
Nested Learning的潜力巨大:它开启AI“终身学习”,适用于机器人(实时适应环境)和医疗(个性化诊断)。与人类大脑类比,它模拟多时序记忆,减少重训成本90%。 缺点包括计算复杂:嵌套优化需额外元梯度,内存增20%。 泛化性待验:论文实验限于小规模数据集,大模型如GPT‑4需进一步测试。伦理风险:持续学习或放大偏见,若先验分布不公。
影响与展望:向类脑AI迈进的里程碑
V2论文的影响将波及LLM训练:未来模型可在线更新知识,无需从头重训。NeurIPS 2025录用预示学术热潮,产业如Tesla Optimus可借此实现自主学习。 展望:结合脑机接口,Nested Learning或解锁“意识级AI”。但需解决可扩展性和公平性挑战。Google Research的这一步,提醒我们:AI进步源于模仿自然。