
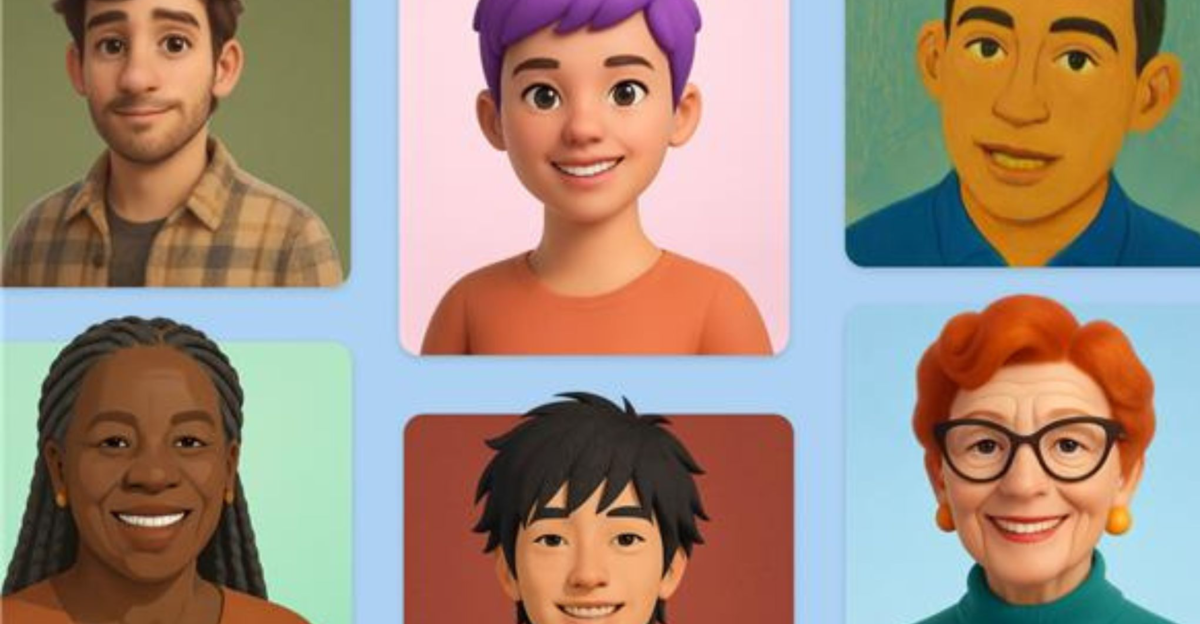
2025年9月24日 —— 微软在 Copilot Labs 中发布了一项名为“Portraits”的实验,让 Copilot 拥有可视化、会动的“面孔”,用户可以通过界面直接与动画头像对话。微软在演示中展示了数个风格各异的人像:有人物皱眉、点头、以同步的口型回答问题,也有更卡通化、色彩丰富的版本,目标是让 AI 助手看起来更“可接近”。
该实验并非简单的静态头像替换:肖像会根据对话情绪调整表情和眼神,讲话时配合口型与微表情,背景和灯光也可在设置中微调。微软将这些人像归类为 Copilot Labs 的“实验工具”,目前仅对部分用户开放测试,界面里同时保留传统的文字和语音输入选项。
在技术细节上,微软并未公开全部实现细节,但描述显示系统结合了其生成式模型对面部动作的预测、实时语音到口型的映射,以及对表情强度的控制。团队特别提到避免直接克隆真实个人面貌:生成头像基于合成样本和参数化控制,而非从特定真人视频中截取或微调现有人物图像。
微软同时给出使用与隐私说明:生成的人像可关闭,用户可选择不启用带脸的对话界面;微软将在收集用户反馈时进一步调整体验和安全策略。The Verge 报道指出,即便如此,这类“会说话的脸”仍可能触及公众对深度伪造(deepfake)与拟真伦理的敏感神经——当 AI 面孔越来越逼真时,界面设计、用途限制与透明标注变得尤为重要。
产品层面,Portraits 的目标是改善人与 AI 交互的第一印象。微软认为,比起单纯文字或机器音箱,带有情绪和视觉反馈的头像能让复杂指令沟通更直观。例如在教学、客服或辅助性对话场景,头像通过眼神与表情提示用户注意要点,或在多轮问答中用非语言信号强化回应的语气。
但现场测试也暴露一些问题:在镜头角度切换或网络波动时,表情过渡会显得僵硬或不同步;某些合成表情落入“诡异谷”(uncanny valley),反而削弱了信任感。The Verge 在文章中称,微软目前用迭代方式改进细节,并鼓励测试者报告“不自然”的表情和时序问题。
微软的这一步并不孤单:多家公司都在探索将视觉化人物与语音、文本结合的交互模型。不同的是,微软把 Portraits 放在 Copilot Labs 中,明确定位为试验性功能,下一步能否进入广泛推送,将取决于技术成熟度与监管、伦理审查的进展。
对年轻用户而言,头像化的 Copilot 有潜力把冷冰冰的 AI 变成“数字伙伴”——符合社交化、拟人化的使用习惯;但它也要求厂商在设计时更慎重地把握拟真度、个性化与透明度三者的平衡。微软表示,将根据在 2025 年秋季的测试反馈调整产品路线,并公开更多细节。