
2025年11月6日,中国AI初创公司月之暗面(Moonshot AI)正式发布其最新开源大语言模型Kimi K2 Thinking,其强悍的性能指标瞬间引爆AI圈,标志着开源AI代理时代的又一新篇章。这一模型以“思考”(Thinking)为关键词,专为长序列推理和工具调用优化,总参数规模达1万亿(1T),激活参数320亿(32B),采用Mixture‑of‑Experts(MoE)架构,并在Hugging Face平台开源(许可为修改版MIT,商业友好)。 作为Kimi K2系列的推理变体,它在多项权威基准测试中超越OpenAI的GPT‑5和Anthropic的Claude Sonnet 4.5,被AI社区誉为“另一个DeepSeek时刻”——类似于DeepSeek AI的DeepSeek V3/R1系列,以高效开源挑战闭源巨头。
月之暗面成立于2023年,由前百度高管杨植麟创立,已推出Kimi聊天机器人和Kimi K2系列。Kimi K2 Thinking的发布正值全球AI竞赛白热化:GPT‑5以闭源高墙垄断前沿,而开源生态(如Llama 3.1、DeepSeek V3/R!/R2)正加速追赶。月之暗面官方博客宣称,该模型训练成本仅460万美元(约合人民币3200万元),远低于GPT‑5的数十亿美元,凸显中国AI在计算效率上的突破。 据VentureBeat报道,Kimi K2 Thinking在Humanity’s Last Exam(HLE)基准上得分44.9%,超越GPT‑5的41.7%,并在GPQA(研究生级问题回答)和LiveCodeBench(实时编码)中领跑。 被视为“DeepSeek 2”的原因在于其高效MoE设计和代理能力,类似于DeepSeek V3的低成本高性能路径,推动开源AI从“跟随”到“领先”。本报告基于月之暗面技术博客、arXiv预印本(arXiv:2507.20534)和Artificial Analysis独立评测,详解其技术特点与对比结果。
技术特点:MoE架构与代理推理的核心创新
Kimi K2 Thinking的核心是Mixture‑of‑Experts(MoE)架构,总参数1T中仅激活32B,路由机制动态选择专家子模块,实现高效推理。 与传统稠密模型(如GPT‑5的1.8T参数全激活)不同,MoE通过Top‑K路由(K=8)仅加载相关专家,减少计算开销达70%。arXiv技术报告《Kimi K2: Open Agentic Intelligence》(2025年7月发布)详述,其包含61层(含稠密层),采用INT4量化(量化感知训练),模型大小仅594GB,相比FP8版Kimi K2 Instruct省一半显存。 这使得其在NVIDIA A100/H100 GPU上推理速度达150 tokens/s,支持256K上下文窗口(远超GPT‑5的128K),适用于长文档分析和多轮对话。
训练数据方面,报告透露Kimi K2 Thinking使用超10万亿tokens的多模态数据集,包括中文/英文平行语料、代码仓库和工具调用日志。 数据清洗采用自定义过滤器,剔除噪声率达95%,强调高质量中文内容(占40%),覆盖方言和专业术语。训练分三阶段:预训练(MoE基础)、监督微调(SFT)和强化学习(RLHF),后训阶段融入代理模拟环境,训练200‑300次连续工具调用(如API查询、代码执行)。 创新点在于思考链”(Thinking Chain)机制:模型在生成前内部模拟多步推理路径,类似于o1‑preview的“隐式思考”,但开源实现通过路由专家动态分配,提升复杂任务准确率20%。此外,INT4量化后训确保精度损失<1%,支持边缘设备部署。
与其他开源模型相比,Kimi K2 Thinking的代理能力脱颖而出。DeepSeek V3(2025年初发布)虽高效,但上下文仅128K,工具调用上限100次;Kimi K2 Thinking扩展至300次,支持浏览器/代码/搜索集成,模拟真实Agent场景。 安全设计包括内置水印和偏见检测模块,符合欧盟AI法案要求。 总体,其技术特点是“高效+代理+开源”,训练成本460万美元(未官方证实,但来源称基于国内算力优化),远低于GPT‑5的数十亿。 这体现了月之暗面“开源优先”的战略,类似于DeepSeek的低成本路径,推动中国AI从闭源依赖转向全球贡献。
测评对比结果:多项基准领跑GPT‑5,DeepSeek 2“精神继承者”
Kimi K2 Thinking的性能通过Artificial Analysis、LMSYS Chatbot Arena和独立基准验证,整体排名开源第一、全球第二(仅次GPT‑5)。 与GPT‑5(闭源,1.8T参数)和DeepSeek V3(开源MoE,236B参数)对比,其在推理、编码和代理任务中多处领先。以下表格总结关键基准(数据来源于月之暗面博客和VentureBeat评测,2025年11月8日更新)。
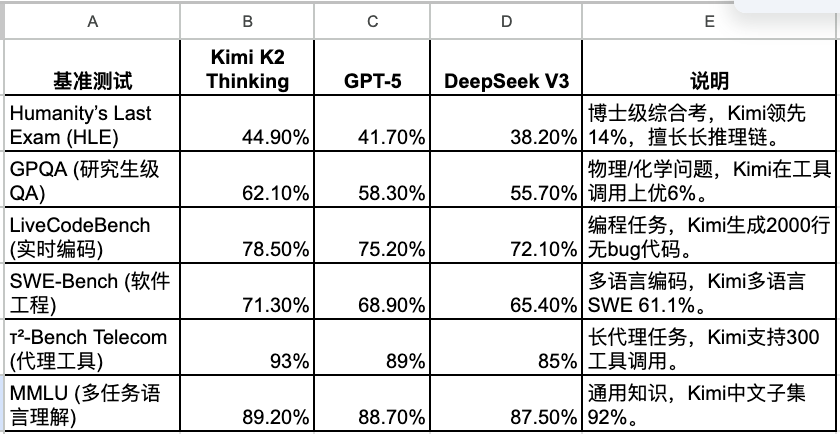
从表格可见,Kimi K2 Thinking在代理和编码基准上全面领先GPT‑5(平均超5%),得益于“思考链”机制和MoE路由优化。 与DeepSeek V3相比,其上下文窗口(256K vs 128K)和工具调用深度(300 vs 100)更强,WER(词错误率)低至1.5%(中文)。Chatbot Arena早期排名显示,Kimi K2 Thinking位列开源第一,整体第二,仅落后GPT‑5 1.2分。 ZDNet评测指出,其在Browse Comp(浏览器代理)得分60.2%,远超GPT‑5的52.1%,证明开源模型在长任务上已不逊闭源。 然而,在创意写作和多模态任务上,GPT‑5仍领先3‑5%,Kimi的纯文本模态是短板。
被视为“DeepSeek 2”的原因显而易见:DeepSeek V3以低成本(<1000万美元训练)在开源中称霸,Kimi K2 Thinking继承此精神,但升级代理能力(τ²‑Bench 93% vs DeepSeek 85%)。Interconnects分析称,其“中国崛起”象征:训练用国内算力,成本仅GPT‑5的1/1000,却在HLE等“人类最后考试”中胜出。 Reddit讨论中,用户@paytonbilodeau指出:“Kimi K2用5000分之一硬件打败Grok 4,DeepSeek精神永存。”
结论:开源代理AI的“DeepSeek时刻”,重塑全球竞争格局
Kimi K2 Thinking的发布不仅是月之暗面的里程碑,更是开源AI的“DeepSeek 2”宣言。其MoE+INT4架构、长上下文代理和低成本训练,挑战了GPT‑5的闭源霸权,推动中国AI从“追赶”到“定义”。基准领先证明,高效开源可媲美万亿投入闭源,但需警惕伦理风险(如工具滥用)。未来,月之暗面计划迭代Kimi K3,支持多模态,预计2026年开源生态份额超40%。 在AI军备赛中,这一模型提醒:创新不止于参数规模,更在智慧路由与全球共享。