
2026年3月16日,Moonshot AI(月之暗面)旗下Kimi团队在GitHub正式开源《Attention Residuals》(注意力残差,简称AttnRes)技术报告与代码仓库。这一创新被业内迅速称为“将注意力旋转90度”的突破性设计:它彻底重构了Transformer架构中最基础却长期被忽视的残差连接(Residual Connection),将传统“简单相加”升级为“深度注意力选择性聚合”。实验数据显示,在相同计算量下,AttnRes可实现1.25倍计算优势(相当于节省约20%算力即可达到基准性能),在MMLU、GPQA‑Diamond等关键基准上均有显著提升。这一成果不仅直接应用于Kimi Linear系列模型,更被OpenAI前研究员Jerry Tworek称为“深度学习2.0”时代的开端。
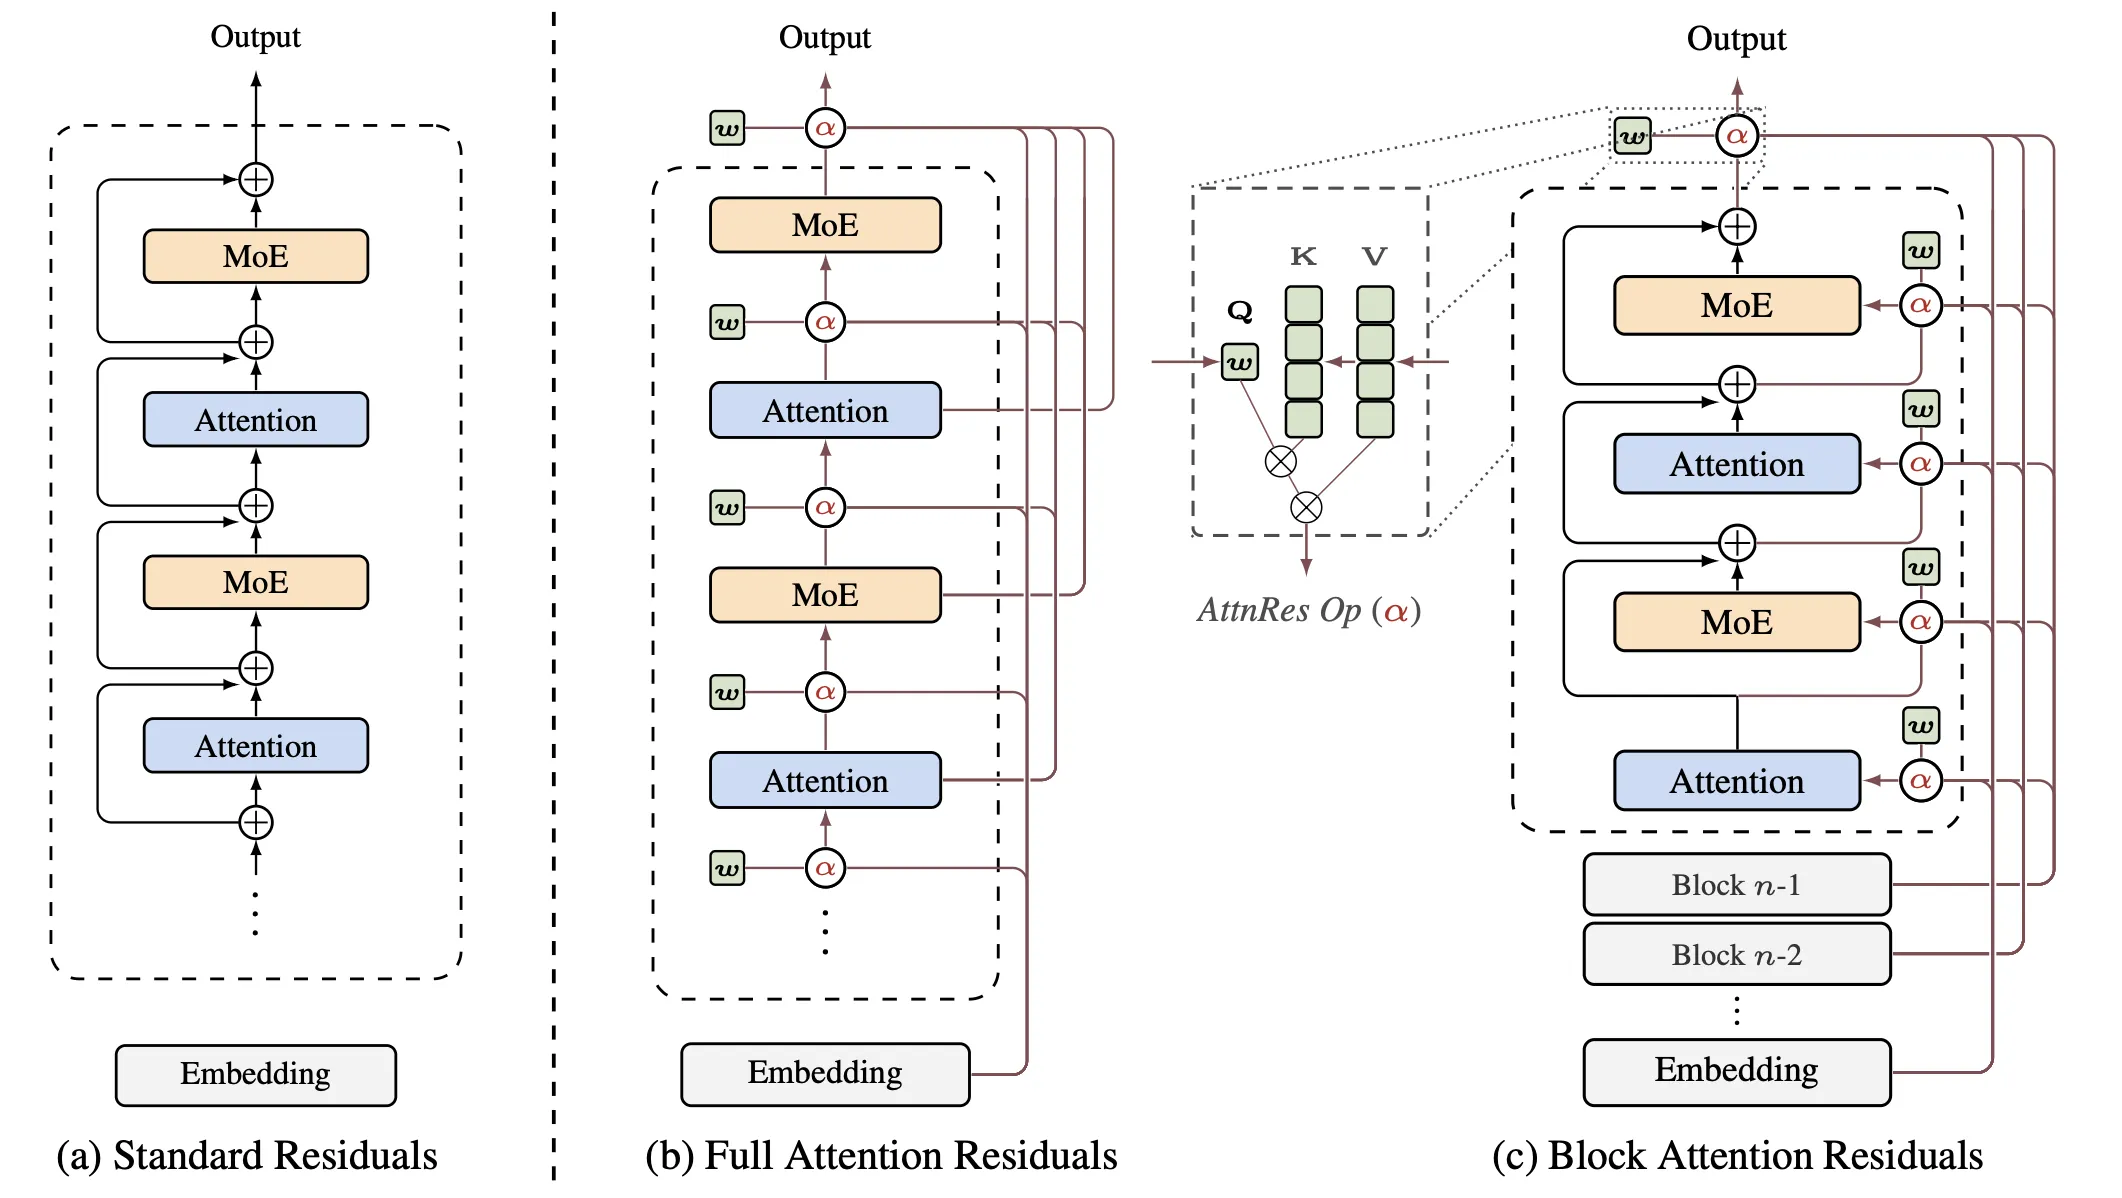
残差连接的先天难题:从ResNet到Transformer的共同痛点
残差连接最早由ResNet(2015年何恺明团队提出)引入CNN,用于解决深层网络的梯度消失问题,公式简洁为 y = x + f(x)。Transformer继承了这一设计,却在百亿甚至万亿参数规模下暴露致命缺陷:信息稀释与隐藏状态爆炸。
传统残差是“无条件累加”——每一层都均匀叠加前一层输出。随着深度增加(L层),浅层特征被后期层“稀释”,早期关键信息(如长序列中的关键token)逐渐被淹没。同时,为维持信号强度,模型不得不增大隐藏状态激活值,导致训练不稳定、内存开销激增。这正是深层MoE模型(如Kimi Linear、DeepSeek‑V3风格)在长上下文、复杂推理任务中表现瓶颈的核心原因。
Kimi团队的AttnRes彻底颠覆了这一机制:每一层不再盲目相加,而是发射一个可学习的Query,对所有先前层的Key进行注意力匹配,通过Softmax权重动态选择并聚合“有用”的历史表示。论文形象描述为“将注意力机制旋转90度”——原本注意力在序列维度(时间),现在扩展到深度维度(层级)。这让第50层能直接以0.8权重关注第2层,而非通过层层衰减传递。
技术核心:AttnRes与Block AttnRes的双重设计
AttnRes的核心是“输入依赖的深度注意力聚合”:
- 每层产生Query,与此前所有层的Key计算注意力。
- Softmax权重决定聚合比例,实现“智能过滤”。
- 完全兼容现有Transformer/MoE框架,作为drop‑in替换,无需改动其他组件。
为解决全注意力带来的内存复杂度O(L·d)(L为层数,d为维度),团队提出Block AttnRes:将模型分成N≈8个块,每块内部使用AttnRes,块间保留传统残差。实验证明,N=8即可捕获95%以上增益,内存复杂度降至O(N·d),推理延迟增加不到2%。
这一设计在Kimi Linear(混合专家MoE Transformer,激活参数3B‑48B规模)上验证:训练1T token后,AttnRes变体的验证损失曲线全程低于基准,梯度分布更均匀,隐藏状态增长被“周期性”而非“单调爆炸”控制。
实测数据:1.25倍计算杠杆与全面性能跃升
论文在5种不同规模模型上对比三种变体(PreNorm基准、Full AttnRes、Block AttnRes):
- 计算效率:在5.6 PFLOP/s‑days计算量下,Block AttnRes损失1.692(基准1.714),拟合曲线显示1.25倍计算优势。达到相同性能,AttnRes只需约80%算力。
- 基准提升(相同计算预算):
- MMLU:+1.1
- TriviaQA:+1.9
- GPQA‑Diamond(高难度科学推理):+7.5
- Minerva Math:+3.6
- HumanEval(代码生成):+3.1
- 长序列与多步推理任务表现尤为突出,证明AttnRes有效缓解信息稀释。
随着模型规模增大,Full与Block变体差距缩小,Block AttnRes成为工程最优解。团队强调:“即使上百层模型,也只需分成8个块,就能获得绝大部分收益。”
开源落地与行业影响:从Kimi到全行业
Moonshot AI已将AttnRes集成到Kimi Linear系列,并开源完整代码与论文(GitHub: MoonshotAI/Attention‑Residuals)。开发者可零成本替换现有Transformer残差,立即获得效率与性能双提升。
这一创新引发全球热议:
- OpenAI前研究员Jerry Tworek在X平台评论:“深度学习2.0的时代即将到来——我们需要重新思考一切。”
- 社区认为AttnRes是“Transformer后残差时代的开端”,与此前Kimi Linear(线性注意力混合架构)、Mooncake KV缓存系统形成Moonshot“三驾马车”,共同将推理效率推向新高度。
- 与DeepSeek mHC、Meta等同期架构创新相比,AttnRes的亮点在于“极简却普适”——无需改变MoE路由或注意力内核,仅改残差即可获益。
对AI训练与推理的深远意义
AttnRes直接解决深层网络两大顽疾,为万亿参数模型开辟新路径:
- 训练侧:更稳定梯度、更低损失、更少算力需求,降低训练成本。
- 推理侧:结合Mooncake KV缓存,可进一步压缩内存、提升吞吐,尤其适合长上下文Agentic任务。
- 未来方向:论文暗示AttnRes可与线性注意力、MoE进一步融合,或许催生“原生深度注意力”新架构。
行业分析师指出,这标志着中国AI团队从“跟随算力军备”转向“架构创新降维打击”。在2026年算力成本仍居高不下的背景下,1.25倍效率优势意味着相同预算下模型性能可提升一个世代。
结语:残差连接的涅槃与AI架构革命
Kimi的注意力残差并非简单优化,而是对Transformer最基础模块的哲学级重构。它证明:即使在后Transformer时代,依然有被忽视的“低垂果实”。随着代码开源与Kimi模型迭代,这一技术有望迅速普及至全行业。
Moonshot AI再次以AttnRes证明:中国AI不仅在参数规模上追赶,更在底层架构创新上引领潮流。2026年,或许正是“深度学习2.0”从概念走向现实的起点。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com