
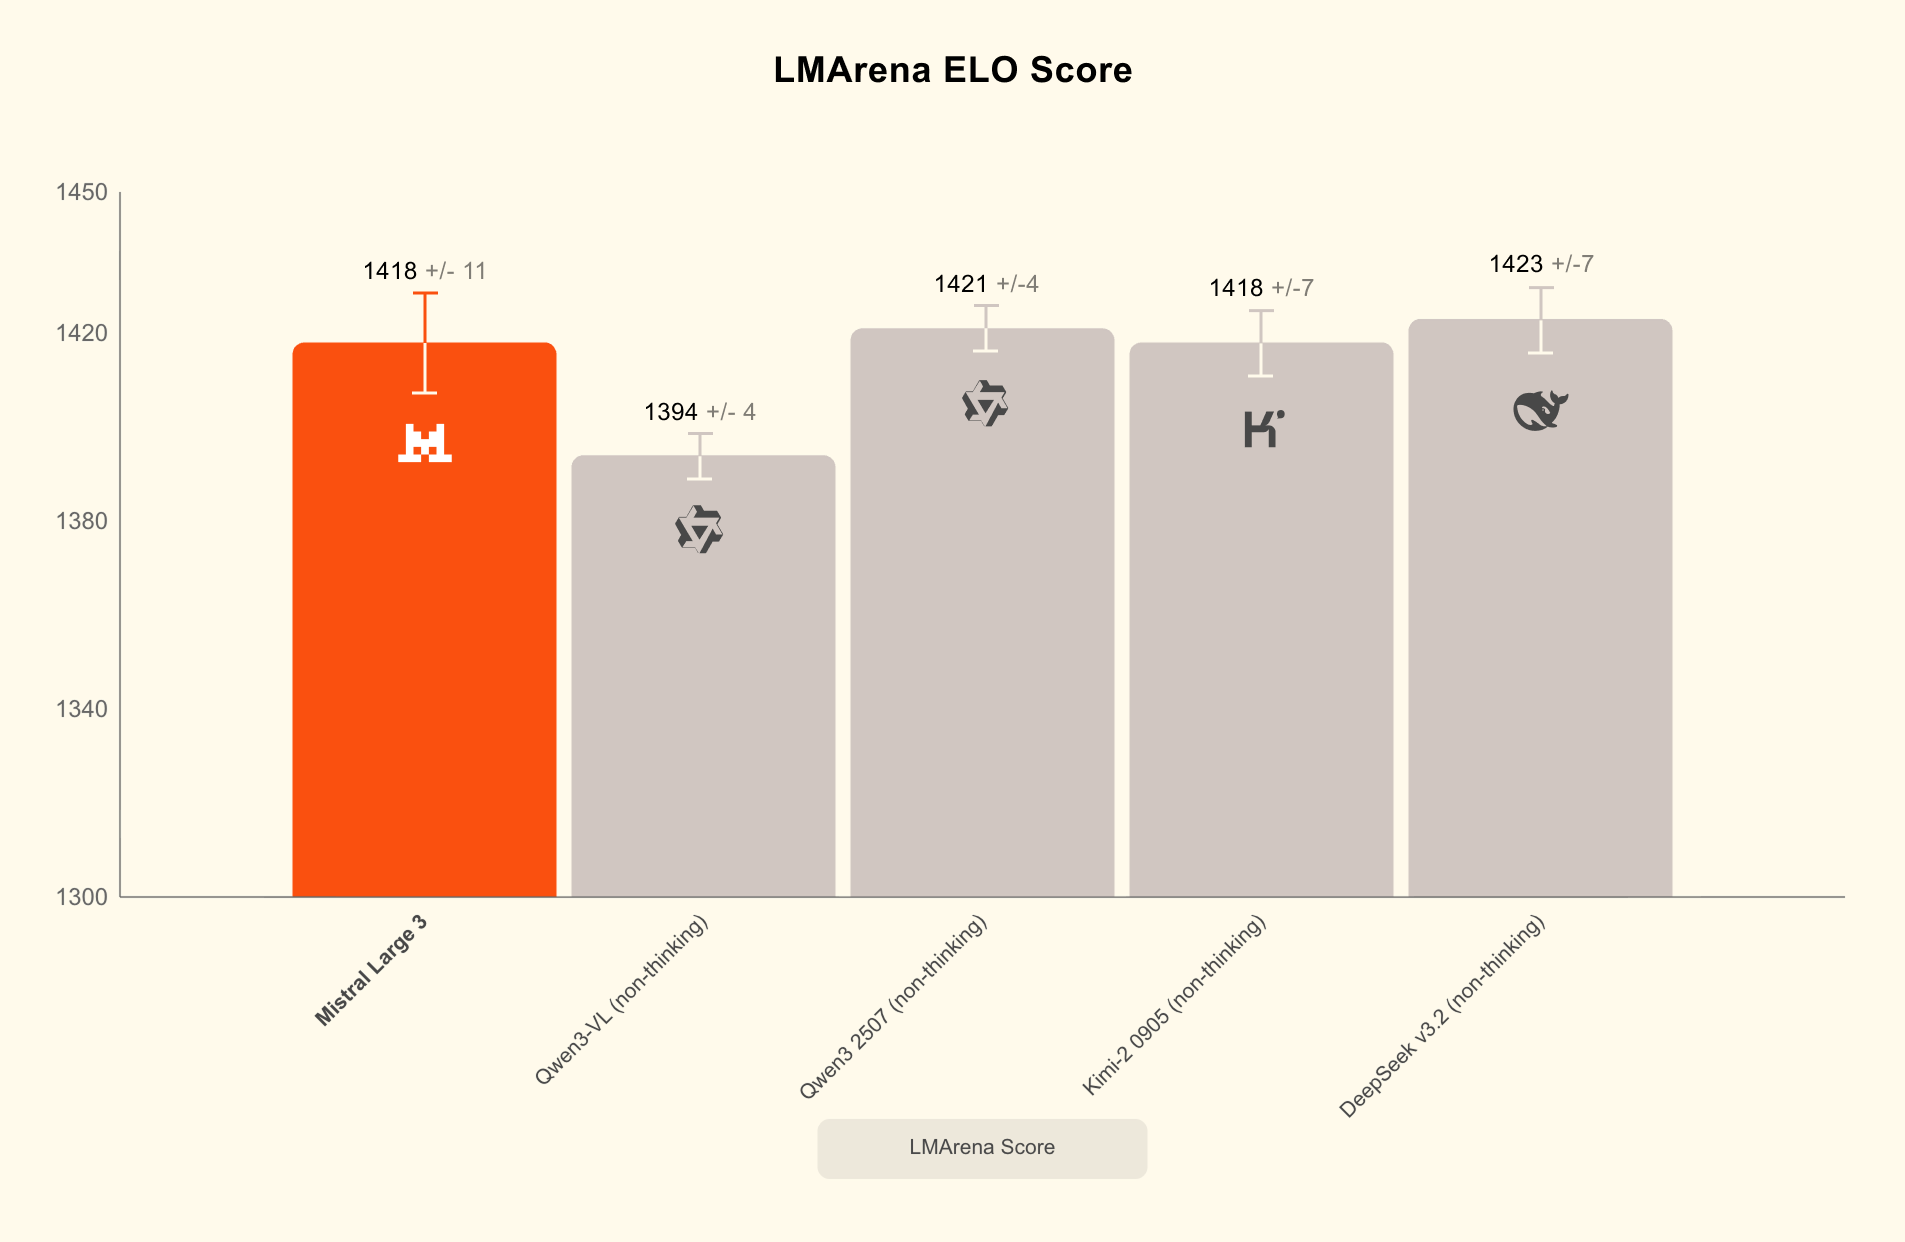
在中美两大大语言模型巨头相继发布版本更新的 2025 年底,第三股势力‑‑‑法国 AI 初创公司 Mistral AI 于 12 月 2 日重磅推出 Mistral 3 模型家族。这一发布包括旗舰级 Mistral Large 3——一款总参数达 6750 亿的稀疏混合专家(MoE)模型,以及九款高效 Ministral 3 小型模型,涵盖 3B、8B 和 14B 参数规模。 这些模型以 Apache 2.0 许可免费开源,支持多模态(文本+视觉)和多语言处理,旨在填补开源 AI 在企业级和边缘部署间的空白。Mistral 宣称,Large 3 在 LMArena 排行榜上位列开源非推理模型第 2 名(整体第 6 名),性能逼近 OpenAI 的 GPT‑4o 和 Google 的 Gemini 2,同时成本仅为其 80%。 这一举措不仅彰显欧洲 AI 的独立野心,还可能颠覆依赖闭源 API 的行业格局,引发 VentureBeat 和 CNBC 等媒体的广泛热议。
Mistral 的这一步棋源于对“规模与效率”双重追求。公司成立于 2023 年,由前 DeepMind 和 Meta 研究员创立,仅两年即融资 27 亿美元,估值飙升至 137 亿美元——虽不及 OpenAI 的 5000 亿美元估值,但已跻身欧洲科技独角兽前列。 与美国巨头不同,Mistral 强调“开源优先”,避免“黑箱”依赖。Mistral 3 家族正是这一战略的巅峰:Large 3 采用细粒度 MoE 架构,总参数 6750 亿、活跃参数 410 亿,支持 256K 上下文窗口和视觉理解,专为文档分析、编码、内容生成和代理工作流优化。 训练过程耗费 3000 张 NVIDIA H200 GPU,聚焦非英语/中文多语言数据,确保全球适用性——公司声明,这让“数十亿非英语母语者”首次触及前沿 AI。 Ministral 3 则针对边缘计算,提供 Base(预训练)、Instruct(聊天优化)和 Reasoning(逻辑优化)三种变体,可在单 GPU、笔记本、机器人或无人机上离线运行,上下文窗口达 128K‑256K。 这些小模型虽初始基准落后闭源对手,但 Mistral 强调,经微调后可在企业场景中“匹配或超越” GPT‑4o 的效率。
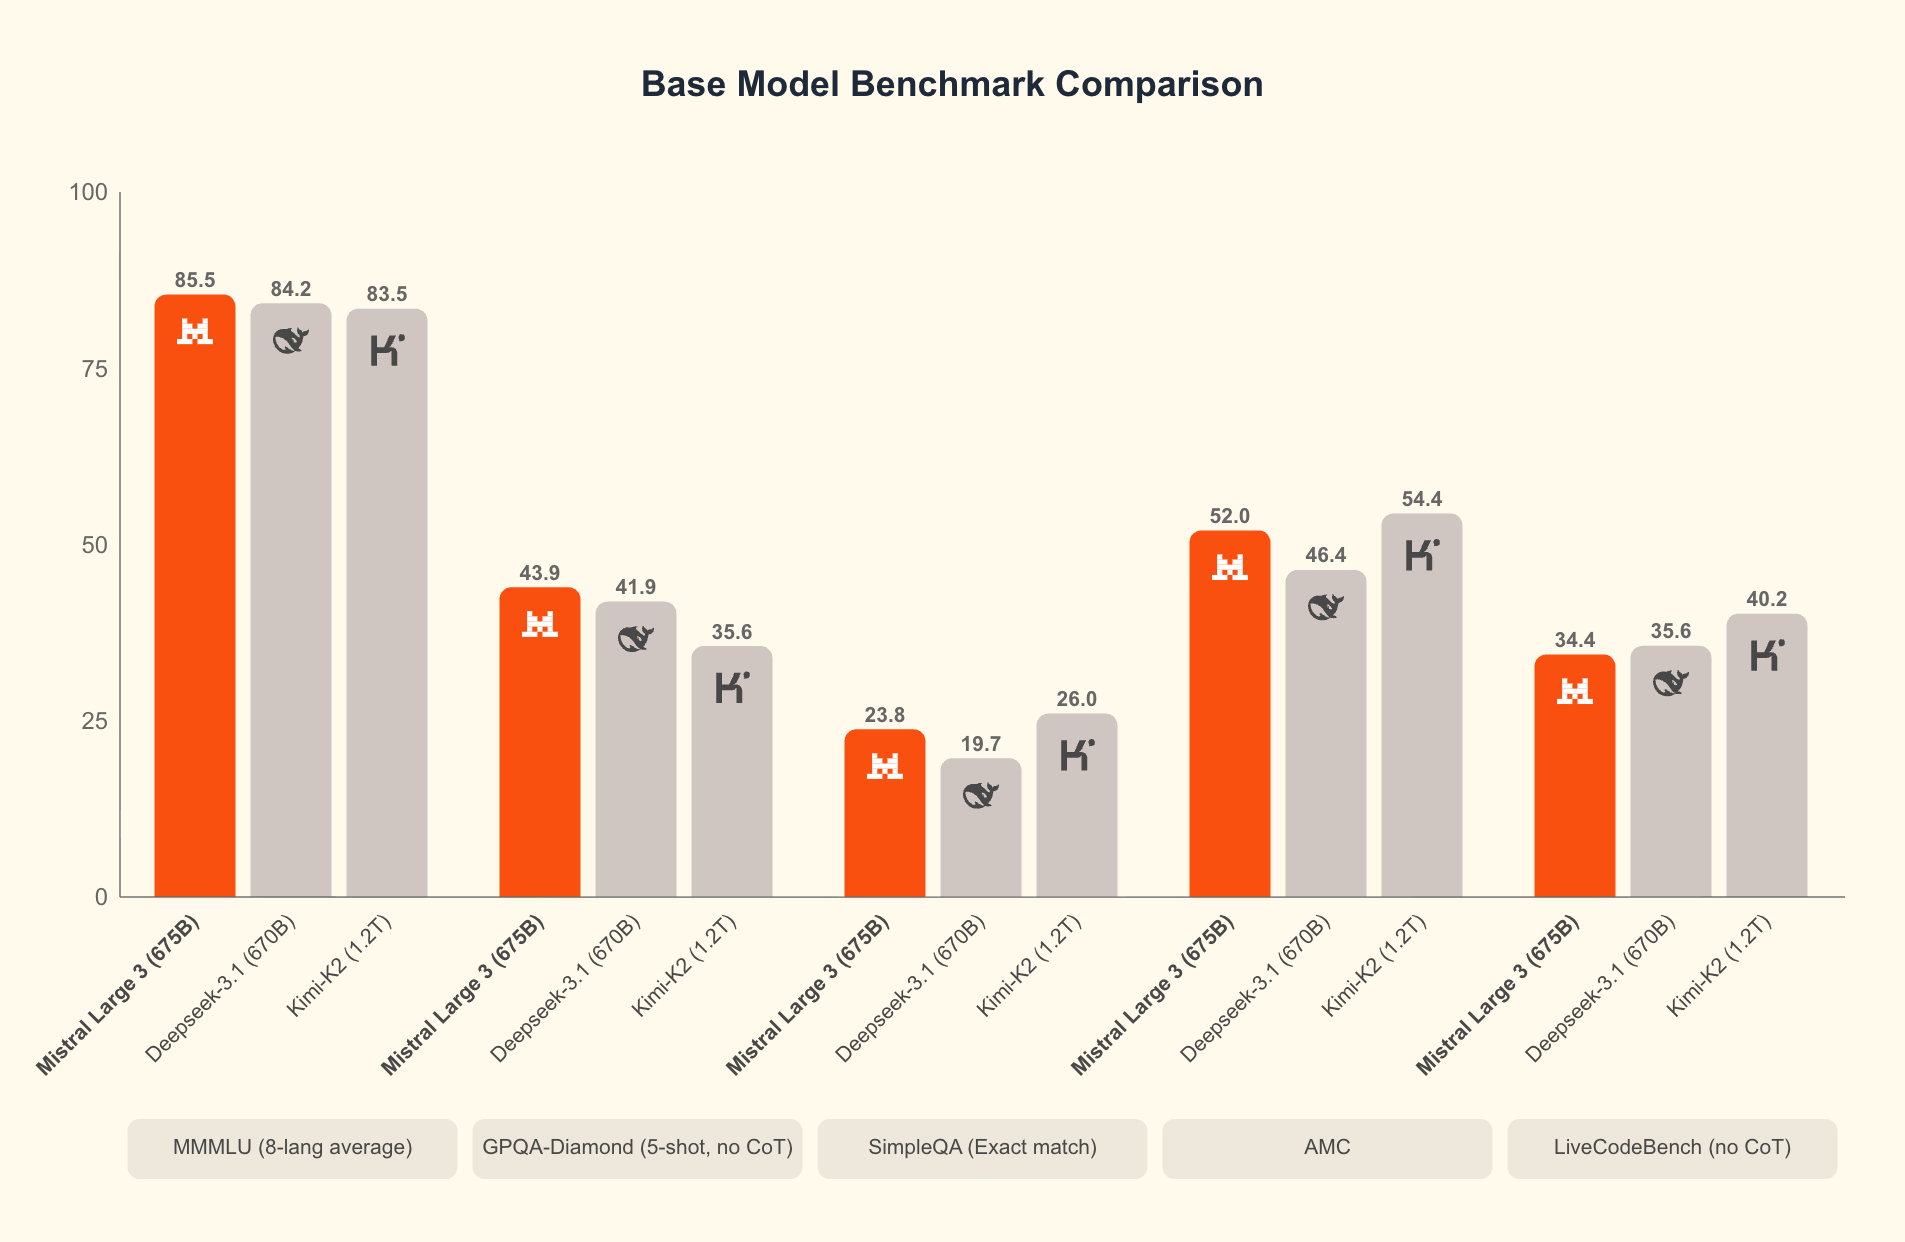
性能基准数据印证了 Mistral 的雄心。官方博客显示,Large 3 在通用提示上与顶级开源指令模型平起平坐,在图像理解和多语言对话中脱颖而出。 在 Artificial Analysis 的比较中,Large 3 与 GPT‑5.1 Codex mini(高配)在智能、价格、速度和上下文上展开角逐,前者以更低成本(输入 0.50 美元/百万 token,输出 1.50 美元/百万 token)取胜。 Medium 分析指出,Ministral 14B Reasoning 变体在 AIME 2025 数学竞赛上达 85% 准确率,领跑同规模开源模型。 与 Meta 的 Llama 3 和阿里巴巴的 Qwen3‑Omni 相比,Large 3 在多模态集成上领先,而 Ministral 3 的 token 生成效率更高,减少了 20‑30% 的计算开销。 GetBind 博客评估显示,在复杂推理和编码负载下,Mistral 3 家族虽需测试,但已适合混合基础设施的企业部署。 Hacker News 用户讨论中,有人称其“在实际应用中超越基准”,但也指出在重负载下的稳定性需观察。 NVIDIA 开发者博客补充,Large 3 在 GB200 NVL72 上优化后,性能提升 10 倍,每兆瓦处理超 500 万 token/秒。
这一发布的技术创新不止于规模。Mistral Large 3 引入“后训练优化”,包括指令微调和强化学习,确保在代理任务(如检索增强生成 RAG)和科学工作流中高效。 Ministral 3 的视觉支持扩展至文档解析和图表分析,适用于机器人(如与新加坡 Home Team Science 合作的消防模型)和无人机(与 Helsing 的视觉‑语言‑行动集成)。 CNBC 报道,Mistral 视此为“全球 AI 可用性新标准”,解锁无网络场景的潜力。 与闭源模型的“API 依赖”不同,开源权重允许开发者本地运行,避免 OpenAI 每两周半小时宕机的风险。 联合创始人兼首席科学家 Guillaume Lample 在 TechCrunch 采访中直言:“客户起初青睐无需微调的大型闭源模型,但部署后发现其昂贵且缓慢,于是转向我们的小模型——往往能匹配甚至超越闭源性能。” 他强调,开源使命在于“确保 AI 不被少数大实验室垄断,尤其对无网用户”。
对行业而言,Mistral 3 加剧了“开源 vs 闭源”的拉锯战。2025 年,开源模型从“实验品”转向“生产力工具”:DeepSeek V3.2 和 Llama 3 已蚕食市场份额,但 Mistral 以欧洲视角突出多语言和隐私,避开中美数据壁垒。 X 平台上,用户 @PaternalPath 发帖称:“开源前沿升级了,Mistral 3 解锁设备端智能和多语言代理。” 另一帖 @NowadAIs 分享:“从 3B 到 675B,40+ 语言支持,80% 更便宜。” Reddit 的 r/LocalLLaMA 子版块热议比较图表,获数百赞。 然而,挑战犹存:Medium 指出,Large 3 在绝对智能上仍落后 GPT‑4o 和 Claude 3.5,尤其复杂推理。 VentureBeat 警告,新发布需真实世界基准验证,以防“宣传大于实际”。
业务影响深远。Mistral 与 Stellantis 合作车载 AI、与 Home Team 的机器人项目,扩展至物理 AI。 CNBC 分析,此家族“为企业代理工作流和边缘应用开启新可能”,预计 2026 年开源市场份额超 40%。 X 用户 @heardof_ai 总结:“开源 MoE 进入生产,代理可在自家基础设施运行。” 对于开发者,模型即刻在 Hugging Face 下载,支持 vLLM、llama.cpp 和 Ollama 部署。 未来,Mistral 计划发布 Large 3 的专用推理变体,进一步桥接闭源差距。
Mistral 3 的问世,不仅是技术跃进,更是开源精神的胜利。它证明,小型欧洲团队能以效率挑战巨头, democratize AI 从口号变现实。开发者蜂拥测试,这一“675B 魔盒”能否真正“追平” GPT‑4o?答案藏在社区评测中。但无论如何,AI 的“欧洲时刻”已至。
信息来源: