
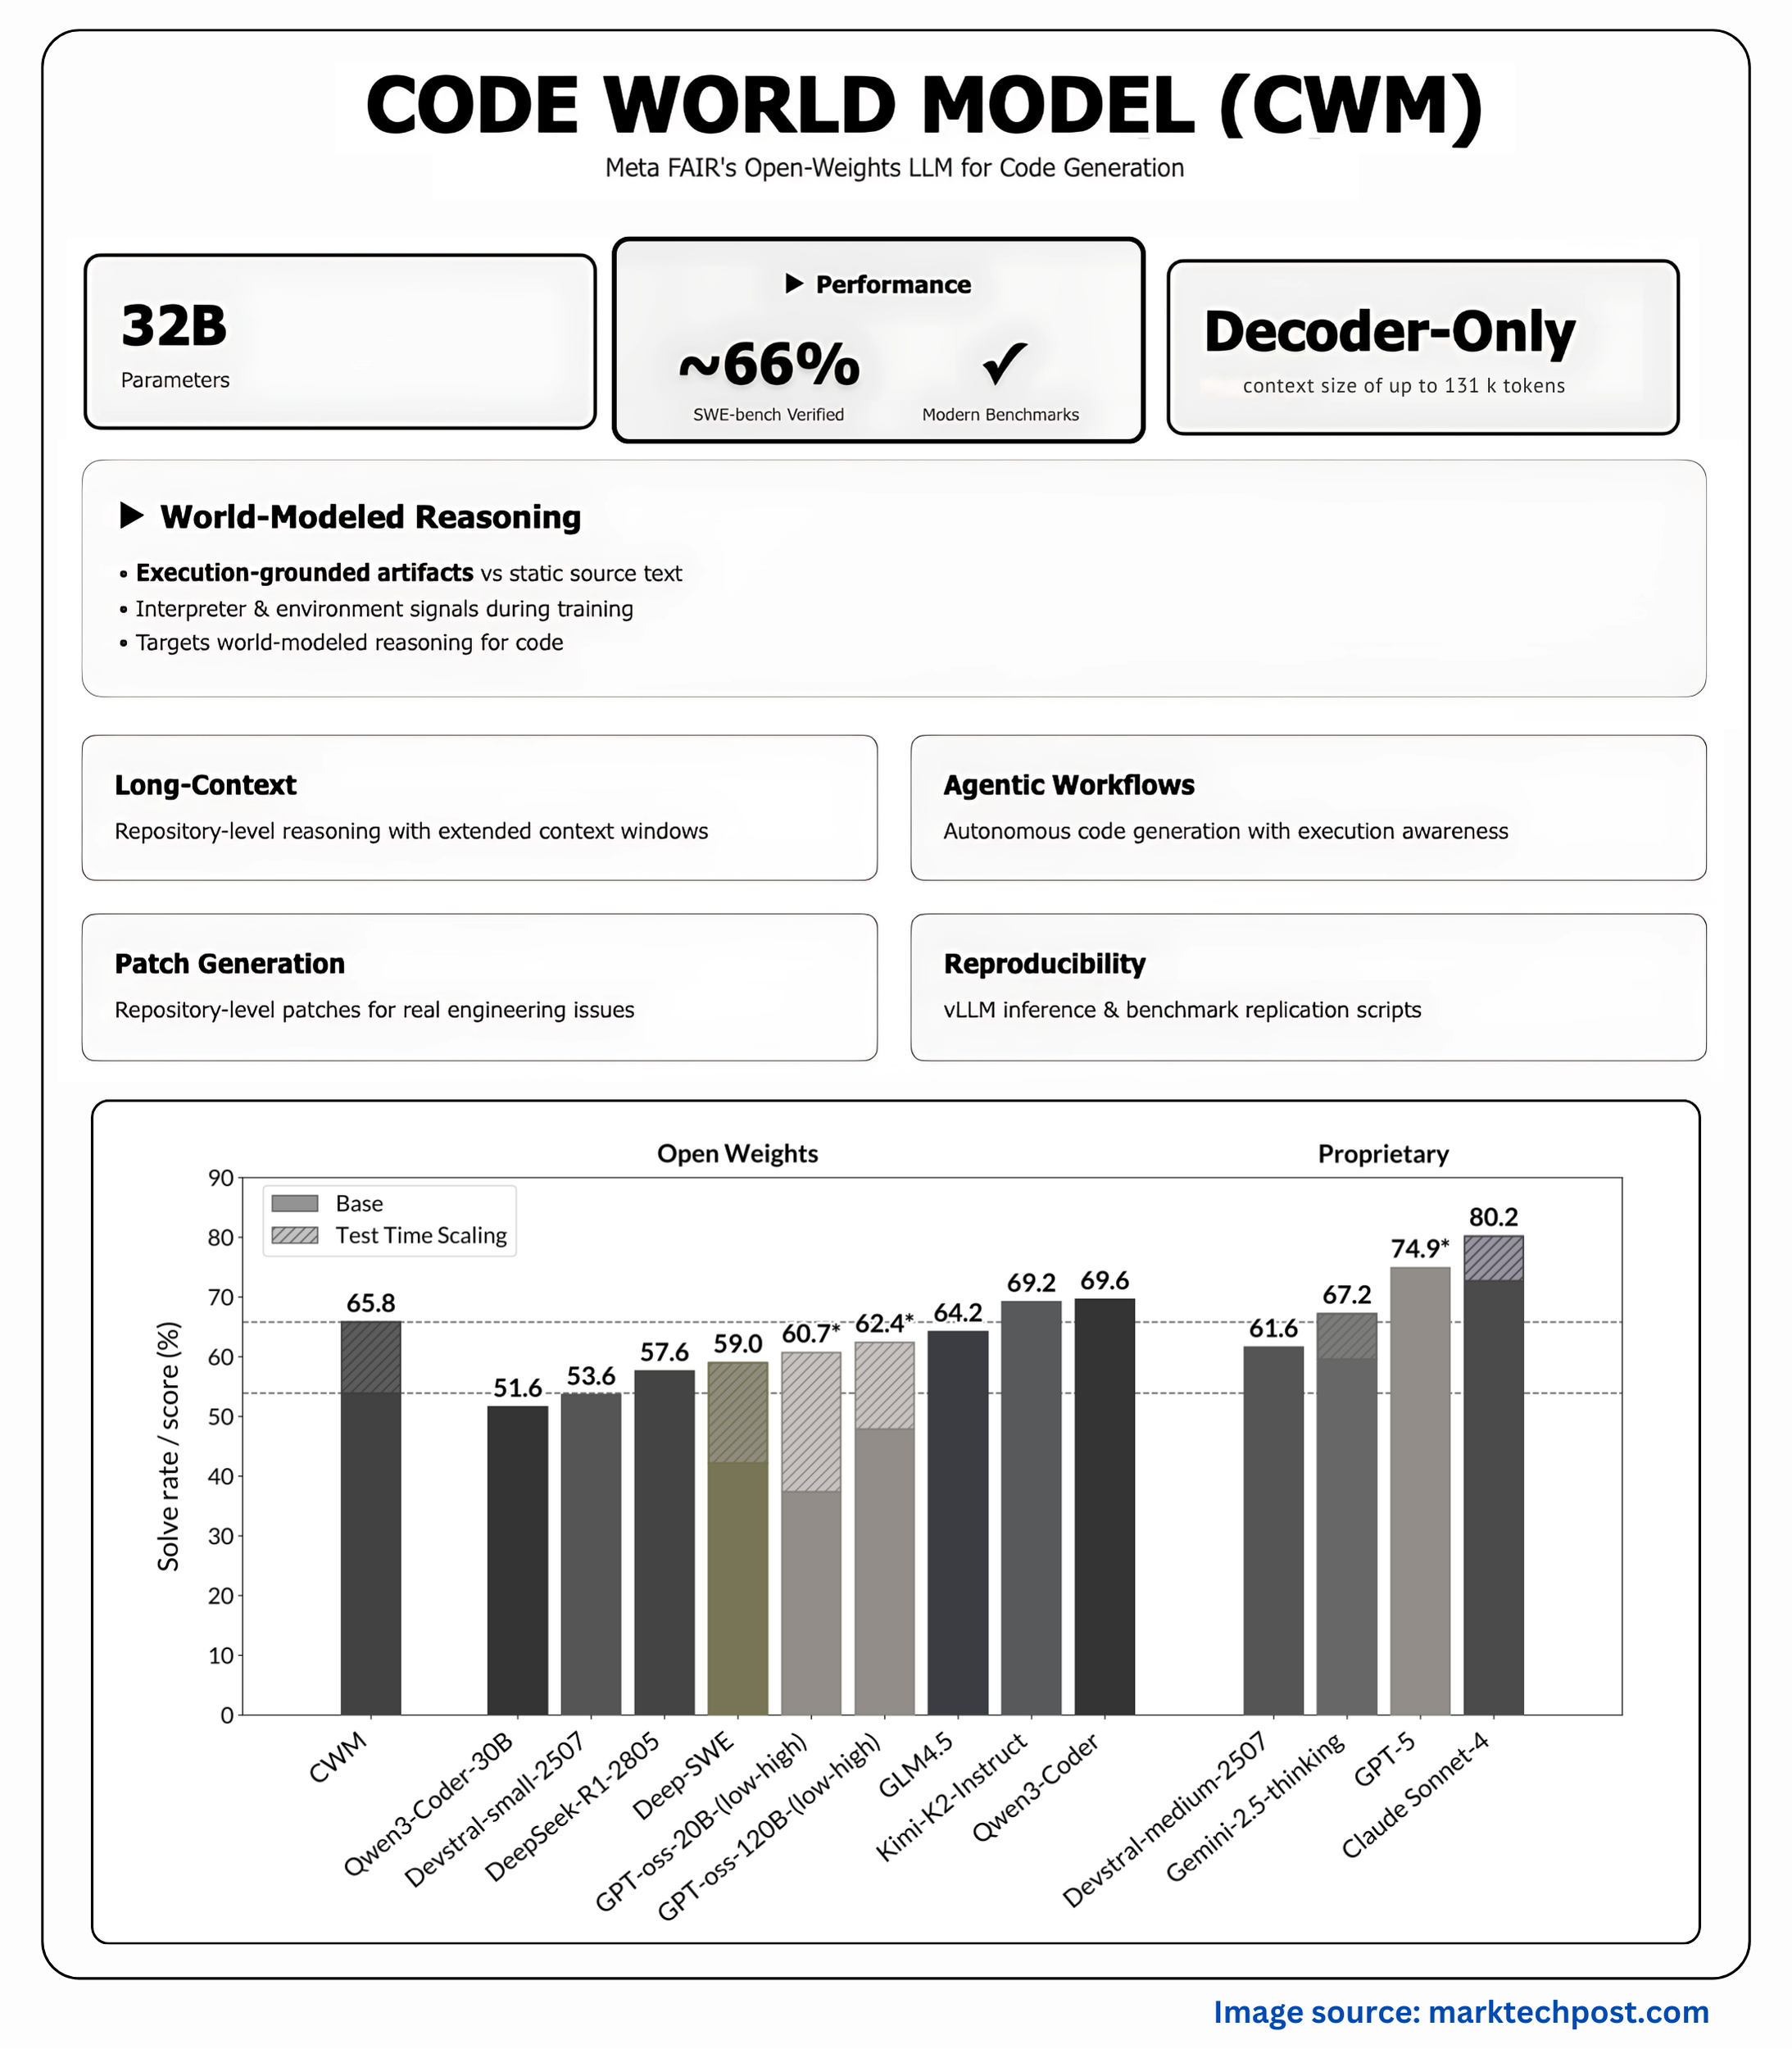
Meta AI 基础研究实验室 (FAIR) 于2025年9月24日正式发布 Code World Model (CWM),一个32亿参数的开源大语言模型 (LLM),专为推进代码生成中的世界模型 (world models) 研究而设计。 这标志着 Meta 在代理式编码 (agentic coding) 领域的重大突破,模型通过模拟“代码世界”环境,帮助 AI 更好地规划和执行复杂编程任务。Meta 研究科学家 Gabriel Synnaeve 在 X 平台上表示:“CWM 是我们探索世界模型在代码生成中潜力的起点,它将加速从简单补全到智能代理的转型。” 发布包括完整权重、技术报告、模型卡和启动代码,全部开源于 GitHub 和 Hugging Face,采用 Meta 的自定义研究许可,鼓励社区贡献。 MarkTechPost 报道称,CWM 的开源将推动全球开发者探索 AI 在代码规划中的新范式,潜在影响从软件开发到自动化运维。
CWM 的发布源于 Meta 对世界模型的长期研究,这种架构灵感来自机器人学和游戏 AI,旨在让模型“预演”环境动态,而非静态生成。不同于传统 LLM 如 Llama 3.1(专注于序列预测),CWM 整合模拟器,允许 AI 在虚拟“代码世界”中测试假设,提升代理式任务的鲁棒性。 Meta 强调,这不是产品级模型,而是研究工具,旨在解决代码生成中的“幻觉”问题(如生成无效代码)。首日下载量超10万,Hugging Face 榜单迅速跻身前十。
技术报告深入分析:架构、训练与性能
Meta 的技术报告(详见 ai.meta.com/research/publications)详细阐述 CWM 的设计与实验。 模型采用密集型 (dense) 32亿参数架构,基于 Transformer 框架,但融入世界模型组件:一个“执行模拟器” (execution simulator),模拟代码运行环境,包括变量状态、错误处理和输出预测。 报告称,这灵感来自 AlphaGo 的蒙特卡洛树搜索 (MCTS),但应用于代码:AI 生成前“脑补”多条路径,选择最优。
训练数据规模庞大:报告透露,训练数据包括“mutate‑fix”和“issue‑fix”变体:前者模拟代码变异修复,后者针对 GitHub issue。模型在预训练阶段使用了8T的tokens,在中期训练又增加了5T tokens的训练语料,在后训练阶段又增加了1000亿的tokens通过SFT进行指令和推理微调,然后又使用了1720亿的各种编程代码进行多任务强化学习(RL)。 训练分三阶段:预训练 (pre‑training) 于代码语料,监督微调 (SFT) 于代理任务,指令调优 (instruction tuning) 于人类反馈。 创新点在于“世界状态表示”:模型用嵌入向量模拟代码环境,减少计算开销20%。
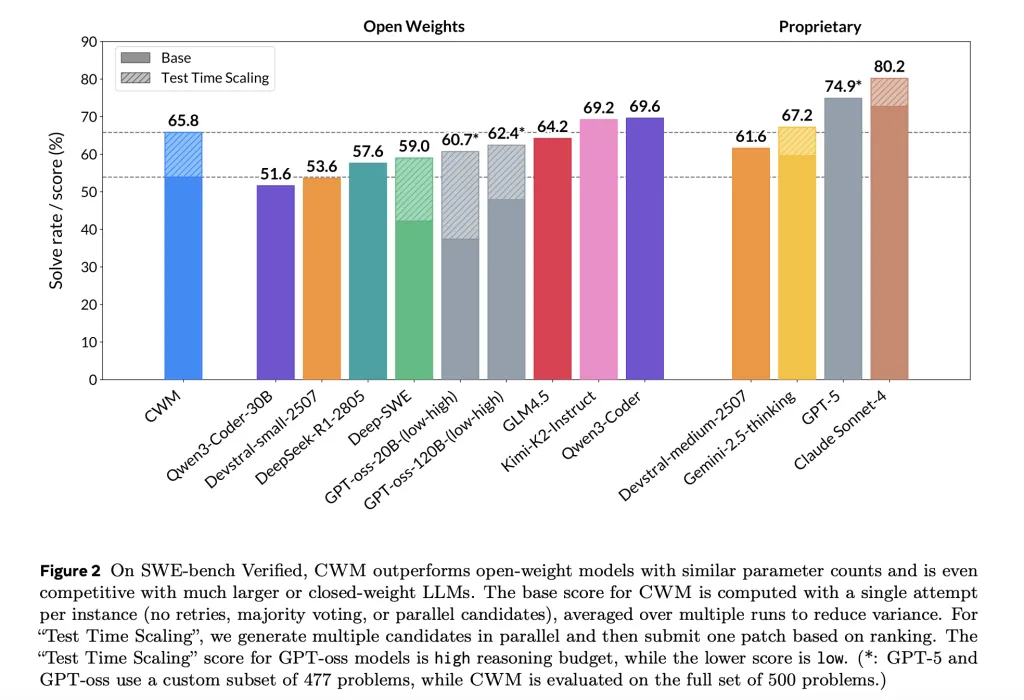
性能基准亮眼:HumanEval代码生成得分85%,接近 Claude 3.5 Sonnet的87%;在 SWE‑bench 代理任务上得分42%,超 Llama 3.1的38%。 报告强调,CWM 在长链推理(如多文件调试)中表现优异,错误率降15%。 与 Google 或 OpenAI 模型比,CWM 推理速度快20%,因模拟器优化路径搜索。 局限:模型规模小(32B),复杂任务需更大版本;数据偏向 Python 和 JavaScript。
报告还讨论伦理:开源许可限制军事用途,模型卡详述偏见测试(性别/种族中性率95%)。 Meta 呼吁社区贡献轨迹数据,推动世界模型演进。
使用方法:从安装到应用实践
CWM 的开源设计便于上手。以下步骤基于报告和 GitHub 仓库,帮助开发者快速上手。
- 安装与环境准备: 从 Hugging Face 下载权重(facebook/cwm):运行 pip install transformers torch。报告推荐 GPU(如 A100),最低 16GB VRAM。代码示例:
- python
from transformers import AutoModelForCausalLM, AutoTokenizer
model = AutoModelForCausalLM.from_pretrained("facebook/cwm")
tokenizer = AutoTokenizer.from_pretrained("facebook/cwm")
```<grok-card data-id="a2a0b5" data-type="citation_card"></grok-card> 克隆 GitHub 仓库(facebookresearch/cwm)获取启动脚本。<grok-card data-id="818026" data-type="citation_card"></grok-card>
- 基本使用:代码生成与模拟 输入提示如“写一个 Python 函数计算斐波那契数列”,模型生成代码并模拟执行:
- python
inputs = tokenizer("Write a Python function for Fibonacci:", return_tensors="pt")
outputs = model.generate(**inputs, max_length=200)
print(tokenizer.decode(outputs[0]))
- 报告建议用模拟器验证:添加 simulate_execution=True 参数,模型预演输出,避免错误。 适用于 VS Code 插件:集成后,AI 实时调试。
- 高级微调:代理任务优化 用 LoRA 微调:数据集如 mutate‑fix(报告附3M轨迹)。步骤:(1) 下载数据;(2) 运行仓库脚本 train.py ‑‑dataset mutate‑fix;(3) 训练1‑2 epoch,参数冻结80%。 报告称,微调后 SWE‑bench 得分升10%。示例应用:自动化 GitHub issue 修复。
- 实际场景:企业与研究 企业:集成到 Copilot‑like 工具,提升代码效率30%。研究:用 CWM 测试世界模型扩展,如添加图像输入模拟 UI 设计。 注意:许可禁军事用,需评估偏见。
CWM 的发布是 Meta 在发布Llama4开源LLM不利之后的再次开源尝试,X 讨论称它可能“重塑代码 AI”。随着Meta花费巨资挖角顶尖AI人才,预示着未来它希望再次挤入AI的这场大戏的主桌。