
2026年,本地部署大模型已成为开发者、研究者和企业的刚需。推理框架的选择直接决定相同硬件下的性能差异可达2‑6倍。近期多篇技术深度评测对主流框架进行了系统对比,本文综合权威测试数据与实际部署经验,对vLLM、SGLang、llama.cpp、MLX、Ollama五大框架进行全面解析,重点对比其基本原理、优缺点、适用范围,并以表格形式呈现直观对比。
一、五大框架核心原理概述
1. vLLM —— 分页注意力(PagedAttention)+ 持续批处理的生产级引擎
vLLM 是当前生产环境中使用最广泛的本地/云端推理框架。其最大创新在于PagedAttention机制,这一思想直接借鉴了操作系统虚拟内存的分页管理。
传统Transformer在推理时,KV Cache(键值缓存)会占用大量显存,而且所有请求必须等当前批次全部完成才能开始下一个批次,导致显存浪费严重(利用率常只有60‑80%)和吞吐量瓶颈。vLLM 将 KV Cache 切割成固定大小的“页”(pages,通常512‑2048 tokens),像操作系统管理内存一样动态分配和回收。这样,即使不同请求的序列长度差异很大,也能高效复用显存,显存利用率可提升至95%以上。
同时,vLLM 引入Continuous Batching(持续批处理):当一个请求完成时,立即将新请求插入执行队列,无需等待整个批次结束。这一机制极大提高了GPU利用率,尤其在高并发API服务场景下优势显著。
vLLM 支持 NVIDIA、AMD、Google TPU、Intel Gaudi等多种后端,生态成熟,集成简单。
开源仓库:https://github.com/vllm‑project/vllm
2. SGLang —— RadixAttention前缀树缓存的智能体框架
SGLang 由部分 vLLM 原班人马开发,是专为复杂交互场景设计的下一代推理框架。其核心创新是RadixAttention(基数树注意力缓存)。
传统框架在请求结束后通常立即丢弃 KV Cache,而 SGLang 使用树状数据结构(Radix Tree)将所有历史请求的前缀缓存持久化存储。当新请求到来时,系统会智能查找最长匹配前缀,直接复用已计算的 KV Cache,只计算新增部分。这在 RAG(检索增强生成)、多轮对话、AI Agent 等场景中效果爆炸。
例如,在企业知识库问答中,多用户查询同一份文档的不同段落时,SGLang 可大幅减少重复计算。官方测试显示,在高前缀命中率场景下,SGLang 相比 vLLM 可实现 3‑6.4 倍的加速。此外,SGLang 在结构化输出(JSON模式)和多代理协同方面也做了深度优化。
开源仓库:https://github.com/sgl‑project/sglang
3. llama.cpp —— 极致轻量与跨平台的GGUF原生引擎
llama.cpp 是由 Georgi Gerganov 单人主导开发的经典项目,被誉为“本地大模型的瑞士军刀”。其核心设计哲学是极致简洁与可移植性。
它采用纯 C/C++ 实现,几乎零外部依赖,支持从 2‑bit 到 FP16 的丰富量化方案。模型以 GGUF 格式存储,通过 mmap(内存映射)技术实现极快的模型加载——即使是 70B 模型也能在几秒内加载完成。它不依赖 CUDA、Metal 等特定框架,因此能在从树莓派、手机到服务器的几乎所有设备上运行。
llama.cpp 专注于单用户、高效单流推理,在资源受限环境下表现极为出色,但高并发能力相对较弱。
开源仓库:https://github.com/ggerganov/llama.cpp
4. MLX —— Apple Silicon统一内存原生框架
MLX 是苹果官方团队开发的框架,专为 Apple Silicon(M 系列芯片)的统一内存架构(Unified Memory) 量身定制。
传统框架在 GPU 推理时,需要频繁在显存和系统内存之间拷贝数据,而 MLX 直接让 CPU 和 GPU 共享同一物理内存池,避免了拷贝开销。同时,MLX 深度优化了 AMX 矩阵加速指令集,并采用 Lazy Evaluation(惰性计算)等技术,最大化带宽利用率。
在 M4 Max / M4 Ultra 等高内存设备上,MLX 的性能往往能甩开其他框架 1.5‑3 倍,尤其适合本地大模型实验和长时间运行的 Agent 场景。
开源仓库:https://github.com/ml‑explore/mlx
5. Ollama —— 最易用的本地大模型运行平台
Ollama 本身并非底层推理引擎,而是一个高度封装的本地运行时平台,底层主要基于 llama.cpp 实现。
其核心价值在于极致易用性:一行命令即可下载、运行和管理模型(ollama run llama3.1),同时提供 Web UI、OpenAI 兼容 API、本地模型管理、Modelfile 自定义等功能。它大大降低了本地部署门槛,让非专业开发者也能轻松在个人电脑上运行 70B 级模型。
Ollama 还支持自定义 Modelfile 来创建专属模型,并可切换不同后端(llama.cpp、MLX 等)。它更像“本地大模型的操作系统”,适合快速实验和日常使用。
开源仓库:https://github.com/ollama/ollama
二、性能与特性详细对比
vLLM:在NVIDIA H100上运行Llama 3.1 70B时,吞吐量领先,适合高并发生产环境。
SGLang:在多轮对话和RAG场景下性能最强,前缀命中率高。
llama.cpp:单卡推理效率极高,尤其在低资源设备上表现突出。
MLX:在M4 Max/M4 Ultra上性能碾压其他框架。
Ollama:易用性第一,但高并发吞吐量明显弱于vLLM和SGLang,更适合个人和小型团队使用。
三、五大框架对比表
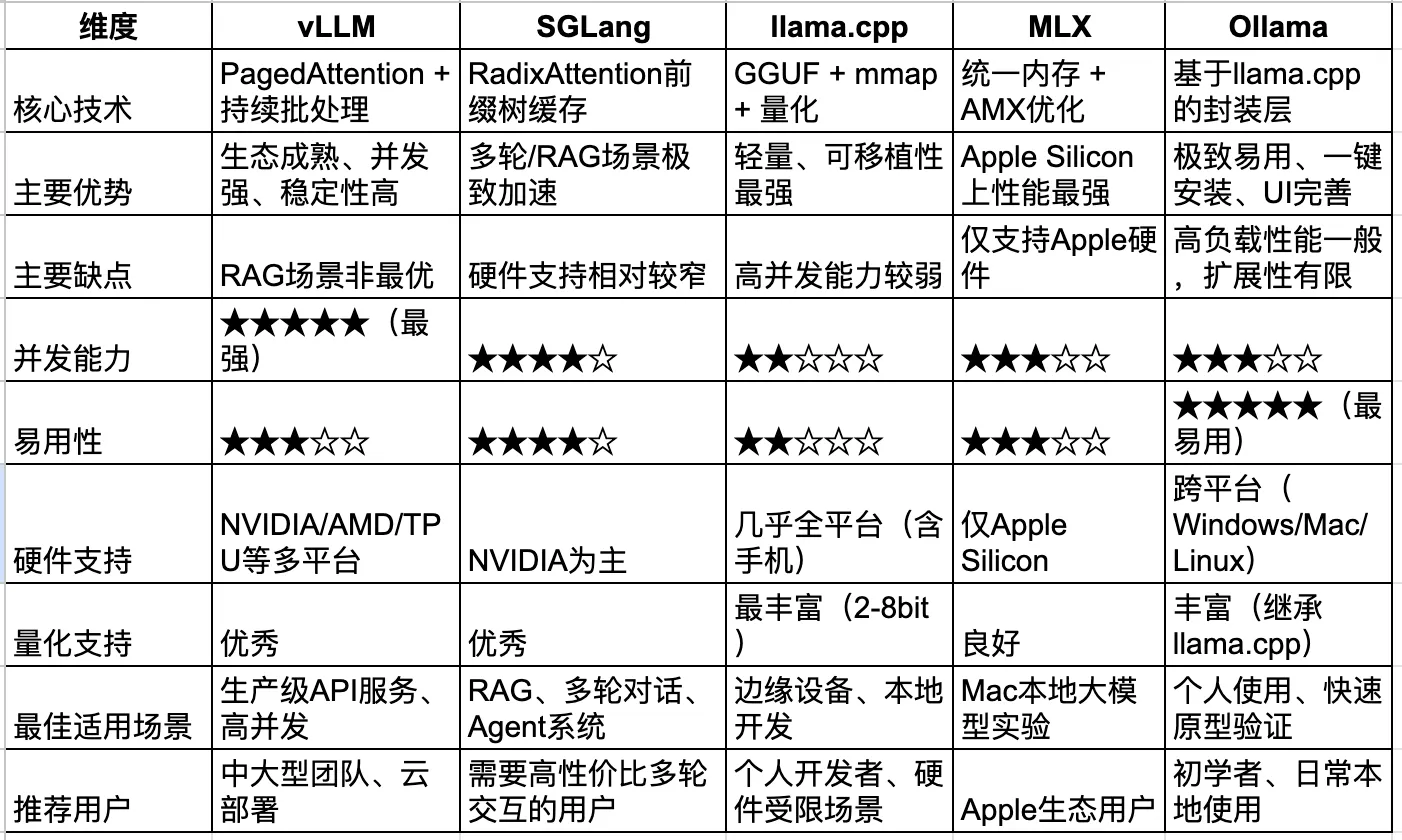
四、选型决策指南
- 生产环境、追求最高吞吐量和稳定性:优先选择 vLLM,它是当前最可靠的生产级方案。
- RAG、多轮对话、AI Agent系统:SGLang 是最佳选择,能带来显著的成本和速度优势。
- Apple Mac用户:MLX 几乎没有竞品,尤其适合M3/M4系列高内存设备。
- 边缘设备、智能硬件、极致轻量部署:llama.cpp 是首选。
- 初学者、快速验证、日常本地使用:Ollama 是最友好入口,可作为其他底层引擎的前端。
推荐混合策略:许多成熟团队采用 Ollama(本地开发/测试) + vLLM(生产通用服务) + SGLang(高价值RAG/Agent接口) 的组合方案。
五、未来发展趋势
2026年,本地推理框架竞争重点已从单纯速度转向场景适配度和工程智能。未来可能出现更多融合框架,例如将SGLang的RadixAttention与vLLM的生产稳定性结合,或Ollama进一步集成MLX/vLLM作为后端。
随着量化技术(FP8、INT4)、新硬件(Blackwell、Apple M5、昇腾等)和统一多后端接口的成熟,开发者将拥有更多灵活选择。最终,没有绝对最好的框架,只有最适合当前硬件、负载类型和业务场景的方案。
总结建议:
- 新手/个人用户:从 Ollama 开始;
- 追求极致性能:根据硬件选 SGLang(NVIDIA) 或 MLX(Apple);
- 生产部署:以 vLLM 为主,辅以SGLang处理复杂场景;
- 跨平台边缘部署:llama.cpp 仍是底线保障。
本地大模型推理已进入“百花齐放”阶段,正确理解每个框架的定位和边界,才能在2026年的AI实践中实现性能、成本与易用性的最佳平衡。
信息来源:
1. 官方项目仓库(最权威来源)
- vLLM:https://github.com/vllm‑project/vllm
- SGLang:https://github.com/sgl‑project/sglang
- llama.cpp:https://github.com/ggerganov/llama.cpp
- MLX:https://github.com/ml‑explore/mlx
- Ollama:https://github.com/ollama/ollama
2. 官方文档与技术报告
- vLLM 官方文档(PagedAttention原理):https://docs.vllm.ai/
- SGLang 官方文档(RadixAttention):https://sgl‑project.github.io/sglang/
- llama.cpp GGUF格式规范:https://github.com/ggerganov/llama.cpp/blob/master/gguf‑spec.md
- MLX 官方文档:https://ml‑explore.github.io/mlx/
- Ollama 官方文档:https://github.com/ollama/ollama/blob/main/docs/README.md
3. 2026年技术评测与深度文章
- 飞扬观察:《2026本地大模型推理框架四强争霸》 https://mp.weixin.qq.com/s/cV6nUgEh7Tm16‑7DOkpX‑A
- Java转AI手记:《2026实测:Ollama / vLLM / SGLang / llama.cpp / MLX 全面对比报告》 https://mp.weixin.qq.com/s/5NjrfOoru8a_9k46E8S‑Hg
- 量子位:2026本地推理框架性能评测专题 https://www.qbitai.com/(搜索“2026 本地推理框架”)
- 机器之心:SGLang vs vLLM 实战对比 https://www.jiqizhixin.com/(搜索“SGLang RadixAttention”)
4. 其他权威基准与报告
- Artificial Analysis 推理性能排行榜(2026):https://artificialanalysis.ai/
- Hugging Face vLLM & SGLang 优化案例:https://huggingface.co/blog
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com