
随着大型语言模型(LLM)的快速发展,文本处理和语义搜索中,**Tokenizer 与向量化(Embedding)**是两个核心环节。本文对常用 tokenizer、向量化维度、向量数据库使用及模型选择做一个全面总结。
1. Tokenizer 工具及特点
Tokenizer 是将文本切分成可处理单元(token)的工具。常用工具包括:
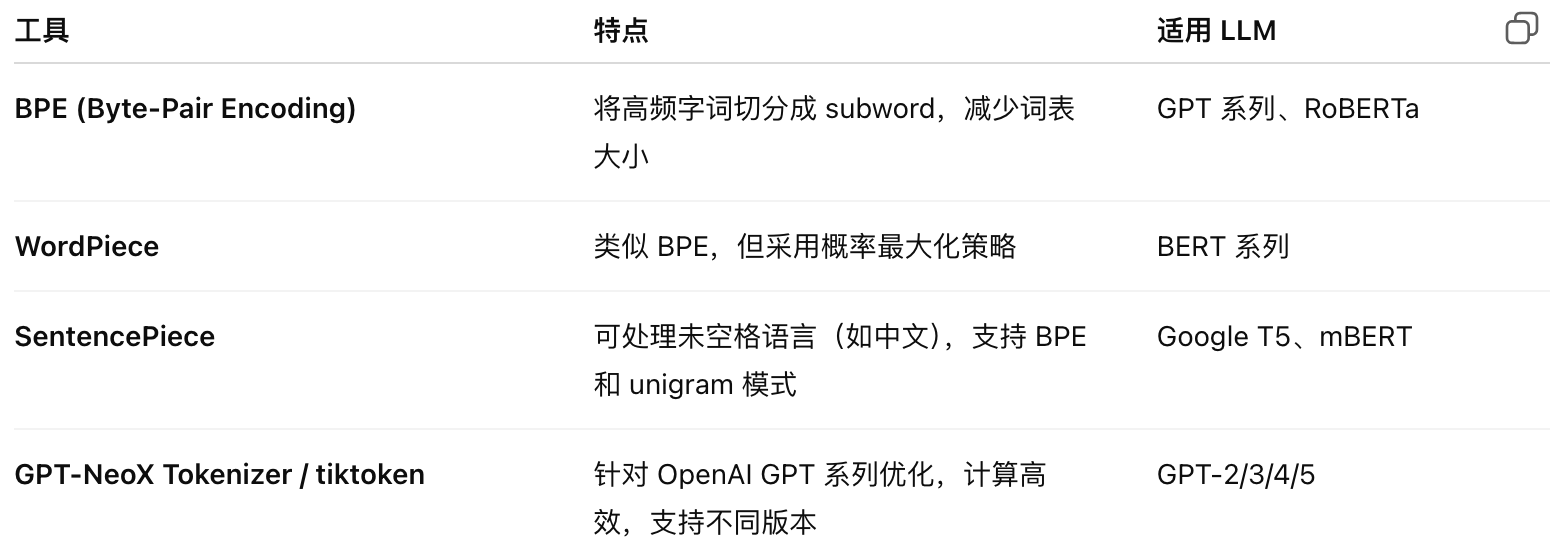
选择原则:
- 与模型对应:必须用与训练 LLM 同一 tokenizer,否则 token 编码不一致,生成或向量化结果会出错。
- 多语种支持:如中文、日文,需要 SentencePiece 等可处理无空格语言的 tokenizer。
- 效率 vs 精度:BPE / WordPiece 优先考虑 token 覆盖率,GPT 系列优化了编码速度。
2. 向量化维度与向量表
在向量化(Embedding)阶段,模型会将 token 或文本映射到向量空间。关键信息如下:
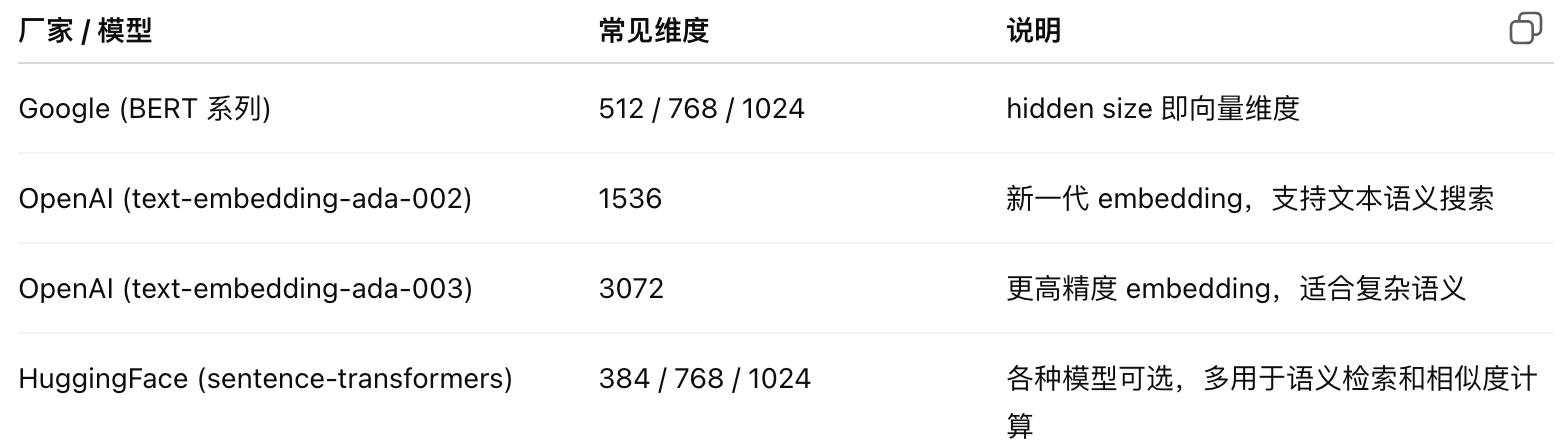
含义解析:
- 向量维度(如 768、1536、3072)表示 embedding 输出的特征数量。
- 维度越高,理论上语义表达能力越强,但计算和存储成本也增加。
3. Tokenizer 与向量表的关系
- 向量表不是查表获取的:embedding 模型通过训练得到参数,将 token 映射为向量。
- 每个 embedding 厂家训练自己的向量表:
- OpenAI、Google、HuggingFace 各自训练的 embedding 分布不同。
- 同一文本在不同模型生成的向量不直接兼容。
- 微调可能保持兼容性:
- 对同一模型做微调(LoRA、Adapter 等)不会改变向量维度和分布过多。
- 更换大版本或厂商(如 OpenAI 002 → 003,BERT → LLaMA embedding)必须重新生成向量。
4. 向量数据库使用注意事项
- 向量数据库存储的是 针对特定模型生成的向量。
- 换模型或维度不同:
- 原向量无法直接对比(维度不匹配或语义空间不同)。
- 必须重新向量化数据,否则搜索结果不准确。
- 实际操作建议:
- 固定 embedding 模型,保持数据库向量一致。
- 微调同模型可保留旧向量兼容性。
- 若升级大版本,新增字段存新向量,实现增量迁移或双向搜索。
5. 选择 tokenizer 与 embedding 的实践
- 选择 tokenizer:
- 必须和 LLM 训练时使用的一致。
- 支持文本语言类型(中/英/日等)。
- 高效处理长文本时可选优化 tokenizer(如 tiktoken)。
- 选择 embedding 模型:
- 根据应用场景:语义搜索、问答、推荐系统等。
- 考虑维度与性能成本。
- 向量数据库策略:
- 确定模型版本,避免频繁更换。
- 缓存、索引和相似度计算方式需要和向量维度一致。
- 升级模型时必须重新生成向量,保证语义搜索准确性。
6. 总结
- Tokenizer 是文本编码工具,必须匹配 LLM 模型。
- Embedding 模型训练出的向量表决定向量分布和维度,向量数据库依赖于模型。
- 维度越高,语义表达能力越强,但计算开销也大。
- 不同厂家的 embedding 向量不直接通用,更换 embedding 模型时需重新向量化。
- 微调同一模型可保留向量兼容性,但大版本升级或厂商更换必须更新向量库。