
在人工智能领域,大语言模型(LLM)的性能评估已成为开发者、研究者和企业关注的焦点。其中,LMSYS Chatbot Arena(简称LM Arena或lmarena)作为全球知名的开源竞技榜单,通过人群投票和Elo评分系统,对各种大模型进行实时排名。该榜单自2023年推出以来,已成为衡量模型能力的“黄金标准”,影响着从OpenAI到Anthropic等巨头的研发方向。根据近期分析,从2023年中GPT‑4登顶开始,模型在榜首位置的平均停留时间仅约35天,这意味着AI领域的领导地位正以惊人速度更迭。这一现象不仅反映了技术进步的加速,还对产品开发和商业应用产生了深刻冲击。本文基于LM Arena的历史数据及其他权威来源,探讨这一趋势的成因、案例及启示。
LM Arena榜单的演变与统计洞察
LM Arena由加州大学伯克利分校的LMSYS团队维护,通过匿名随机对战方式收集用户偏好数据,生成Elo分数(类似于国际象棋排名系统)。自2023年5月正式上线以来,该榜单已累计处理数百万次投票,覆盖数百个模型。从2023年中算起,当时OpenAI的GPT‑4以其强大的多模态能力和推理性能稳居榜首,但这一霸主地位很快被挑战。
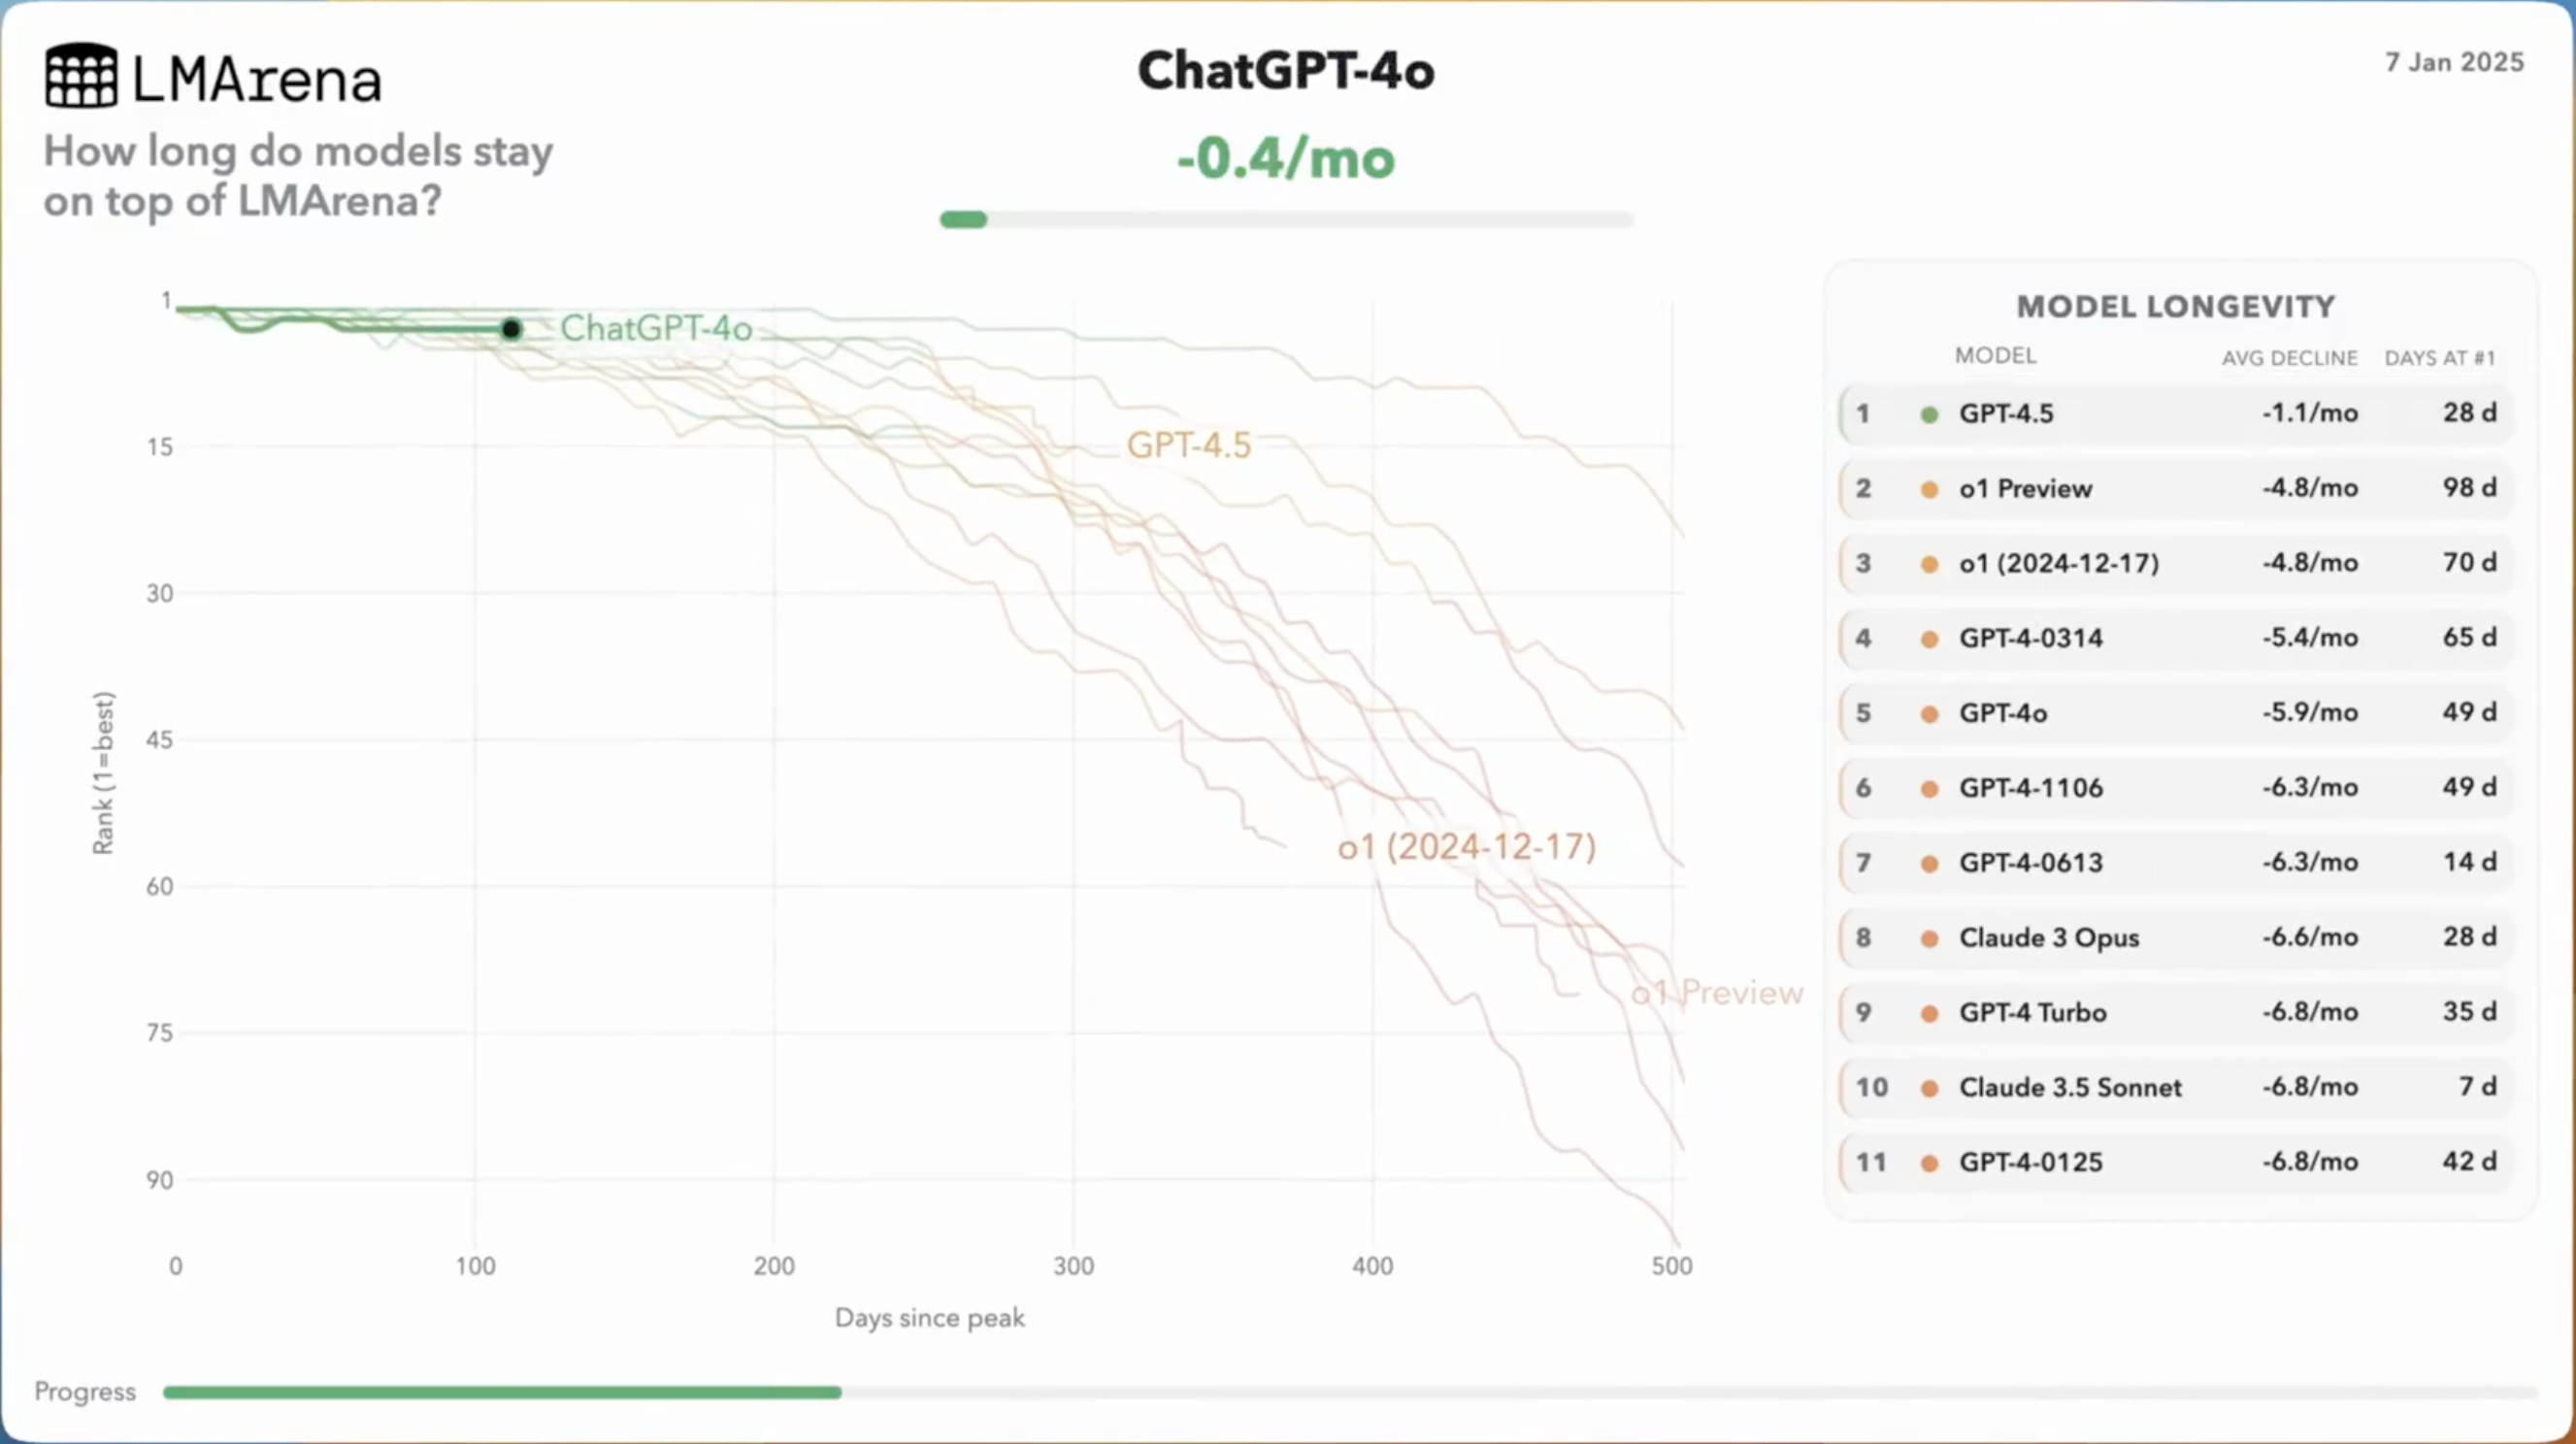
据LMSYS官方分析,自GPT‑4时代起,所有登顶过的模型平均在No.1位置仅维持35天左右。这一数字远低于早期预期——并非半年或一年,而是以“月”为单位。更令人震惊的是,许多模型在登顶后约5个月就会跌出Top 5,7个月后甚至难以保住Top 10。斯坦福大学人类中心人工智能研究所(HAI)在2025年AI指数报告中也印证了这一趋势:封闭模型(如GPT系列)和开放模型(如Llama系列)在榜单上的表现波动剧烈,2023‑2025年间,Top模型的更迭频率从季度级加速至月级。
回顾历史,GPT‑4于2023年3月发布后迅速登顶,并在中期维持领先,但到2024年初已被Anthropic的Claude 3 Opus短暂超越。随后,OpenAI的GPT‑4o(2024年5月版)以78天左右的领先时间成为停留最长的模型之一。2024年中,Anthropic的Claude 3.5 Sonnet和OpenAI的o1‑preview相继上位,前者强调高效推理,后者引入“思考链”机制,一度被誉为“最强推理模型”。进入2025年,模型迭代进一步加速:Google的Gemini 1.5 Pro、Meta的Llama 3.1‑405B,以及后续的GPT‑5和Claude 4系列轮番登顶。到2026年1月,榜单Top模型已更新为GPT‑5.2(Elo约1350+)、Claude Opus 4.5(紧随其后)和Gemini 3 Pro,这些新晋者受益于更大规模训练数据和优化算法。
Observable平台的LM Arena历史可视化数据显示,模型家族(如GPT系列)累计领先天数虽较高,但单个版本的“王朝”极短。例如,某些模型的领先期最短仅数周,这与AI硬件进步(如NVIDIA H100到B200 GPU的升级)和训练范式转变(如MoE架构的普及)密切相关。TechCrunch报道指出,行业对LM Arena的痴迷虽推动了竞争,但也暴露了基准的局限性:它更注重通用聊天,而非专业任务。尽管如此,该榜单仍被视为“野生基准”,反映真实用户体验。
典型案例:从巅峰到陨落
具体例子更能凸显这一趋势的冲击力。OpenAI的o1模型(2024年9月发布)一度以其先进的推理能力和“o1思考”模式风靡全球,被视为“领先一代”的产品。它迅速登顶LM Arena,讨论度极高,甚至在Reddit和X平台引发“AI新时代”的热议。然而,到2026年1月,o1已跌至第56位,被后续模型如GPT‑5和Claude 4系列远远甩开。类似地,Anthropic的Claude 3 Opus(2024年3月发布)曾短暂超越GPT‑4,成为“最强推理模型”的代名词,其在复杂任务上的表现备受赞誉。但如今,它已滑落至第139位,远低于当前Top 20。OpenLM.ai的扩展榜单显示,Claude 3 Opus的Elo分数停留在1265左右,而Top模型已超过1300。
这些案例并非孤立。2024年的Gemini 1.5 Pro一度位列前三,但到2025年底已被其后继者取代。Vellum AI的分析显示,o1在推理基准上虽优于GPT‑4o和Claude 3.5 Sonnet,但整体通用性不足以抵挡新模型的涌现。斯坦福HAI报告进一步指出,2024‑2025年间,封闭模型在榜单上的胜率从60%降至50%,开放模型(如Llama系列)通过社区优化加速追赶。这一快速更迭源于计算资源的指数增长:训练一个顶级模型的成本虽高企,但回报周期缩短,推动巨头每季度推出更新。
深层影响:模型能力“反向压扁”产品层
这一趋势的核心启示在于:大模型基础能力的提升速度,已超越绝大多数AI产品的迭代周期。传统软件开发周期为3‑6个月,而模型更迭仅35天,这意味着产品团队可能在集成旧模型时,新王者已出现,导致“反向压扁”——产品功能被底层模型的快速进步所主导,而非反之。
例如,企业级AI应用(如聊天机器人或代码助手)若基于Claude 3 Opus构建,数月后其性能便落后于竞争对手。Clarifai的2026 AI趋势报告警告,2026年,LLM如GPT‑5、Gemini 3和Claude 4将主导市场,但企业需转向“模型无关”架构,以适应快速换代。Medium上的分析也指出,2026年AI编码趋势将强调平台集成,而非单一模型依赖。此外,多模态榜单的兴起(如LMSYS的多模态Arena)进一步加速了这一过程,Claude 3 Opus在多模态上的领先优势迅速消逝。
从商业角度看,这压缩了“护城河”:OpenAI等公司虽领先,但优势窗口缩短至月级,迫使它们加速发布(如从GPT‑4到5的跃进)。FelloAI的2026年最佳AI排名显示,当前Top模型在上下文窗口、定价和多模态上全面升级,但用户实际使用数据表明,排名波动影响了采用率。Deepchecks的基准评估强调,Claude 3 Opus虽在某些子任务上仍优秀,但整体落后凸显了迭代的残酷。
展望:AI发展的加速与挑战
总体而言,LM Arena的统计揭示了AI领域的“摩尔定律”式加速:从2023年的GPT‑4时代,到2026年的GPT‑5.2主导,模型性能每半年翻番。这虽驱动创新,但也带来挑战,如资源集中于少数巨头,以及基准依赖的风险。未来,行业需探索更全面评估,如结合MMLU、HumanEval等多基准,以缓解单一榜单的偏差。
在这一浪潮中,没有永恒的王者。开发者应拥抱敏捷迭代,企业则需构建灵活生态,以免被“反向压扁”。正如LMSYS所言,Arena不仅是排名,更是AI进化的镜像。展望2026年,AI的黄金时代才刚开始,但速度已成决定性因素。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com