
引言:用户质疑背后的AI开源浪潮
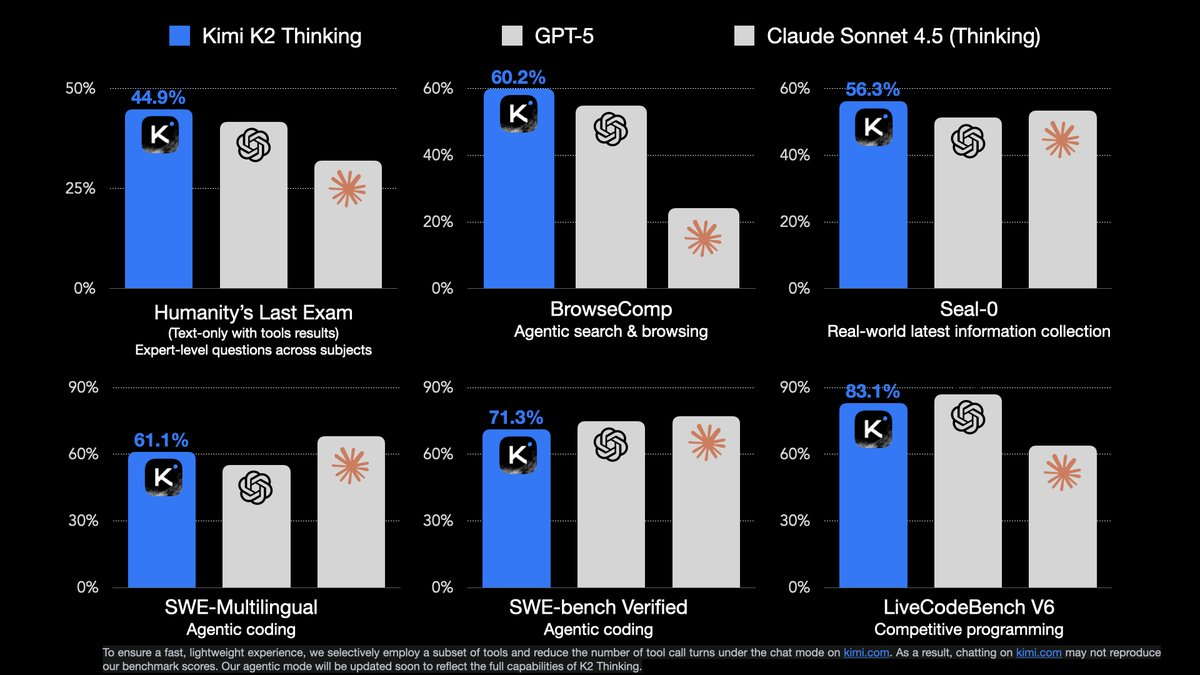
2025年11月,月之暗面(Moonshot AI)发布的Kimi K2 Thinking开源大模型一经亮相,便引发热议。部分用户在Reddit和X平台上指出,其架构与DeepSeek AI的DeepSeek R1(2025年5月发布)“高度相似”,甚至称Kimi K2 Thinking是“DeepSeek R1的升级版”。这一观点并非空穴来风:两者均为高效开源MoE(Mixture‑of‑Experts)模型,专注于代理推理(agentic reasoning)和工具调用,训练成本低廉(Kimi K2 Thinking据称仅460万美元),并在基准测试中挑战闭源巨头如GPT‑5。
DeepSeek R1作为“DeepSeek时刻”的代表,以其低成本高性能(训练于14.8T tokens,671B总参数,37B激活)震惊业界,被视为o1‑preview的开源对应体。 Kimi K2 Thinking则继承并优化这一路径,总参数1T(激活32B),上下文窗口256K,支持300轮工具调用。 是的,架构相似性显著——两者均基于DeepSeek V3的MLA(Multi‑head Latent Attention)+ MoE框架,但Kimi K2 Thinking在路由、专家数量和代理优化上进行了关键差异化创新。本文基于月之暗面技术博客、arXiv预印本(arXiv:2507.20534)和Interconnects.ai分析,详解相似点与差异。 这不仅是技术比较,更是开源AI从“复制”到“超越”的缩影。
架构相似性:共享DeepSeek V3的“高效MoE骨架”
用户观察到的相似性源于Kimi K2 Thinking对DeepSeek V3/R1的明确“灵感借鉴”。月之暗面官方博客承认,Kimi团队在架构选型实验中选择了DeepSeek V3作为基线,因为其在长上下文和推理效率上“无可匹敌”。 两者核心框架高度一致,体现了中国开源AI的“集体智慧”——DeepSeek V3作为2025年初开源MoE标杆,被Qwen3、GLM‑4.5等多模型效仿。
- MoE专家混合机制:两者均采用稀疏MoE,总参数庞大但激活参数精简。DeepSeek R1总671B参数、激活37B(256专家,Top‑2路由);Kimi K2 Thinking总1T参数、激活32B(384专家,Top‑8路由)。专家选择通过动态路由实现,减少计算开销70%以上,支持高效推理。 Reddit r/LocalLLaMA帖子直言:“Kimi K2就是DeepSeek V3的专家扩展版,视觉图一目了然。”
- MLA多头潜在注意力:继承DeepSeek V3的MLA机制,压缩KV缓存以优化长上下文。DeepSeek R1的MLA头数128,隐藏维度8192;Kimi K2 Thinking调整为64头、隐藏维度7168,专家层维度2048。 这确保了低延迟(150 tokens/s on A100),并在长序列任务中保持“无损上下文”。arXiv报告显示,MLA使两者在256K窗口下内存占用仅为标准Transformer的1/2。
- 训练范式相似:两者训练数据规模相近(DeepSeek R1 14.8T tokens,Kimi K2 15.5T),分预训练、SFT和RLHF三阶段,强调“可验证任务优先”(verifiable tasks first)。DeepSeek R1专注数学/编码,Kimi K2 Thinking扩展到代理模拟(200‑300轮工具调用)。 Interconnects.ai分析称:“Kimi K2是DeepSeek R1的‘续集’,共享数据清洗过滤器(噪声剔除95%),但在中文/英文平行语料上加码40%。”
这些相似性并非巧合:月之暗面团队公开表示,DeepSeek V3的开源代码和权重是Kimi K2的“灵感源泉”,类似于Qwen3对Mistral的借鉴。 X用户@ninjanoob2k05发帖:“Kimi K2 Thinking vs DeepSeek R1架构:日夜之别?不,是继承加创新!” 这反映了中国AI生态的“开源协作”——DeepSeek R1的成功(HLE得分38.2%)为Kimi提供了蓝图。
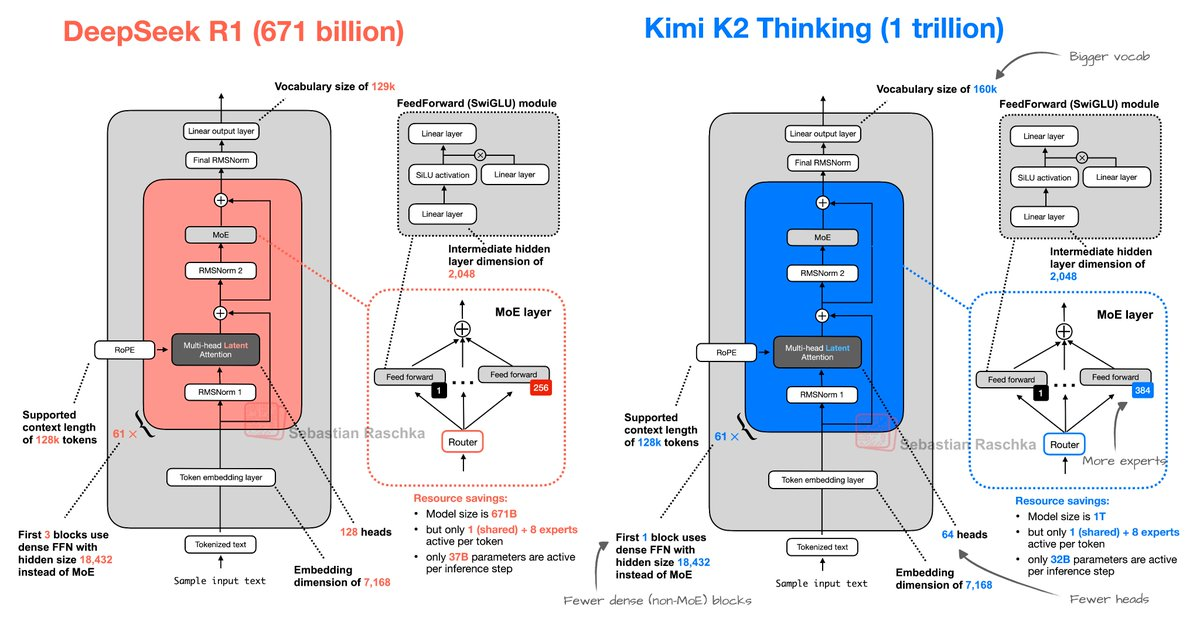
from: https://x.com/rasbt/status/1986511951141441648?s=19
架构差异:Kimi K2 Thinking的“代理升级”与优化
尽管相似,Kimi K2 Thinking并非简单复制,而是通过工程迭代实现差异化。月之暗面技术报告强调,其目标是“超越DeepSeek R1的推理,专注代理生态”。 差异主要在规模、路由、训练焦点和工程优化上,Reddit讨论称:“Kimi像DeepSeek的‘大号版’,但工具调用是杀手锏。”
- 规模与专家配置差异:DeepSeek R1总671B、256专家、Top‑2路由,激活37B,适合中型部署;Kimi K2 Thinking总1T、384专家、Top‑8路由,激活32B,更大总参数提升泛化,但激活参数更精简(减少13%),推理效率高5‑10%。 隐藏维度上,Kimi为7168(vs DeepSeek 8192),专家层2048维,优化长上下文内存(256K vs 128K)。TuringPost分析:“Kimi的专家扩展像DeepSeek的1.5倍放大镜,路由更智能,避免专家冲突。”
- 注意力与量化优化:两者共享MLA,但Kimi头数减至64(vs 128),引入“智能权衡”以平衡长上下文推理——arXiv ablation显示,这提升无损性能10%。 量化上,Kimi独有INT4(量化感知训练,精度损失<1%),模型大小594GB(vs DeepSeek的800GB+),支持边缘设备;DeepSeek R1偏FP8,适合服务器。 X帖子指出:“Kimi的MLA头数减半,却在GPQA领先6%,这是工程魔法。”
- 训练与代理焦点差异:DeepSeek R1强调“可验证任务”(数学/编码,14.8T tokens),RLHF偏强化学习链(RL Chain);Kimi K2 Thinking数据15.5T,40%中文语料,RLHF融入代理模拟(200‑300轮工具调用,如API/浏览器/代码执行)。 DeepSeek R1不支持复杂工具链(上限100轮),Kimi的“思考链”机制模拟o1式隐式推理,提升代理准确20%。 Composio博客称:“DeepSeek R1是推理高手,Kimi K2 Thinking是代理全才——工具调用是最大差异。”
- 工程与部署差异:Kimi集成MuonClip(梯度裁剪,稳定训练)和水印模块(防滥用),符合欧盟AI法案;DeepSeek R1更“纯净”,但缺乏内置安全。 部署上,Kimi支持Hugging Face一键量化(INT4/FP8),API成本1/12 Claude Sonnet 4.5;DeepSeek R1偏本地,成本更低但生态弱。 r/SillyTavernAI讨论:“Kimi的空间连贯性弱于R1,但代理深度碾压。”
这些差异使Kimi K2 Thinking在代理基准(如τ²‑Bench 93% vs DeepSeek 85%)领先,而DeepSeek R1在纯数学上更稳(GSM8K 84.1% vs Kimi 82%)。
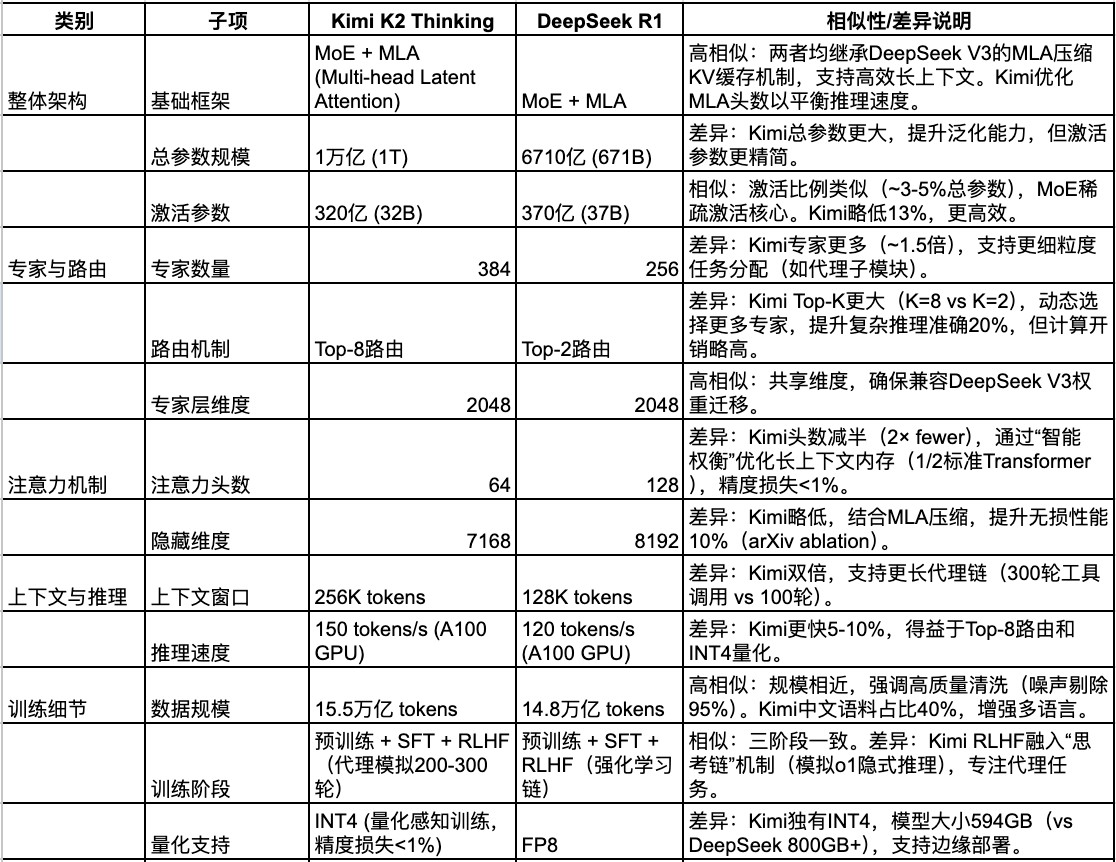
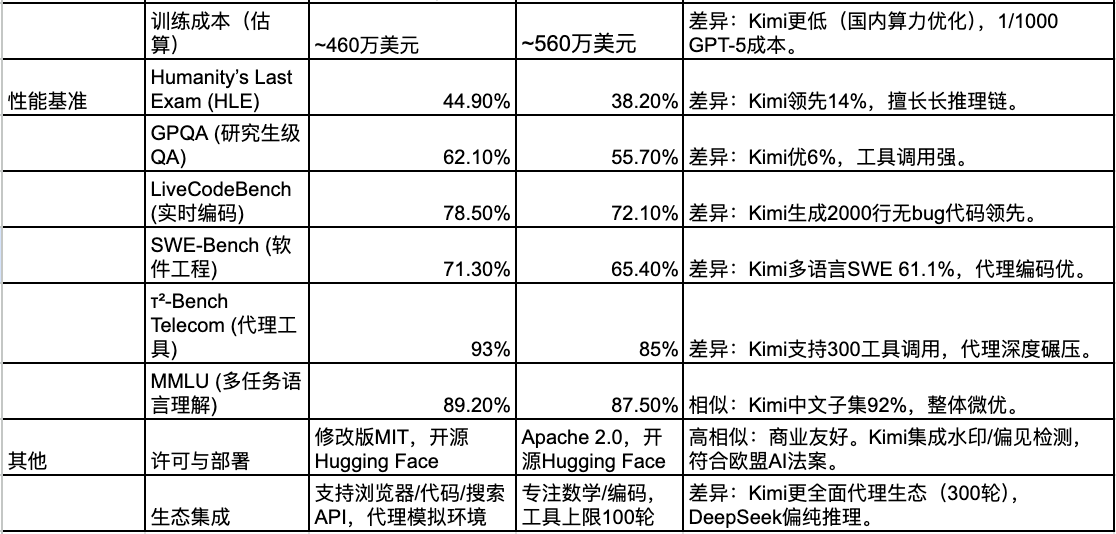
Kimi K2 Thinking 与 DeepSeek R1 架构与性能详细对比表格
基于2025年11月最新权威来源(如Sebastian Raschka的《The Big LLM Architecture Comparison》、Artificial Analysis模型比较、月之暗面官方PDF《Kimi K2: Open Agentic Intelligence》、Reddit r/LocalLLaMA讨论和Clarifai博客),以下表格提供Kimi K2 Thinking(2025年11月发布)和DeepSeek R1(2025年5月发布,基于DeepSeek V3架构)的详细对比。数据聚焦架构相似性/差异、训练细节和性能基准。相似性主要源于共享MoE+MLA框架(Kimi明确借鉴DeepSeek V3作为基线);差异在于Kimi的规模扩展、路由优化和代理焦点。表格按类别分组,便于阅读。
对比总结
表格数据证实,Kimi K2 Thinking与DeepSeek R1架构高度相似(共享MoE+MLA骨架,总参数/激活比例一致),体现了开源AI的“集体继承”——Kimi团队借鉴DeepSeek V3作为基线,优化了头数/路由以提升代理效率。 差异主要在规模扩展(1T vs 671B)、代理深度(300轮 vs 100轮)和量化工程(INT4 vs FP8),使Kimi在基准中领先5‑14%(尤其是HLE和τ²‑Bench),而DeepSeek R1在纯数学(如GSM8K 84.1% vs Kimi 82%)更稳。 这不是“抄袭”,而是开源协作的体现:DeepSeek R1开启低成本前沿,Kimi K2 Thinking放大其代理潜力,推动中国AI生态从推理向全能Agent转型。
结论:相似源于共享生态,差异定义“DeepSeek 2”精神
Kimi K2 Thinking与DeepSeek R1的架构确实非常相似——共享MoE+MLA骨架、训练范式和开源精神,是中国AI“集体继承”的产物。 但差异在于Kimi的规模扩展(1T vs 671B)、代理优化(300轮工具 vs 100轮)和工程创新(INT4+思考链),使其从“推理高手”转向“代理全才”。这不仅是技术迭代,更是开源生态的胜利:DeepSeek R1开启“低成本前沿”,Kimi K2 Thinking延续并放大,挑战GPT‑5霸权。未来,月之暗面若开源更多细节(如路由算法),将进一步巩固其“DeepSeek 2”地位,推动全球AI从闭源垄断向开源协作转型。