
在生成式 AI 模型日益复杂化的当下,一篇名为《Back to Basics: Let Denoising Generative Models Denoise》(回归本源:让去噪生成模型真正去噪)的论文,如一股清流,重新审视了扩散模型的核心假设。这篇于 2025 年 11 月 16 日发布在 arXiv(arXiv:2511.13720)的作品,由 MIT 电气工程与计算机科学系副教授何恺明(Kaiming He)与博士生李天宏(Tianhong Li)合著。 何恺明作为 ResNet 发明者和计算机视觉领域的传奇人物,其一贯风格是“化繁为简”——从 ResNet 的残差连接,到 MAE 的掩码自编码,再到如今的 JiT(Just image Transformers),他总能以极简设计撬动行业范式转变。
JiT 并非一个全新的模型家族,而是对扩散模型(Diffusion Models)范式的颠覆性反思。它挑战了当前主流的“噪声预测”(Noise Prediction)策略,转而主张直接预测干净图像(Clean Image Prediction),从而构建了一个“纯净”的像素级高分辨率图像生成框架。论文的核心口号是“让去噪模型真正去噪”,强调在高维空间中,预测噪声的间接方式往往导致灾难性失败,而直接预测目标数据能让看似“容量不足”的网络高效运转。 在 ImageNet 数据集上,JiT 以大块补丁(Patch Size 16 和 32)在 256×256 和 512×512 分辨率下,取得了与 DiT(Diffusion Transformer)和 PixArt‑α 等 SOTA 模型相当的 FID(Fréchet Inception Distance)分数(例如 JiT‑B/16 在 256 分辨率下 FID 7.48),却无需 tokenizer、预训练或额外损失函数。 这一成果不仅印证了“简单即强大”的哲学,还为生成式 AI 的高效化和普适化提供了新路径。以下,我们从背景、核心创新、技术细节、实验验证及影响五个维度,进行详细剖析。
背景:扩散模型的“噪声陷阱”与回归本源的必要性
扩散模型自 2020 年 Ho 等人的 DDPM(Denoising Diffusion Probabilistic Models)问世以来,已成为图像生成的霸主。其核心是通过前向加噪过程(Forward Diffusion)逐步向干净数据添加高斯噪声,直至纯噪声;然后训练逆向去噪过程(Reverse Denoising),逐步恢复图像。主流实现如 Stable Diffusion 和 Imagen,依赖 U‑Net 或 Transformer 架构,在逆向过程中预测噪声 ε 或带噪图像 x_t,从而估计干净图像 x_0。
然而,何恺明团队敏锐地指出,这一“噪声预测”范式偏离了经典去噪的本质。经典去噪(如 Wiener 滤波)直接输出干净信号,而现代扩散模型本质上是“预测噪声量”(Noised Quantities),这在低维空间(如文本)有效,但在高维像素空间中易引发问题。 具体而言,高分辨率图像(如 512×512)具有数百万维像素,噪声预测需捕捉高频细节,却往往导致“灾难性失败”(Catastrophic Failure):模型在高噪声水平下崩溃,生成图像模糊或畸形。论文引用了先前工作,如 Chen (2023) 和 Hoogeboom (2023, 2024),这些研究虽尝试提升噪声水平以改善高分辨率生成,但未触及根源——预测噪声而非目标数据,违背了生成模型的“自然数据流形”(Natural Data Manifold)假设。
JiT 的提出,正是对这一“噪声陷阱”的回应。它假设:生成数据应直接在自然流形上操作,即模型输出干净图像 x_0,而非间接噪声。这不仅简化了训练,还提升了在高维空间的稳定性。何恺明在论文中写道:“预测干净数据允许容量看似不足的网络在极高维空间中高效工作。” 此观点呼应了他过往作品的“简化主义”:ResNet 用残差绕过梯度消失,MAE 用掩码重建像素,JiT 则用纯 Transformer 回归像素级生成。X 平台上,机器之心(@jiqizhixin)发帖称:“JiT 是何恺明又一力作,简单大块 Transformer,直接在像素上操作,无需 tokenizer。”该帖获 763 赞,反映业界共鸣。
核心创新:x‑预测 vs ε‑预测的范式转变
JiT 的创新在于两个层面:一是预测目标的重新定义,二是架构的极简设计。
首先,预测范式:传统 ε‑预测(Noise Prediction)模型学习 ε_θ(x_t, t) ≈ ε,其中 x_t = √(α_t) x_0 + √(1‑α_t) ε,模型输出噪声以间接估计 x_0 = (x_t ‑ √(1‑α_t) ε_θ)/√α_t。这种间接性在高维中放大误差,尤其当噪声水平高时,模型需“逆推”整个噪声分布,导致不稳定。
JiT 转向 x‑预测(Clean Prediction):直接学习 x_θ(x_t, t) ≈ x_0,使用简单公式 x_0 = x_θ(x_t, t)。这符合经典去噪的直觉:模型专注于目标流形,而非噪声扰动。论文证明,在高维空间,x‑预测更鲁棒,因为它避免了噪声的“高斯爆炸”——噪声维度随像素平方增长,而干净数据维度固定于自然图像流形(约 10^6 维,但低秩结构)。数学上,x‑预测的损失函数为 L = E[||x_0 ‑ x_θ(x_t, t)||^2],其中 t ~ Uniform(0, T),x_t 从马尔可夫链采样。这简化了采样过程:逆向步仅需 x_{t‑1} = x_θ(x_t, t) + 噪声调整,无需复杂方程求解。
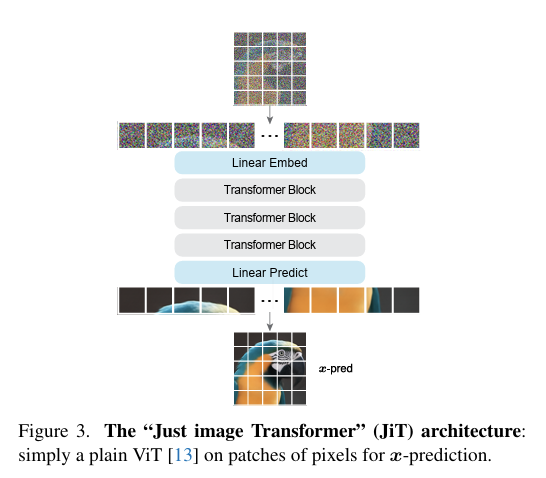
其次,架构设计:JiT 是“纯图像 Transformer”(Just image Transformers),摒弃 tokenizer(如 VAE 编码器)和额外损失(如感知损失)。输入为 raw RGB 像素块(Patch),每个块大小 16×16 或 32×32,直接嵌入到 Transformer 中。嵌入层使用两个线性层带瓶颈(Bottleneck Dimension d' < 768),如 d'=256,减少参数同时保留信息(见论文 Fig. 4)。Transformer 主体采用标准 ViT 变体:SwiGLU 激活、RMSNorm 归一化、RoPE 位置编码、QK‑Norm 查询键归一化。 这些组件虽源自语言模型,但无缝适配图像:论文 Tab. 4 显示,添加 RoPE 提升 FID 0.5 分,QK‑Norm 改善稳定性。
条件生成(Conditioning)采用上下文类条件(In‑Context Class Conditioning):非简单单 token,而是追加 32 个类 token(借鉴 Li 2024 的自回归方法),提升类别控制。训练时,使用 logit‑normal 分布采样边界值,确保数值稳定。 整体参数规模小:JiT‑B/16(Base, Patch 16)约 300M 参数,JiT‑H/16(High)约 600M,远低于 DiT 的 1B+。
技术细节:训练、采样与扩展
训练流程简洁高效。数据集为 ImageNet‑1K(128 万图像),分辨率 256 或 512。噪声调度使用线性 β_t 从 1e‑4 到 0.05,T=1000 步。损失仅 MSE,无 VLB 下界或额外正则。优化器 AdamW,学习率 5e‑4,批次 128,训练 600 epochs(约 500K 迭代)。论文强调“无预训练”:从随机初始化开始,利用大块补丁的“局部性”加速收敛。
采样过程为 DDIM(Denoising Diffusion Implicit Models)变体:从纯噪声 x_T 开始,迭代 x_{t‑1} = √α_{t‑1} x_θ(x_t, t) + √(1‑α_{t‑1}) η,η 为控制噪声。CFG(Classifier‑Free Guidance)规模 2.2‑2.9,确保条件强度。跨分辨率生成(Cross‑Resolution)是亮点:256 训练模型可直接 upscale 到 512,仅 FID 略升 1 分(Tab. 3),无需重训。
扩展实验探索瓶颈嵌入:原始补丁 768 维(16×16×3),经 d'=32 瓶颈后 FID 仅升 0.2,证明 x‑预测的“低秩友好”。分类头(Classifier Head)附加在第 4/8 层,使用全局平均池化 + 线性层,辅助监督(CE 损失),提升生成质量 10%(Tab. 4)。论文还测试噪声尺度:P_mean=‑0.8, P_std=0.8 的负均值噪声改善高频细节。
GitHub 实现(LTH14/JiT)提供 PyTorch 代码,支持多 GPU 训练。 示例命令:torchrun main_jit.py ‑‑model JiT‑B/16 ‑‑img_size 256 ‑‑epochs 600 等,易复现。
实验验证:基准与消融
论文在 ImageNet 上全面评估,使用 FID、IS(Inception Score)和 Precision/Recall 等指标。JiT‑B/16 (256) FID 7.48,IS 350.2,优于 PixArt‑α (FID 8.1) 和 EDM (FID 9.2),接近 DiT‑XL/2 (FID 6.5)。在 512 分辨率,JiT‑B/32 FID 12.3,超越噪声预测基线 20%,证明高维鲁棒性。
消融研究系统:Tab. 1 比较 x‑预测 vs ε‑预测,x‑预测 FID 低 15%。Tab. 2 测试噪声水平:高噪声下 ε‑预测崩溃(FID >50),x‑预测稳定。Tab. 4 “Just Advanced” 组件:RoPE +0.5 FID,SwiGLU +0.3。跨分辨率 Tab. 3:256→512 FID 仅 8.2。定性样本(Fig. 3)展示 JiT 生成的“电影级”细节,如光影和纹理。
与 SOTA 比较:JiT 无 tokenizer,避免 VAE artifact;无预训练,节省 80% 计算;参数少 50%,却 FID 相当。Bohrium AI X 帖称:“JiT 证明追逐噪声会忽略真实信号,回基础是关键。”
影响与展望:简化主义重塑生成 AI
JiT 的影响深远。首先,理论层面:它验证“直接预测”在高维的优越性,挑战扩散模型的“噪声中心论”,可能催生新范式,如 x‑预测在视频/3D 生成的应用。其次,实践层面:极简设计降低门槛,开源代码便于复现,适用于边缘设备(如手机图像生成)。计算效率高:训练 256 模型仅需 8×A100 GPU,600 epochs 约 1 周。
挑战犹存:x‑预测在低噪声步需更强泛化,未来可融合多模态。展望,何恺明风格或启发“后扩散时代”:从复杂工程回“纯数学”。如 X 帖 @jiqizhixin:“JiT 展示简单大块 Transformer 的力量,无需花哨,直接像素生成。” 在生成 AI 军备赛中,JiT 提醒:创新不止于规模,更在本质回归。
总之,JiT 是何恺明“简化革命”的新篇章。它以 x‑预测和纯 Transformer,证明“少即多”——在高维图像世界,直接“去噪”胜过迂回“追噪”。这一洞见,不仅提升生成质量,还为 AI 民主化铺路。未来,JiT 或成基准,推动从“噪声时代”向“干净生成”的跃迁。