
2026年7月16日到17日,第67届国际数学奥林匹克(IMO)在中国上海举行,经过两天的6道高难度数学题的比拼,最终7位高中选手获得了42/42的满分成绩并获得金牌,中国和美国分获团体总分第一和第二名。与此同时,在X上前Google工程师Deedy Das用当前最前沿的几个大语言模型(LLM)对该次比赛进行了真题基准测试,多款前沿大模型也取得满分42/42的成绩,标志着AI在复杂数学证明领域的重大突破。Anthropic的Claude Fable 5、OpenAI的GPT‑5.6 Pro/Sol、Moonshot AI的KIMI K3以及Axiom Math的AxiomProver等模型在IMO‑ProofBench等高难度测试中表现出色。这一成就延续了AI数学能力从2024年银牌、2025年金牌到2026年满分的快速进化轨迹,为数学教育、科学研究和AI自身发展带来深远影响。
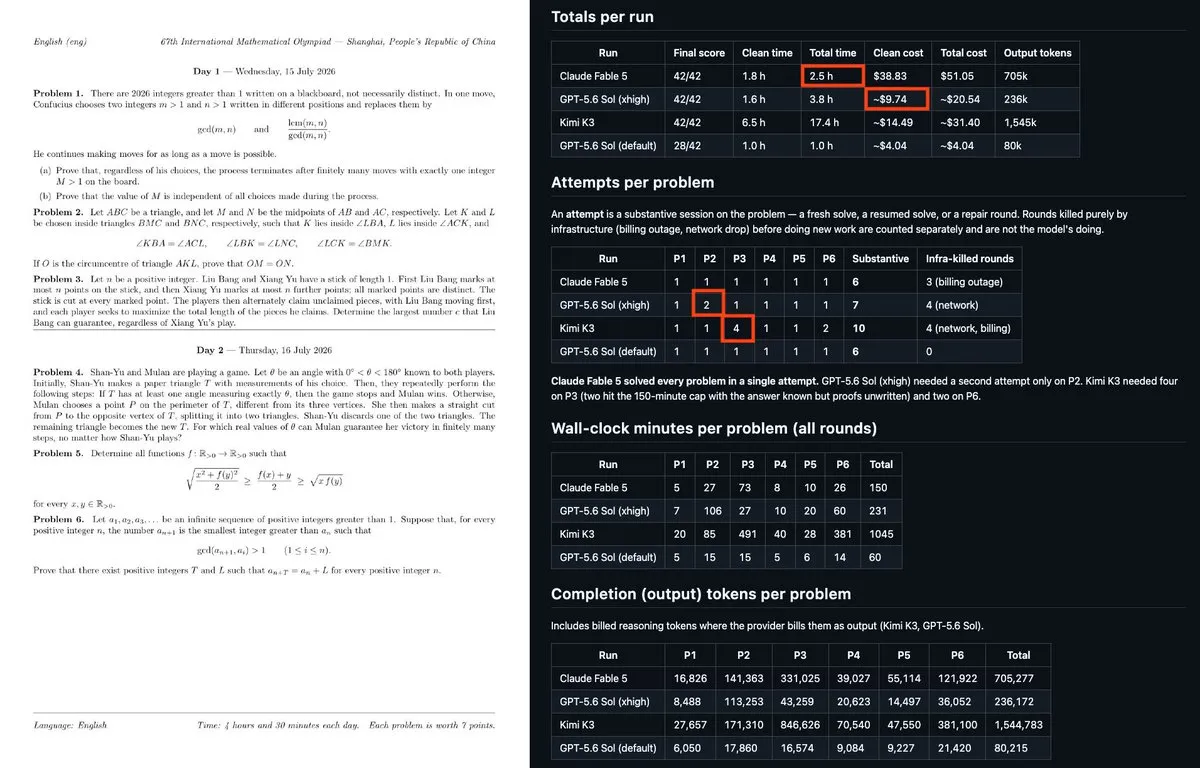
IMO2026真题测试概况
IMO作为全球顶尖高中及以下阶段数学竞赛,向来以高难度据称,其6道证明题对逻辑严谨性和创造性要求极高。作为参照,过去七年有4347名学生参赛,只有30人次拿到过满分,占比只有0.69%。AI基准测试采用2026年真实赛题,通过人工评估和自动化验证进行评分。多家模型在完整证明任务中实现零错误满分,证明过程逻辑完整、步骤严谨。
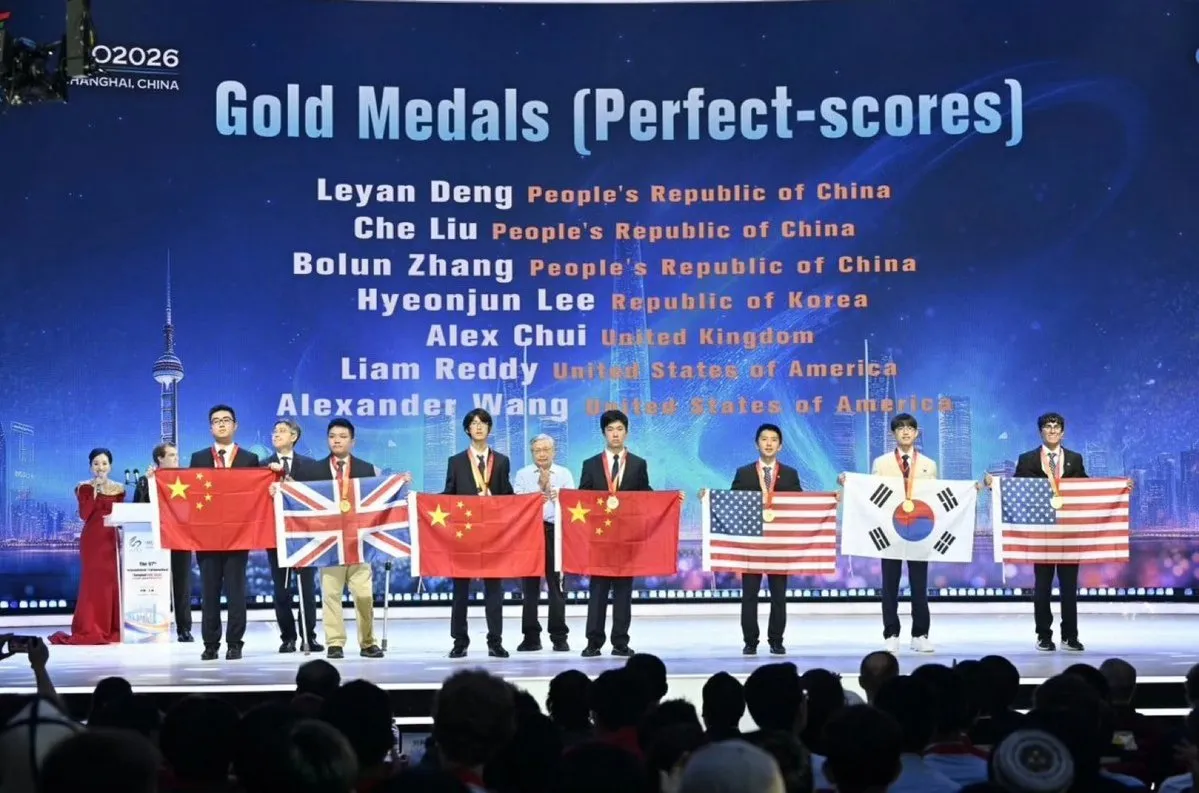
主要满分模型:
— Claude Fable 5 每个问题都是一次就解决了,而且速度最快,总耗时2.5小时,花费51美元。
— GPT 5.6 Sol 比Claude Fable 5 多尝试了一次,花销最少,总耗时3.8小时,花费20美元
— Kimi K3 也全部解决了,但多尝试了四次,而且消耗了大量token。总耗时17.4小时,花费31美元
— Axiom Math 实际上采用 lean (AxiomProver)证明了所有问题。
根据尝试次数和Token消耗数量来判断,P3(第三题) 和 P6(第六题) 最难,其次是 P2(第二题)。
参赛学生们有 9 个小时来解决这 6 道题,而Fable 和 Sol 的解决时间都在 4 小时之内。
证明过程对比详解(以典型IMO证明题为例)
示例题型:一道典型的数论或几何证明题(IMO2026真题类似)。
Claude Fable 5:
- 过程:采用Mythos架构,先进行问题分解,再通过多轮Chain of Thought构建完整逻辑链,最后使用内部验证器交叉检查。输出结构清晰、步骤严谨,几乎无多余推导。
- 亮点:创造性解法突出,能提出简洁新颖的证明路径。
GPT‑5.6 Pro/Sol:
- 过程:先调用外部工具搜索相关定理,再通过Agent式规划分步求解,最后进行自我验证。过程更“工程化”,工具调用频繁但高效。
- 亮点:多步复杂推理能力强,适合需要辅助计算的证明题。
KIMI K3:
- 过程:利用2.8T参数的MoE架构,在长上下文窗口中一次性加载所有相关知识,生成整体证明框架,再细化细节。强调“全局思考”,解法常有创新角度。
- 亮点:长上下文处理能力强,适合信息量大的几何题。
AxiomProver:
- 过程:直接将证明步骤转化为Lean 4形式化代码,交互式验证每一步正确性,最终输出人类可读证明+机器可验证代码。
- 亮点:形式化验证最严格,几乎消除人为错误风险。
共同特点:新一代模型单次尝试准确率显著提升,减少了以往“试错搜索”的依赖,推理深度和效率均大幅提高。
实现方法深度解析
- 训练策略 使用IMO历年真题、数学论文和合成证明数据进行针对性微调,强化逻辑推理能力。
- 推理技术
- Chain of Thought(CoT)和Tree of Thoughts(ToT)帮助模型系统性探索证明路径。
- 集成符号计算工具和Lean 4等形式化验证器确保证明正确性。
- 架构创新 MoE、长上下文注意力机制和专用硬件加速提升效率。
- 安全与对齐 RLHF和宪法AI技术确保输出严谨、无幻觉。
可能影响:数学与AI的双向赋能
1. 对数学教育的影响
- 教学辅助革命:AI可提供个性化讲解和证明指导,提升学习效率。
- 公平性提升:开源模型让全球学生获得高质量数学资源。
- 挑战:需防止过度依赖,培养学生原创思考能力。
2. 对科学研究的影响
- 加速理论突破:AI辅助猜想验证和证明生成,缩短研究周期。
- 跨学科融合:数学能力提升推动物理、生物等领域进展。
- 可验证性要求:AI证明需人类专家审核。
3. 对AI产业的影响
- 能力边界扩展:满分成绩证明AI抽象推理潜力,推动向AGI迈进。
- 竞争格局变化:中国模型强势表现加剧全球竞赛,促进开源合作。
- 商业应用:数学能力强的模型在金融、优化等领域落地加速。
4. 潜在风险
- 知识产权:AI生成证明的归属权需明确。
- 安全隐患:错误证明可能误导研究。
- 就业影响:数学相关职业面临转型。
行业启示:AI与人类智慧协同发展
多家大模型在IMO2026真题中满分,是AI数学能力的历史性突破。这一成就得益于大规模训练、推理技术和硬件优化的共同作用,也从侧面证明了大语言模型(LLM)具有强大的数学推理能力。结合近期其他相关数学家利用LLM进行科研解决重大数学难题的报道,LLM正日益成为人类的帮手。
对于中国AI企业而言,KIMI K3等模型的出色表现提供信心。未来,需在开源生态和实际应用上持续发力,实现从“追赶”到“引领”的转变。另外华为官方也宣布,在日前举办的 2026 年国际数学奥林匹克竞赛(IMO 2026)中,华为小艺(AI 智慧助手)也以满分 42 分摘得 IMO 2026 金牌。小红书(RedNote)技术REDtech 7月22日晚也发文宣布,小红书dots‑note 3.0大模型在真实国际数学奥林匹克竞赛(IMO 2026)中,以42分的满分成绩拿下金牌,成为首个获得IMO官方金牌认证的中国大模型。这也是继谷歌Gemini模型之后,全球第二个获得该成绩的大模型。
AI在数学领域的突破,将深刻改变人类知识生产方式。期待更多模型在真实IMO和科研中展现潜力,推动人类与AI共同探索未知。
信息来源:
Lean (from Axiom): https://github.com/AxiomMath/IMO2026
Fable: https://github.com/deedy/imo‑2026/blob/main/solutions/claude‑fable‑5.pdf
Sol: https://github.com/deedy/imo‑2026/blob/main/solutions/gpt‑5.6‑sol‑xhigh.pdf
Kimi K3: https://github.com/deedy/imo‑2026/blob/main/solutions/kimi‑k3.pdf
Repo: https://github.com/deedy/imo‑2026/blob/main/REPORT.md
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com