
在广袤的宇宙中,人类大脑有点像超级英雄:它只消耗相当于一个普通灯泡的能量(约 20 瓦),却能发明数学、写出哲学,建立起连接全世界的文明。奇怪的是,尽管大象的大脑神经元数量比我们多好几倍(大约 2570 亿个),它们却没有像人类那样发展出抽象思想——这是为什么?
一篇 2025 年 9 月发表的论文《人类智能的演化:认知演化的信息论视角》给出了一个有趣而直观的解释:关键在于信息的“压缩”。想象你在整理一堆杂乱文件,把它们打包成 ZIP 文件——能节省空间、检索更快。人类的大脑和文化也做了类似的事:从“看”(视觉)到“说”(语言)再到“写”(文字),信息一步步被压缩、变得更有序(信息论里叫“熵”降低),于是大脑能在有限能量下做更多复杂的事。
下面用通俗的话把论文的几个核心点讲清楚。
什么是“智能”?
智能不是单一的东西,也不只是考试分数。美国心理学会把智能定义为:推理、计划、解决问题、抽象思考、理解复杂概念、快速学习并从经验中吸取教训的能力。换句话说,智能包括灵活应对现实问题的那一套能力,而不是单纯记忆或算术。
早在上世纪,心理学家提出了“g 因子”(general intelligence)的概念,认为存在一种总体能力影响各种认知任务。这一理论催生了现代 IQ 测试,尽管有争议,但对研究影响很大。
我们的大脑哪里厉害?
人的大脑大约有 860 亿个神经元(占身体重量很小的一部分),却消耗了全身相当高的能量(约占体能的 20%)。相比之下,像大象那样的动物虽然神经元很多,但没有发展出把信息系统性“压缩”的文化工具(比如语言和文字),所以没有出现像人类那样的大规模抽象思维。
这里的“压缩”有点像把乱房间整理成书架:原本到处都是信息(高熵),整理后就容易查找、处理、利用(低熵)。信息论大师 Claude Shannon 把这种“乱”用数学公式表示出来,熵越高表示越难预测和处理。人类通过语言和文字把世界的复杂性一步步“理顺”,从而极大提高了思维效率。
能量是硬约束
把大脑想成一部电池有限的手机:电量少,但要运行很多应用。婴儿出生时大脑有接近 1000 亿个神经元,成长过程中会“剪枝”到约 860 亿,这不是浪费,而是优化——把不必要的连接去掉,保持重要的联系,更省能量。这种“修剪”和“强化常用连接”的机制(Hebbian 学习)能减少噪音、提升效率。
语言处理的脑区只需要较少的神经元却能高效工作;还有一些特殊神经元帮助我们快速进行社交判断。功能性脑成像发现,某些智能表现更好的人,他们前额叶的活动模式(可理解为信息组织方式)更有利于处理复杂任务,说明大脑在能量限制下还能优化运作。
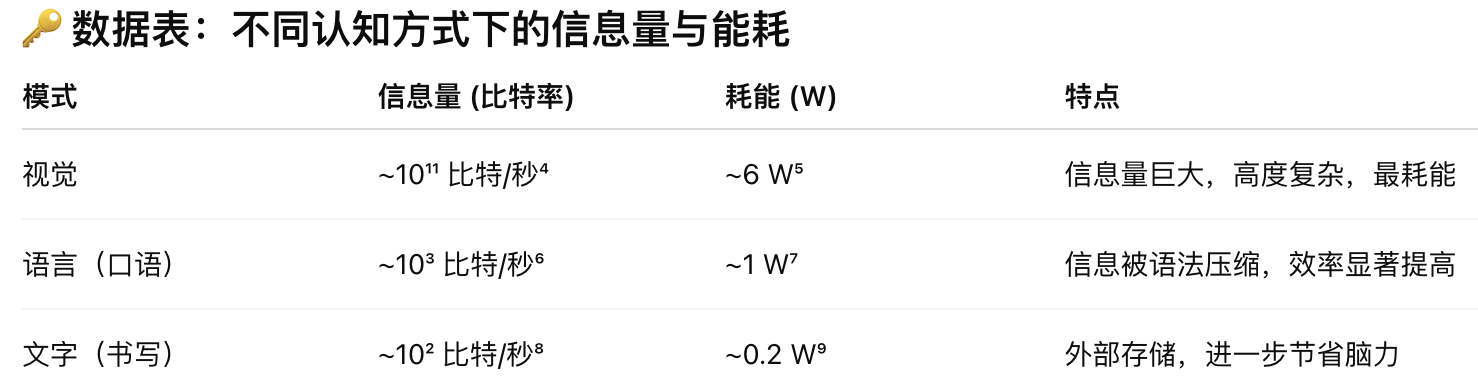
总体上看:视觉处理非常耗能(约占大脑能量的 30%),语言要少得多(约 5%),写作和外部记录则能把大量信息移到脑外,从而节约更多能量。
为什么视觉“费电”?
视觉是最早接收外界信息的系统,但它也最为复杂——自然界充满细节、变化与噪声。视觉输入的信息量非常大(论文估算每秒高达 10^11 比特),处理这些信息需要大量计算和能量。早期人类在野外依赖视觉来觅食和躲避危险,这在短期内很有用,但要把视觉的“大量原始信息”变成抽象思维就很费力,因此需要更高效的方式来表示和传递信息。
语言:第一步信息压缩
语言把复杂的视觉和经验内容转换为线性的符号序列。比如英语在考虑语法后,每个字符的“有效信息量”会大幅下降(从原始估计下降到每字符约 1 比特),说话时每秒处理的信息量远小于视觉,从而显著省能。语言的出现(包括手势、发声结构等演化)使我们能把复杂场景转述成更可传递、可学习的形式。
有学者认为,人类大脑天生具备某些语法倾向(如“通用语法”理论),也有学者强调社会学习的作用。不管哪种,语言都极大提升了信息的可压缩性和可传承性。
文字:将知识冻结、把记忆外挂
文字把暂时的口语固定下来,形成稳定的、低熵的符号系统。字母或表音文字的条件熵很低,阅读或写作时每秒处理的信息量更小,且大量信息可以存储在外部媒介(刻在石头上、写在纸上、存入电脑),这相当于给大脑扩充了记忆容量。文字的出现直接促成了复杂学科(数学、哲学、科学)的发展,因为人们能跨时代地累积、检验与传播思想。
历史上,从苏美尔的记账符号到后来的文字体系,都是把社会和认知活动从“必须常记在脑里”转变为“可以外存并共享”的过程。结果是人类的认知能力被极大放大。
用数字说明“压缩”的效果
论文用比特率来对比:视觉约 10^11 比特/秒、语言约 10^3 比特/秒、文字约 10^2 比特/秒——这是非常明显的量级下降。理论上,这样的下降让大脑能在同样的能量预算内做更多、更复杂的运算,解释了人类认知能力快速进步的可能路径。
AI 的“相似”与不同
现代大型语言模型(例如一些被报道表现优异的模型)在训练时通过最小化预测错误来降低不确定性,从而在某些任务上展现出“涌现”的能力。例如:现代生成式大预言模型如OpenAI 的ChatGPT4 o1,训练时最小化“猜错”乱度,涌现能力超强(如在AIME测试中数学题83.3%对)。而在2025年的独立测试中,ChatGPT‑4.5通过图灵测试,证明巨型深度人工神经网络在足够多的神经元和相互连接的基础上能够“涌现”智能。这在信息论上和人类通过语言/文字压缩信息的思路有相似之处,但关键差别是:AI 缺乏身体经验与长期的文化‑生物反馈循环,也没有人类那样的能量与生物学限制。换言之,AI 在某些任务上像是“学会了压缩技巧”,但并不等同于人类那种嵌入在文化与身体中的智慧。
总结一句话:为什么人类“与众不同”?
人类智能不是单靠“大脑更大”就能解释的,而是“大脑硬件(神经元)+ 符号系统(语言、文字)”协同的结果。通过不断降低信息的乱度(熵),我们把外界复杂性变成可传承、可操作的符号,从而在 20 瓦左右的能耗下完成惊人的认知工作。这一观点把生物学、信息论和文化进化连在一起,为理解人类智慧提供了一个直观且有解释力的框架。