
前言:机器人也能更“聪明”?
想象一下,如果你对家里的机器人说:“去厨房收拾一下餐具,然后帮我端杯水”,它能听懂指令、看懂周围环境,并迅速执行——这样的体验,是很多人梦想中的未来生活场景。
最近,香港大学的研究团队在 arXiv 上发布了一篇有趣的论文,提出了一个能让机器人更聪明的新模型:PD‑VLA。
它的亮点在于:通过并行解码和动作分块,让机器人在处理复杂任务时,推理速度提高了一倍以上,任务成功率也显著提升。
今天就用通俗的语言带大家了解下:PD‑VLA 究竟是什么、解决了什么问题,又能带来怎样的应用想象?
背景:机器人也有“大脑”,却常常慢得要命
机器人想完成一个复杂任务,需要先“看”(视觉识别)、再“听懂”(语言指令),最后“动起来”(动作控制)。
学术界把这样的能力叫做:VLA(Vision‑Language‑Action)模型。
传统 VLA 模型最大的问题是:
- 推理慢:每次只能一步一步预测动作,就像写作文时每次只写一个字,效率低。
- 任务越复杂越慢:长动作序列任务的推理时间甚至几何级增长。
- 泛化能力不足:新场景或新任务时,模型往往表现不佳。
所以,团队希望让机器人也能更快“想好”接下来要干的事,就提出了 PD‑VLA。
技术亮点:并行解码 + 动作分块
✅ 并行解码
想象传统模型像打字机:一个字一个字往后敲。
PD‑VLA 则像打印机:一次输出一行甚至一页,大大加速了速度。
具体来说:
- 它不再依赖传统的**自回归(autoregressive)**方式,而是同时预测多个 token。
- 推理速度相比基线快了 2.3~2.6 倍。
✅ 动作分块
复杂任务往往包含多个连续的子任务,比如“抓取杯子 → 旋转 → 放到桌上”。
PD‑VLA 把整段动作序列自动拆成几个chunk(动作块):
- 每个块对应一个相对独立的动作单元;
- 并行生成后再拼接,保持整体流畅性。
实验中,这让复杂任务成功率从 63.4% 提升到了 71.8%。
模型结构简单看
PD‑VLA 包含三个核心模块:
- 视觉编码器:识别图像中的关键目标。
- 语言编码器:理解用户指令。
- 并行解码器:一次输出多个动作块的序列。
论文里还提到,视觉编码部分用了注意力融合机制,帮助模型更好聚焦场景中的重点目标(比如抓取时锁定杯子的位置)。
实验结果:又快又准
论文在两个机器人仿真环境(RoboSuite 和 Habitat)做了测试:
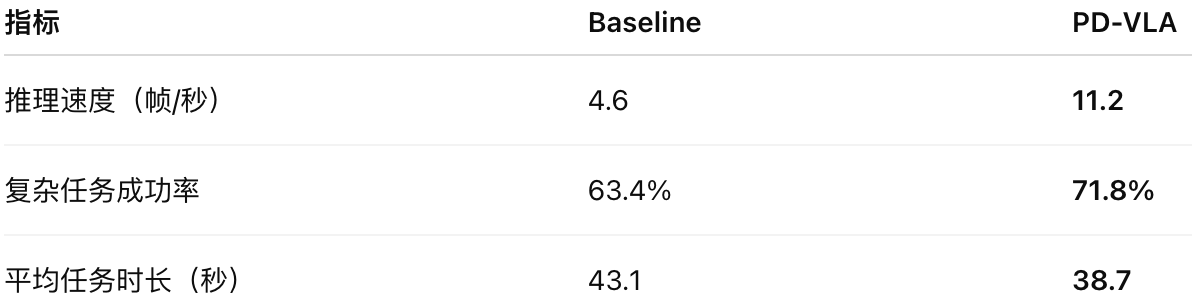
简单说:更快,更稳,更省时间。
另外,在真实机械臂实验中,PD‑VLA 也比传统模型表现更好,成功率达到 77.3%。
应用想象:服务机器人、工业自动化都能用
这项技术看似离我们有点远,但想想就能发现场景非常多:
- 家用机器人:根据一句话指令同时做几件事,比如收拾餐具+扫地。
- 工业机器人:快速适应不同生产线或工序,实时调度。
- 医疗康复机器人:同时根据医生指令和患者状态做复杂动作。
更重要的是,并行解码的思路也能迁移到其它 AI 场景,比如自动驾驶、多任务对话等。
思考:更强 AI 的下一步是什么?
论文也提到挑战:
- 如何让模型在真实复杂环境中同样泛化良好;
- 如何和硬件更好地结合,比如实时避障;
- 数据量依然是关键:复杂任务需要更大的多模态数据集。
未来,也许机器人会越来越像人:
- 能听懂话;
- 能看懂场景;
- 更能快速计划接下来要怎么做。
小结
香港大学团队的 PD‑VLA 提出了一条新路:
让机器人不再“一个字一个字想”,而是一次想好一段话,再快速执行。
通过并行解码和动作分块,它让机器人更聪明,也更高效。
而这只是开始——未来,机器人或许会像今天的 ChatGPT 一样,成为人们生活的好帮手。
论文标题:Accelerating Vision‑Language‑Action Model Integrated with Action Chunking via Parallel Decoding (PD‑VLA)
arXiv 链接:https://arxiv.org/abs/2503.02310