
在人工智能领域,OpenAI 于 2020 年发布的 GPT‑3(Generative Pre‑tr
ained Transformer 3)无疑是一个里程碑。它以惊人的 1750 亿(175 billion)参数规模,展示了大型语言模型的强大能力,能在几乎无需额外训练的情况下完成翻译、写作、推理等多种任务。这篇论文《Language Models are Few‑Shot Learners》让全球震惊:一个模型竟能“少样本学习”(few‑shot learning),仅通过几句提示就能表现出色。
但这个“1750 亿参数”到底是什么?它不是神秘的黑箱数字,而是模型中所有可训练权重的总和。这些参数主要来自神经网络的权重矩阵和偏置项,通过海量数据训练优化而成。简单一句话:1750 亿参数 = Transformer 主体(多层注意力与前馈网络) + 词嵌入矩阵 + 输出投影矩阵 + 层归一化与偏置等小项的总和。其中,绝大部分(约 98%)藏在 96 层 Transformer 块中。
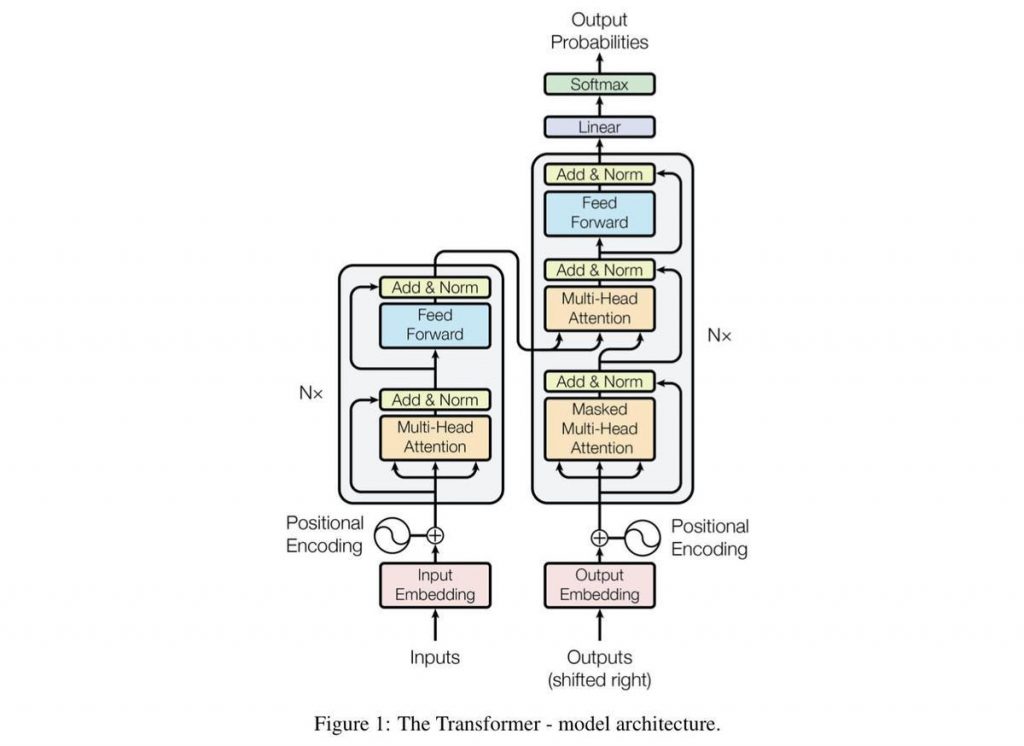
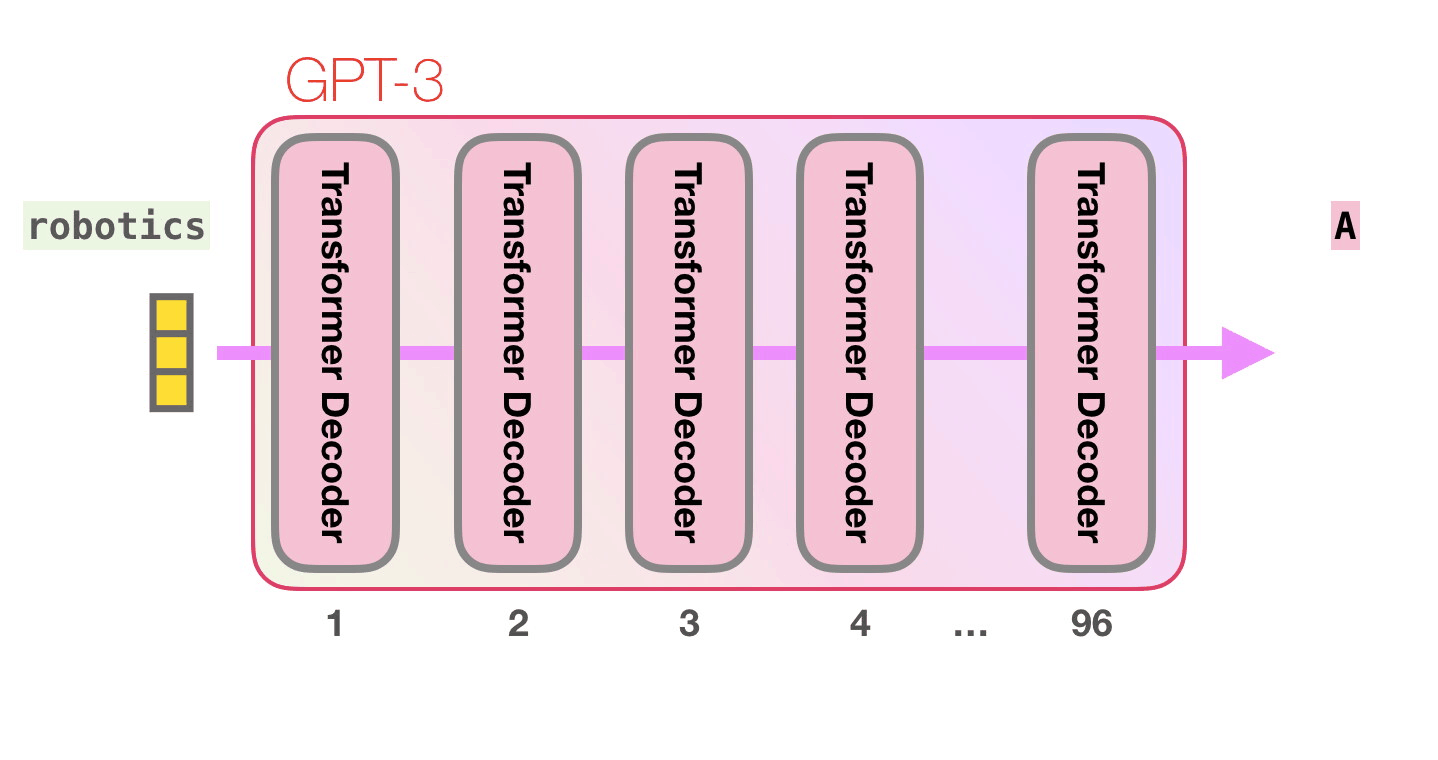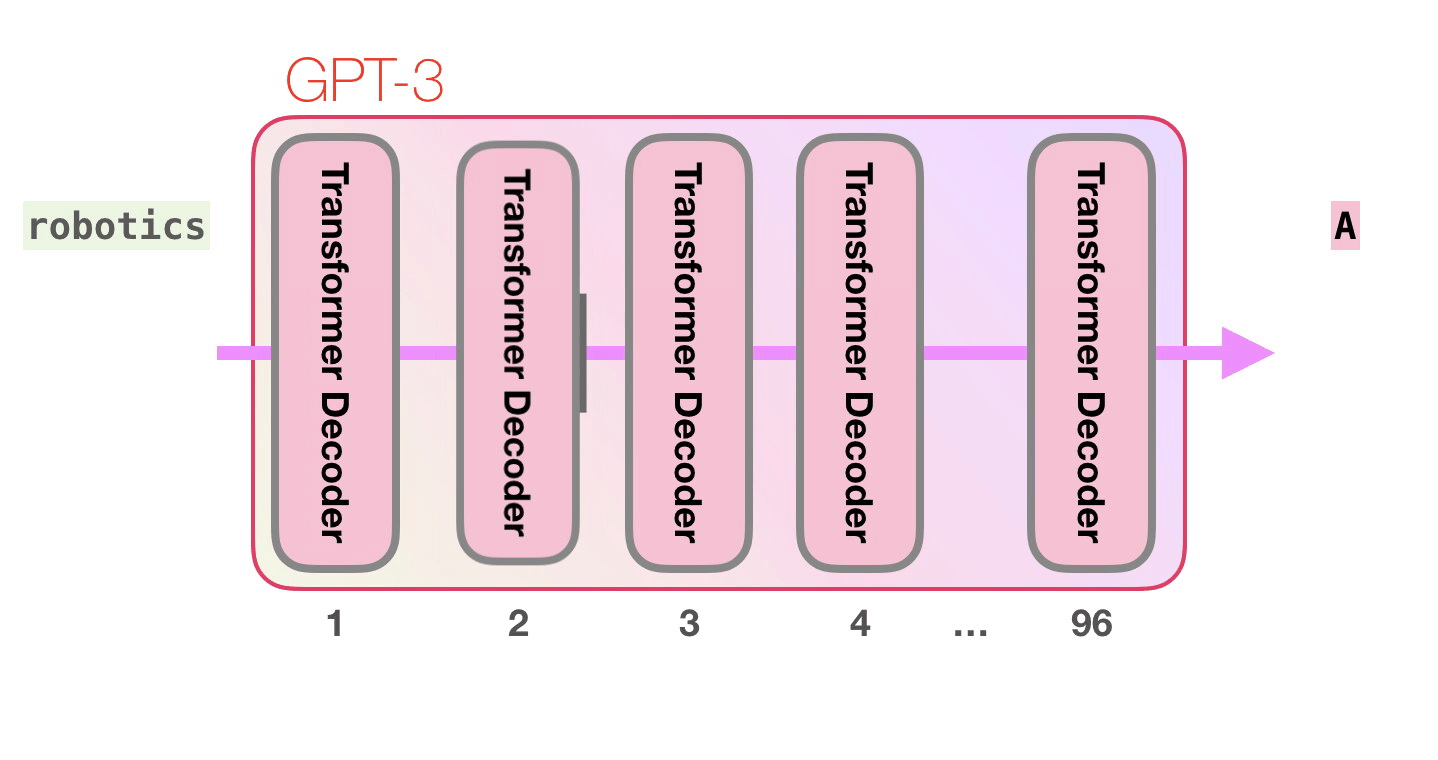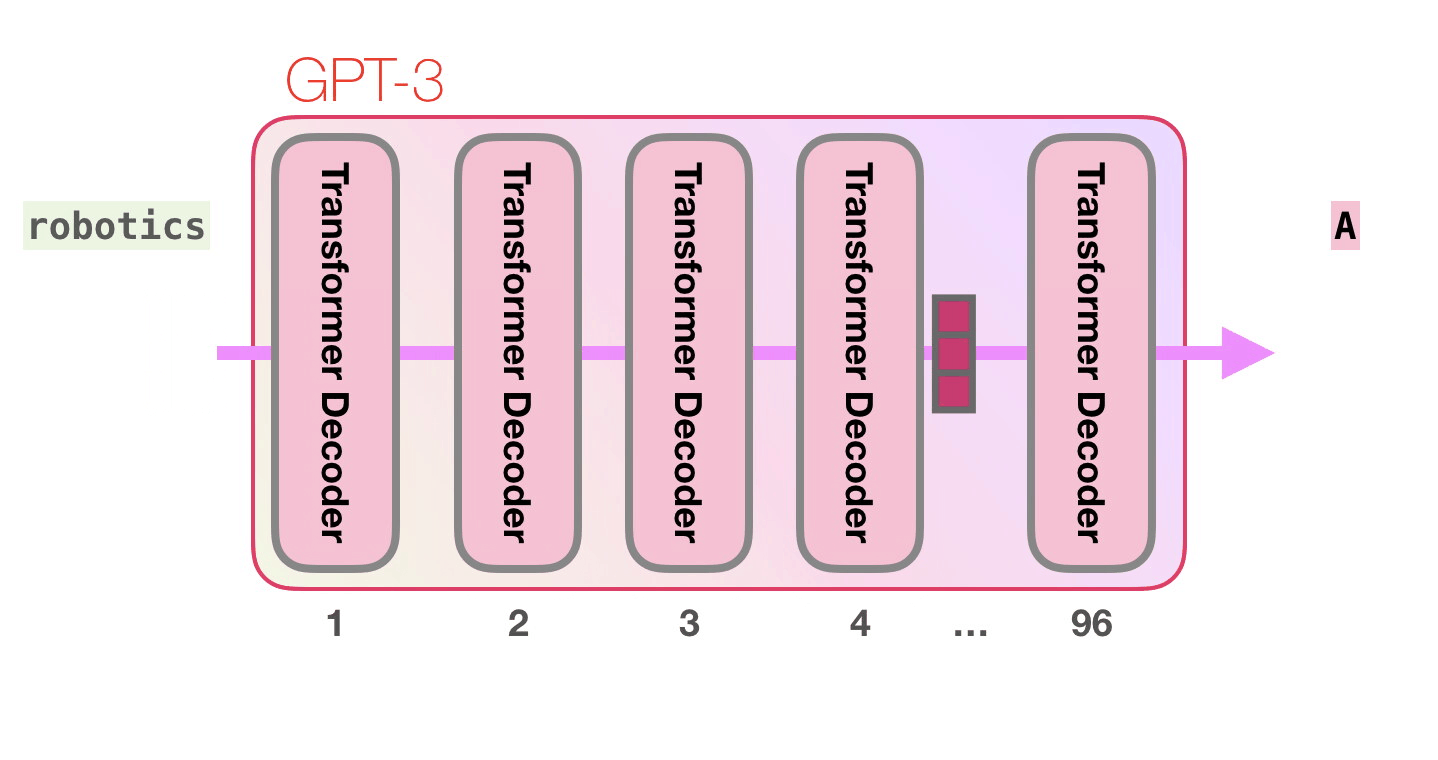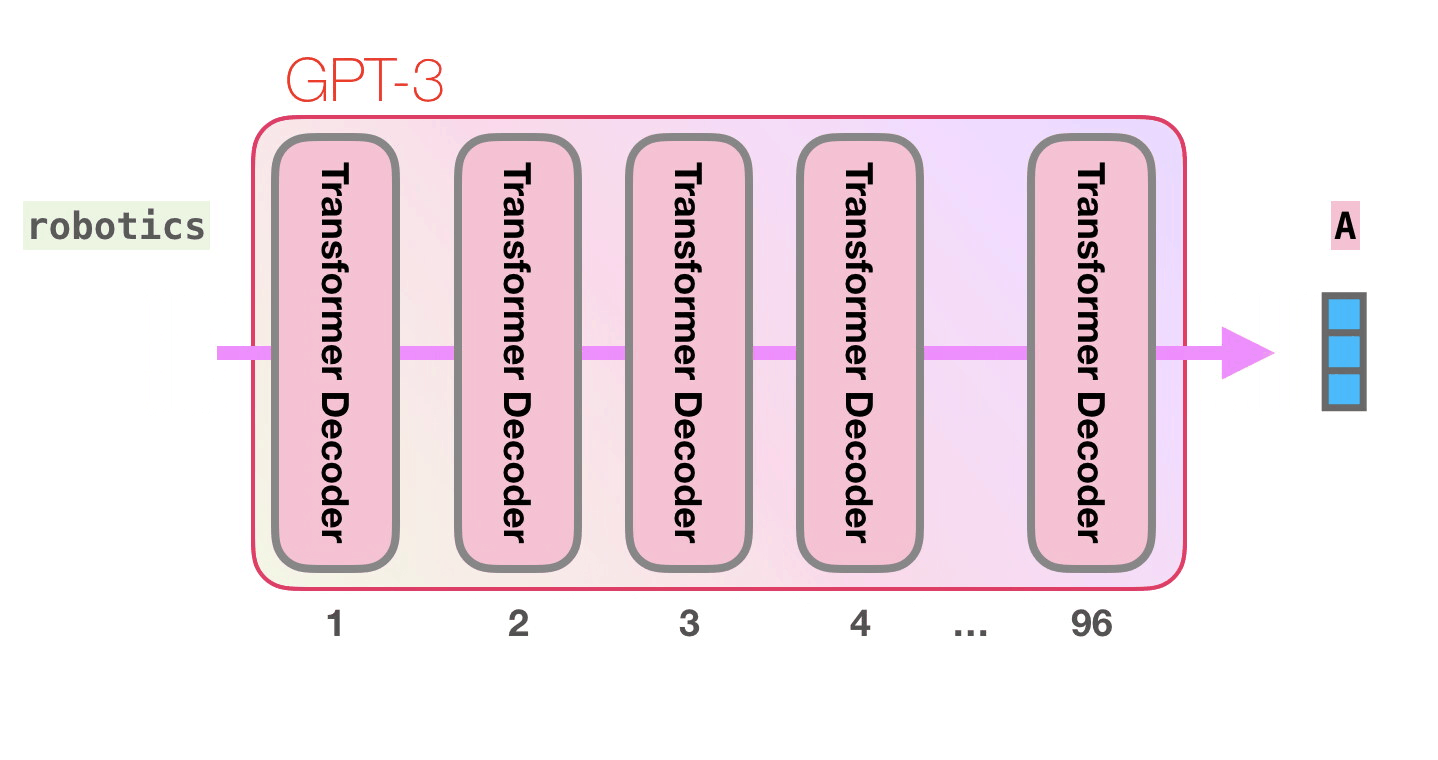
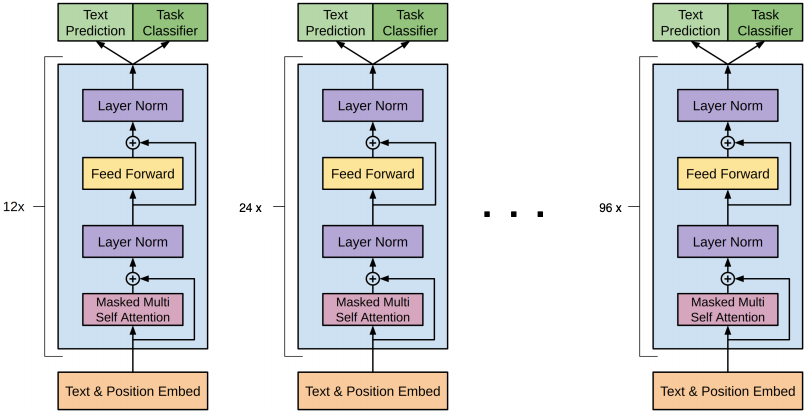
GPT‑3 的核心架构:Decoder‑only Transformer
GPT‑3 是基于 Transformer 架构的“单解码器”模型(decoder‑only),继承自 GPT‑2,但规模放大数百倍。其最大版本(175B)关键超参数如下:
- 层数(Transformer 块):96 层
- 隐藏维度(d_model):12288(每个 token 的向量表示维度)
- 注意力头数:96 个(每头维度 128,96 × 128 = 12288)
- 前馈网络中间维度(d_ff):49152(约 4 × 12288)
- 上下文长度:2048 token
- 词汇表大小:约 50257(使用 Byte‑Pair Encoding 分词)
模型结构简化为:输入词嵌入 → 96 层 Transformer 块 → 输出投影(生成下一个 token 的概率)。
参数来源详解:一步步计算 1750 亿
参数主要分布在三个部分,我们用精确数字计算(基于官方论文和社区验证):
- 词嵌入层(Token Embedding)
- 将词汇表中的每个 token 映射为 12288 维向量。
- 计算:词汇量 × 隐藏维度 = 50257 × 12288 ≈ 617,558,016(约 6.18 亿)
- 此外,还有位置嵌入(positional embedding):上下文长度 × 隐藏维度 = 2048 × 12288 ≈ 25,165,824(约 0.25 亿,通常忽略不计)。
- 占比:约 0.35%(极小部分)。
- Transformer 主体层(96 层核心)
- 这是参数“大头”,每层包括两个子模块:
- 多头自注意力(Multi‑Head Self‑Attention) 包含 Query、Key、Value 和 Output 四个投影矩阵。 标准计算:4 × d_model²(因为头数 × 头维度 = d_model,等价于 4 个全尺寸矩阵)。 每层:4 × 12288 × 12288 ≈ 603,979,776(约 6.04 亿) 加上偏置等小项,约 0.6 亿/层。
- 前馈网络(Feed‑Forward Network, FFN) 两层线性变换:d_model → d_ff → d_model。 计算:(12288 × 49152) + (49152 × 12288) ≈ 1,207,959,552(约 12.08 亿) 加上偏置,约 12 亿/层。
- 每层小项:层归一化(LayerNorm)和偏置,约占 0.1%,可忽略。
- 单层总参数:注意力 ≈ 6 亿 + FFN ≈ 12 亿 = 约 18 亿。
- 96 层总计:18 亿 × 96 ≈ 172.8 亿(精确计算约 173.95 亿)。
- 占比:约 98‑99%,其中 FFN 占 2/3,注意力占 1/3。
- 输出层(Language Model Head)
- 将隐藏状态投影回词汇表大小,生成下一个 token 的概率。
- 在 GPT‑2 中与嵌入共享权重(tied),参数为 0;但 GPT‑3 未共享。
- 计算:12288 × 50257 ≈ 617,558,016(约 6.18 亿)。
- 占比:约 0.35%。
总和:嵌入 ≈ 6.18 亿 + Transformer 层 ≈ 173.95 亿 + 输出 ≈ 6.18 亿 + 小项 ≈ 174.56 亿 ≈ 1750 亿参数(官方四舍五入)。
参数比例大致:Transformer 层占 98%,嵌入 + 输出占 0.7%,其余偏置/LayerNorm 微乎其微。
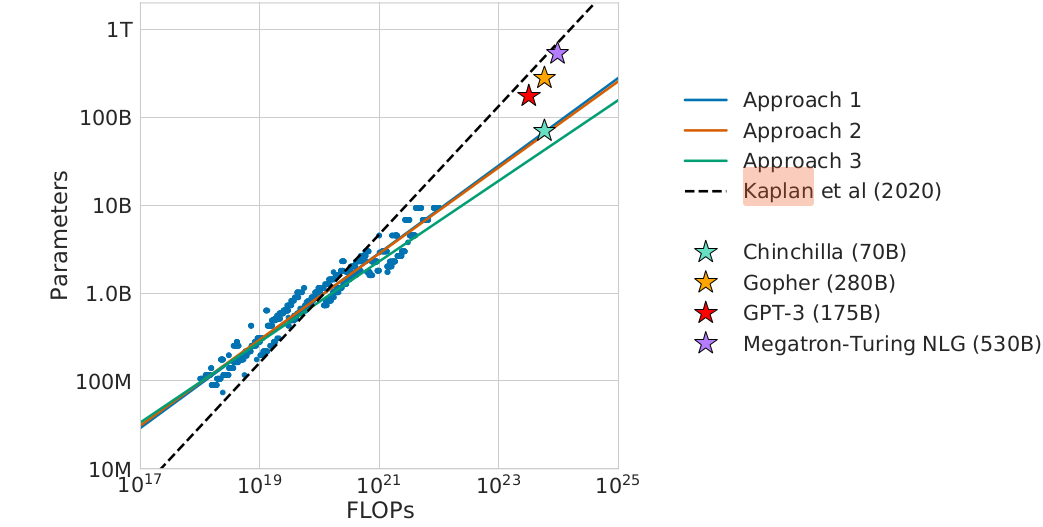
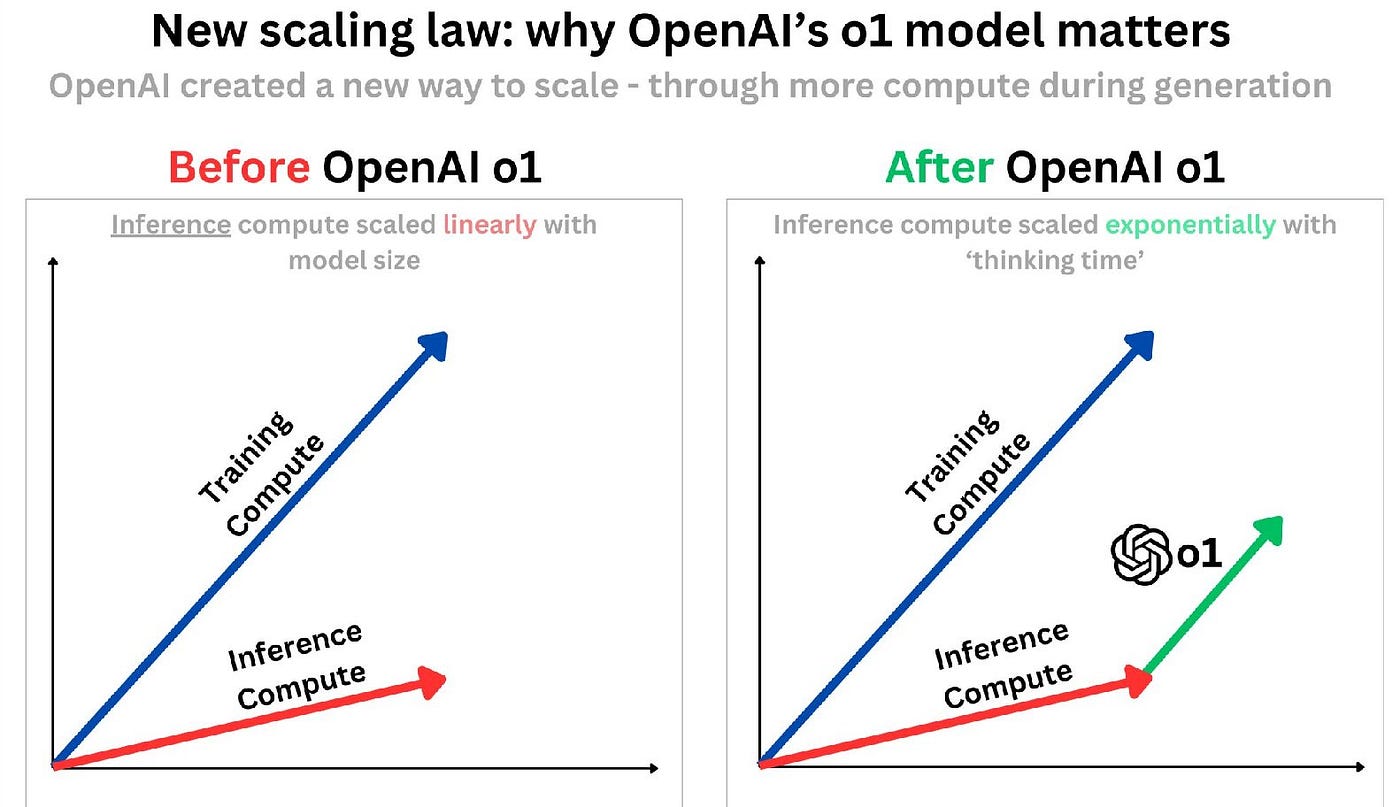
为什么参数这么多?背后的“缩放定律”
OpenAI 并非随意选择这些数字,而是遵循“缩放定律”(Scaling Laws):模型参数量、数据量与计算量增大时,性能呈幂律提升(power‑law)。从 GPT‑2 的 15 亿参数跃升到 1750 亿,正是为了捕捉语言的复杂规律,实现“涌现能力”(emergent abilities)——如无需微调就能进行少样本学习。
选择 12288 维、96 层、96 头,是计算资源与工程平衡的结果:当时使用数千块 NVIDIA V100 GPU,训练耗时数周、成本数百万美元。再大,就面临指数级成本上升。
参数的意义:像大脑的“突触”
类比人类大脑(约 100 万亿突触),这些参数是模型的“连接强度”。更多参数意味着更大“容量”:能存储更复杂的语言模式、语法、知识和推理路径。这就是为什么 GPT‑3 在规模跃升后,突然具备翻译、写诗、简单算术等能力——规模带来质变。
由于参数是LLM的核心,目前业界领先的闭源LLM都没有再公布具体的参数值及如何构成,而开源大模型的参数值大都在几千亿到两万亿之间,这是综合平衡了效率与性能的结果。
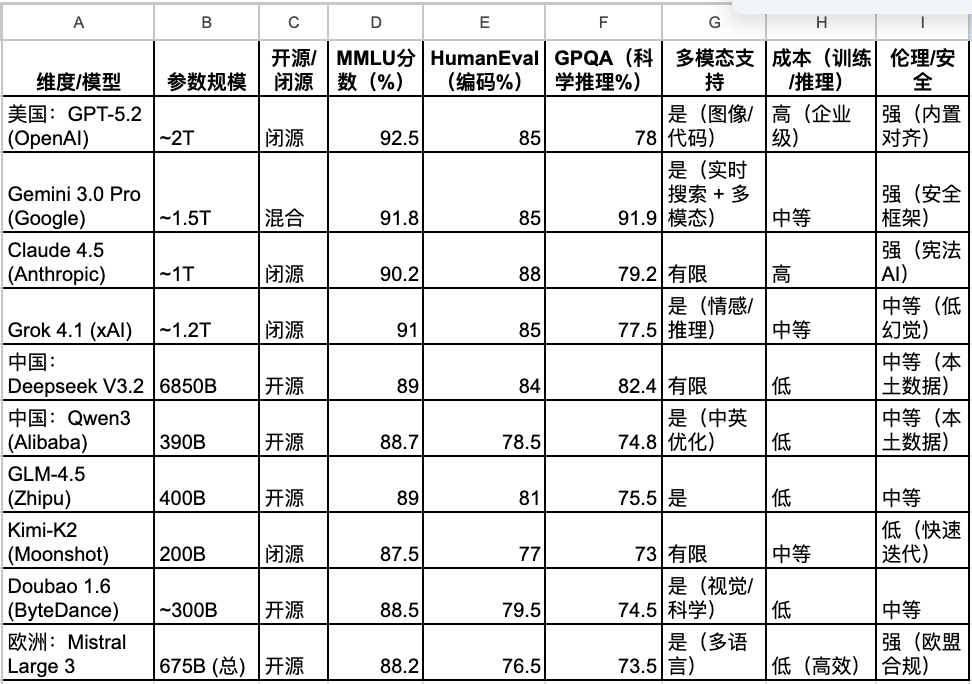
2025年全球十大LLM盘点:美国、中国与欧洲Mistral的全面对比、分析及展望
结语:规模是王道,但并非唯一
GPT‑3 的 1750 亿参数证明:单纯放大模型,就能解锁惊人智能。这启发了后续模型如 GPT‑4。但今天,我们也看到效率优化(如稀疏模型、量化)的重要性。参数虽多,却大多来自重复的 Transformer 层——这也是大型语言模型的核心秘密。理解这些数字,不仅揭开 GPT‑3 的面纱,也让我们窥见 AI 未来的缩放之路。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com