
自 2020 年 OpenAI 发布 GPT‑3 以来,这款大型语言模型(LLM)以其惊人的 1750 亿(175 billion)参数规模引发了全球关注,迅速吸引了上亿用户。1750 亿参数的数字并非随意宣称,而是基于 Transformer 架构的规模化设计精心计算的结果。本文将详细解析这一数字的来源,结合技术细节和推理,确保准确且通俗易懂。
1. GPT‑3 的架构概述
GPT‑3 是一个基于 Transformer 的解码器(decoder‑only)模型,包含多个堆叠的 Transformer 层(layers)。每个层由多头自注意力机制(multi‑head self‑attention)和前馈神经网络(feed‑forward neural networks, FFN)组成。参数主要分布在以下几个部分:
- 嵌入层(Embedding Layer):将输入 token 映射到高维向量。
- 注意力机制(Attention Mechanism):包括查询(Query)、键(Key)、值(Value)矩阵和输出投影矩阵。
- 前馈网络(Feed‑Forward Networks):每个 Transformer 层中的全连接网络。
- 层归一化(Layer Normalization):用于稳定训练的参数。
- 输出层(Output Layer):将隐藏状态映射回词汇表以生成预测。
2. Transformer 的参数构成
GPT 系列是基于 Transformer Decoder 的架构,每层主要有以下参数:
1、自注意力层 (Self‑Attention)
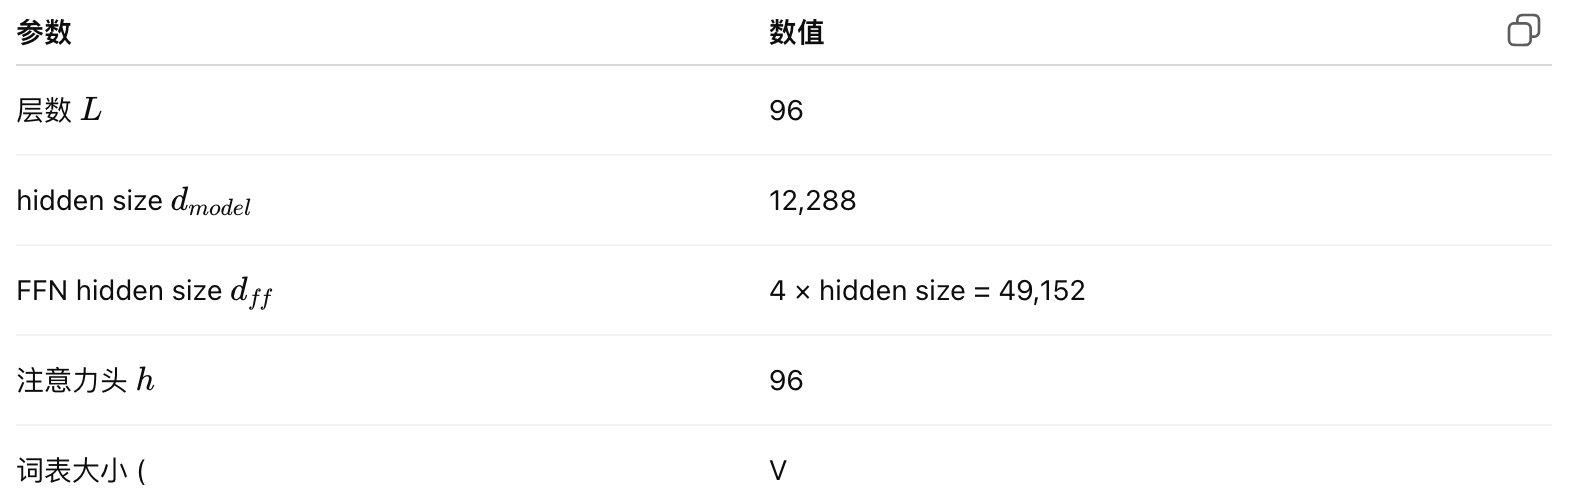
每个注意力头有三个权重矩阵: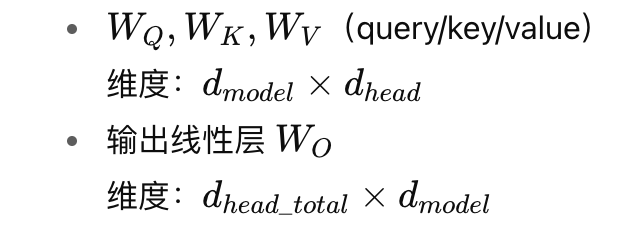 如果有 ( h ) 个注意力头(注意力头数(Attention Heads, h h h):96,每头维度=12,288/96=128。):
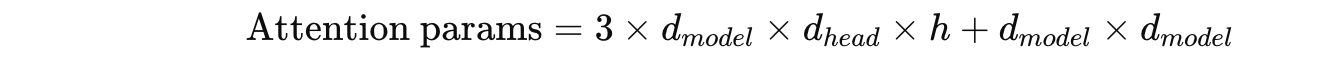
2、前馈网络 (Feed‑Forward Network, FFN)
每层有两段线性变换:
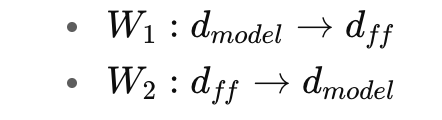
- 参数量:
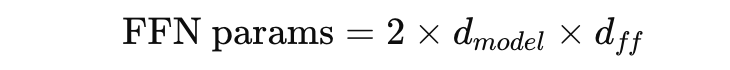
3、LayerNorm
每层两个 LayerNorm,每个有 scale 和 bias:
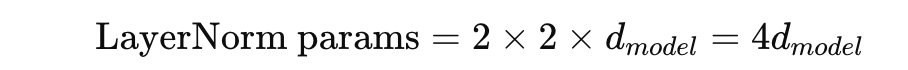
4、词表嵌入 (Embedding)

- 词汇表大小(Vocabulary Size, V):约 50,257(基于字节对编码,BPE)。
3. GPT‑3 架构参数
以 GPT‑3 175B(1750 亿参数) 为例,官方表格显示:
3.1 自注意力层参数
每层:
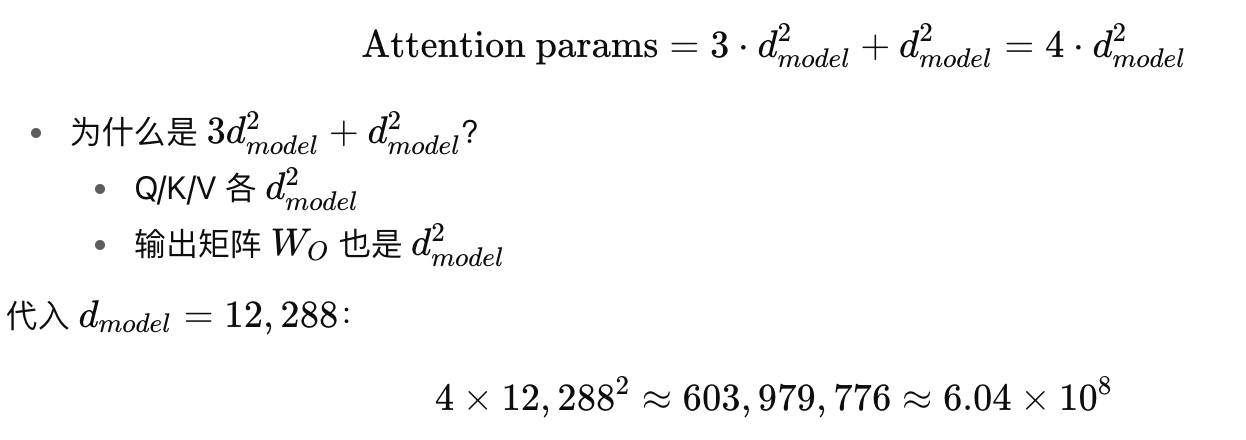
约 6 亿参数/层(注意这是粗略计算,实际考虑分头和 bias 会略多)。
3.2 前馈网络参数
每层:
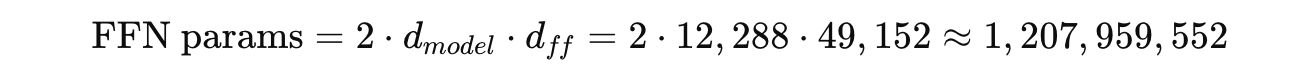
约 12 亿参数/层。
3.3 总层参数
每层总参数:
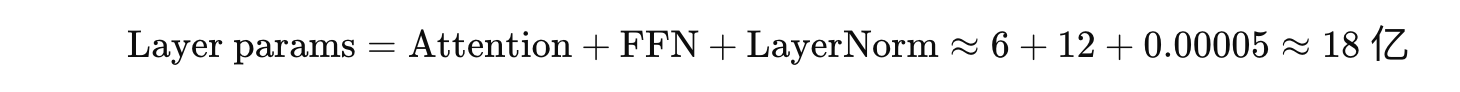
乘以 96 层:
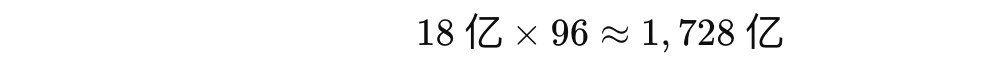
再加上嵌入层(词向量矩阵 12,288 × 50,257 ≈ 6.2 亿)
总和约 1,750 亿参数。
4. 总结
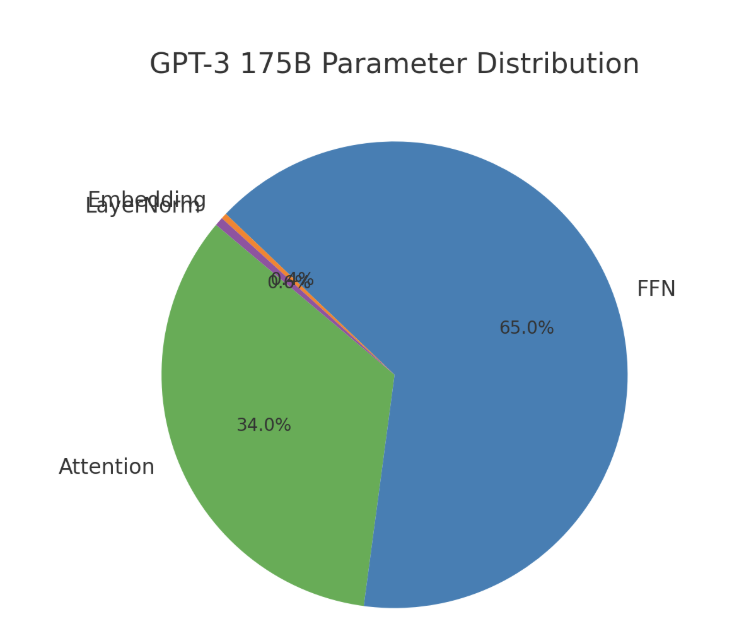
- GPT‑3.5 / GPT‑3 175B 参数量来源于:
- 层数 ×(每层 Attention + FFN + LayerNorm 参数)
- 加上嵌入矩阵
- Attention 和 FFN 是主力,占比超过 90%
- 层数和 hidden size 决定参数量
- 词表大小稍微影响总参数,但不如 hidden size 关键