
2026年3月24日,谷歌研究院(Google Research)正式发布TurboQuant算法,这是一项专为大型语言模型(LLM)和向量搜索引擎设计的先进向量量化压缩技术。核心成果令人惊叹:在无需任何训练或微调的前提下,将LLM推理阶段的关键值缓存(KV Cache)内存占用压缩至至少6倍(可量化至3比特/值),同时在NVIDIA H100 GPU上实现最高8倍注意力logits计算加速,且模型下游任务精度零损失。
这一突破由谷歌研究院科学家Amir Zandieh与副总裁兼Google Fellow Vahab Mirrokni领导,相关论文《TurboQuant: Online Vector Quantization with Near‑optimal Distortion Rate》(arXiv:2504.19874)将于2026年ICLR会议正式发表。它还融合了PolarQuant(AISTATS 2026)和Quantized Johnson‑Lindenstrauss(QJL,AAAI 2025)两项伴随技术,被视为AI效率领域的“软件级革命”。
KV缓存瓶颈:AI推理的“隐形杀手”
在Transformer架构的LLM推理中,KV缓存负责存储先前token的键(Key)和值(Value)向量,避免重复计算注意力机制。随着上下文长度从数千扩展至数十万token,KV缓存内存呈线性爆炸式增长,成为制约长上下文、批量推理和边缘部署的最大瓶颈。传统量化方法虽能压缩,但往往引入精度损失、额外内存开销(需存储归一化常数),或依赖数据特定训练,无法在线实时应用。TurboQuant正是在此背景下,以数据无关(data‑oblivious)、在线(online)方式实现了理论近最优的极致压缩。
原理详解:PolarQuant高质压缩 + QJL 1比特残差校正
TurboQuant的核心是两阶段管道,巧妙融合随机旋转、极坐标变换与Johnson‑Lindenstrauss(JL)变换,实现MSE(均方误差)和内积(inner product)失真率的双重近最优,同时消除传统量化的内存 overhead。
第一阶段:PolarQuant——高质量标量量化(核心压缩)
算法首先对输入向量x∈Rd \mathbf{x} \in \mathbb{R}^d x∈Rd施加随机旋转(通过高斯矩阵QR分解实现),将坐标投影至单位球面。这一步诱导每个坐标服从已知且集中的Beta分布(高维极限下近似高斯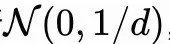 ,坐标间近似独立)。
随后,将坐标对映射为极坐标系(半径捕捉幅度,角度捕捉方向),跳过传统Cartesian量化所需的逐数据归一化步骤(这一步通常需额外1‑2比特存储常数)。利用Beta分布的可预测性,对每个坐标独立应用最优标量量化器(Lloyd‑Max算法,预计算码本),将向量压缩至低比特(例如3比特)。
去量化时,仅需查表并反旋转即可恢复向量。数学上,该阶段MSE失真上界为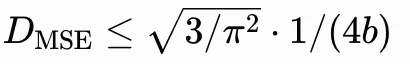 (b为比特数),接近信息论下界(因子约2.7)。PolarQuant单独使用已接近无损,尤其在“needle‑in‑a‑haystack”任务中表现优异。
第二阶段:QJL——1比特残差校正(消除内积偏差)
单纯MSE量化会引入注意力分数偏差(例如1比特时偏差达2/π 2/\pi 2/π)。TurboQuant因此在残差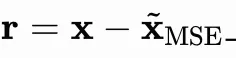 上额外施加量化Johnson‑Lindenstrauss变换(QJL):用1比特(符号位+1/‑1)量化残差,再通过特殊无偏估计器恢复内积。
这一步仅消耗1比特,却彻底消除偏差,保证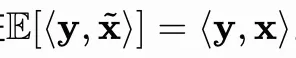 。内积失真同样接近理论下界。整个过程时间复杂度为O(d),空间开销极低(码本预存,常数级),完全适合GPU加速器和在线推理。Arxiv
两阶段协同使TurboQuant在3比特下实现“零精度损失”,远超传统Product Quantization(PQ)或KIVI等方法,且无需数据集调优或预处理。
实验验证:真实世界零妥协
在Gemma、Mistral、Llama‑3.1‑8B等开源模型上,TurboQuant经受LongBench、Needle‑in‑Haystack(4k‑104k token)、RULER、ZeroSCROLLS等严苛长上下文基准考验:
- 内存压缩:KV缓存降至至少6倍(3比特/值),Llama‑3.1‑8B在0.25内存预算下仍达完美recall。
- 速度提升:4比特模式下,H100 GPU注意力计算较32比特基线提速最高8倍,整体推理快于原始模型,运行时开销可忽略。
- 精度:问答、代码生成、摘要任务零损失;向量搜索(GloVe数据集)recall@1@k优于PQ/RabbiQ,且索引时间接近零(0.0007‑0.0021秒 vs 数十秒)。
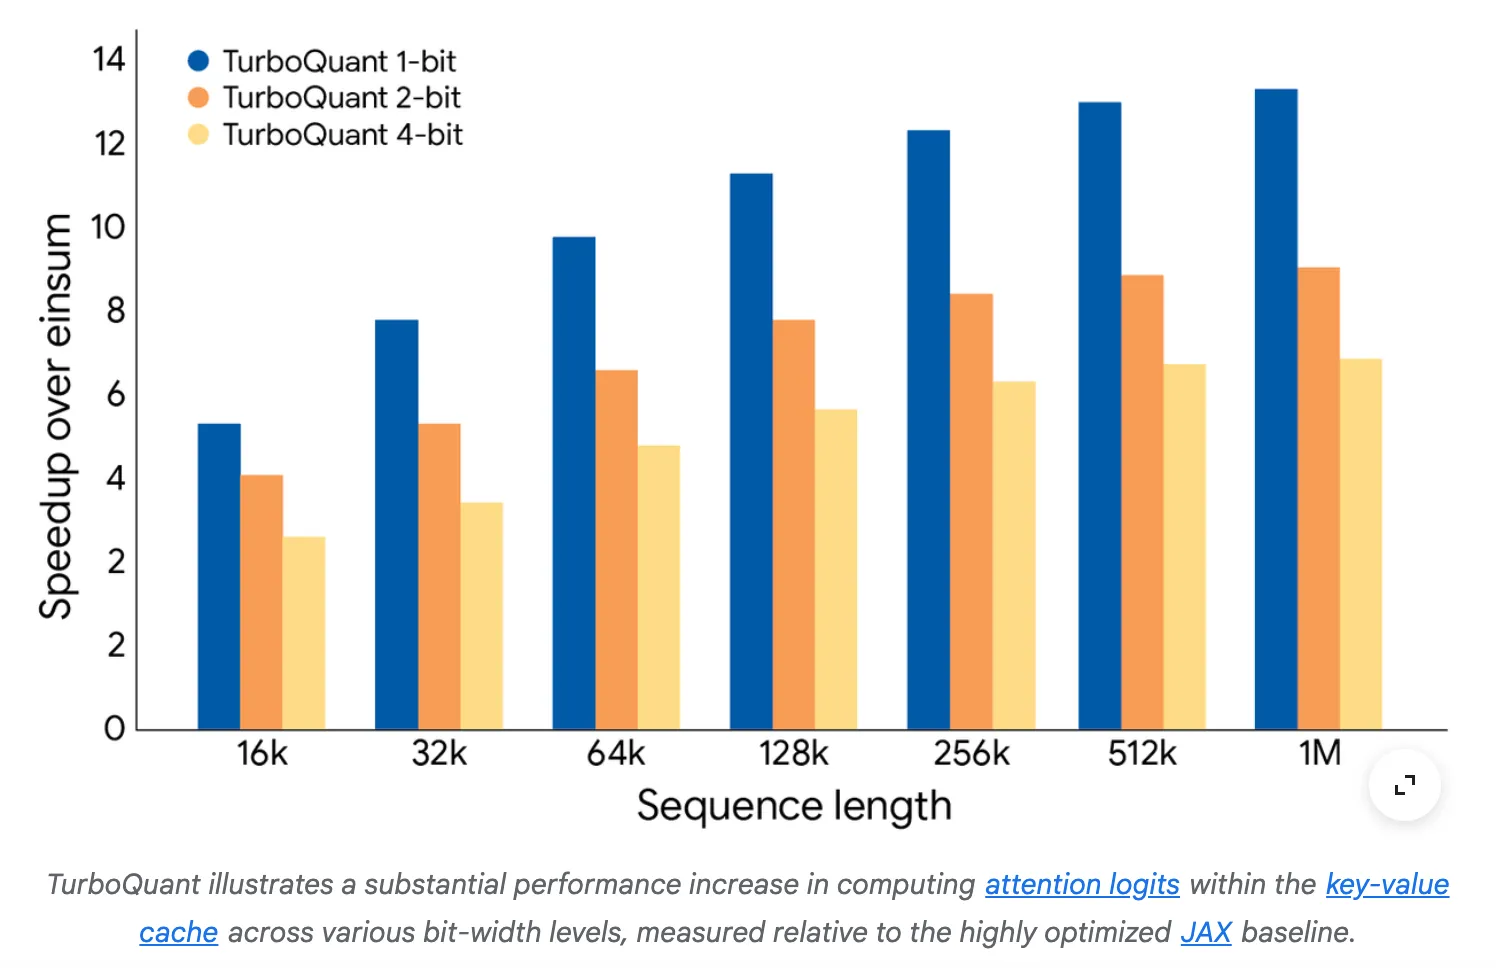
深远影响:AI部署范式重塑与产业连锁反应
1. 推理效率与成本革命
企业可显著降低云算力开销——相同硬件支持更长上下文或更大批量,VentureBeat分析称部署成本有望下降50%以上。RAG(检索增强生成)、长文档处理等场景将迎来爆发式应用。
2. 硬件需求与边缘化部署
软件优化直接缓解HBM(高带宽内存)压力,内存供应商(如Micron、Western Digital)股价在公告后短期承压。未来,消费级设备(如Mac Mini)或手机即可高效运行十万token级模型,推动AI从云端走向本地隐私部署。
3. 向量搜索与搜索体验升级
索引构建速度大幅提升,谷歌可更高效实现语义搜索,从关键词向意图理解跃迁,对整个搜索引擎产业构成示范。
4. 行业格局与伦理考量
TurboQuant开源可用(研究框架下免费),加速开源社区与企业落地,但也凸显“算法效率”正成为AI竞争新赛道。长期看,它助力AI可持续发展,降低能耗与碳足迹;短期则可能重塑GPU/内存供应链。谷歌计划将其扩展至Gemini等自有模型,进一步放大影响。
结语:AI效率的“软件核聚变”
TurboQuant并非简单量化,而是以严谨数学(Beta分布、无偏估计、近最优失真界)重构向量压缩范式,彻底破解了“内存‑精度‑速度”三难困境。它证明:即使在后训练时代,纯算法创新仍能带来指数级效率跃迁。未来,随着更多模型集成这一技术,AI将真正迈向“人人可用、处处可及”的普惠阶段——更低门槛、更高性能、更可持续。
谷歌此举再次确立其在AI基础研究领域的领先地位,也为全球开发者提供了免费利器。TurboQuant的落地,或将成为2026年AI基础设施演进的最重要里程碑之一。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com