
在人工智能(AI)迅猛发展的时代,学术引用量已成为衡量研究影响力的关键指标。斯坦福大学“全球顶级2%科学家”列表基于标准化引用数据,遴选出AI与图像处理领域的佼佼者。与斯坦福大学“全球顶级2%科学家”列表的排序不同(该排名主要通过D‑index指数来排名),本文通过Google Scholar的论文总引用数来进行排名,重新聚焦该列表中总引用数前15位AI科学家(2025年数据,考虑到Resnet的巨大影响力和它的四位作者都入选10大,本文将入选科学家总数扩展到15位),每位科学家简要介绍其总引用量及其前三高引论文。每篇论文的描述突出其技术贡献、创新点及对AI发展的影响。这些论文不仅是引用高峰,还驱动了从图像识别到自然语言处理的实际应用,体现了这些学者的全球领导力。
1. Yoshua Bengio(蒙特利尔大学,加拿大) ‑ 总引用:1,027,145
Yoshua Bengio,生于1964年巴黎,是加拿大计算机科学家,被誉为AI“三巨头”之一,推动深度学习从边缘到主流。他于蒙特利尔大学任教授,并创立Mila魁北克AI研究所,领导全球最大AI研究机构之一,培养了众多顶尖人才如Ian Goodfellow。他的开创性工作包括生成对抗网络和词嵌入模型,革命化了自然语言处理和生成AI应用;作为2018年图灵奖得主,他积极倡导AI安全与伦理,2023年签署暂停超大规模模型训练的公开信,并在2025年成为首位在世引用破百万的科学家,继续影响全球AI政策。 他的前三高引论文详述如下:
- 《Deep Learning》(2015,与Hinton和LeCun合著):这篇Nature杂志综述系统阐述了深度学习的原理、算法和应用,包括神经网络架构、训练方法如反向传播,以及在图像、语音和自然语言处理中的潜力。论文强调深度模型在捕捉复杂层次特征的优势,标志着AI从浅层学习向深度学习的范式转变,推动了后续如Transformer模型的发展,广泛应用于计算机视觉和推荐系统等领域。
- 《Generative Adversarial Nets》(2014,与Goodfellow等合著):论文引入生成对抗网络(GAN)框架,由生成器和判别器通过对抗训练生成逼真数据。详细讨论了最小最大博弈优化、训练稳定性问题,以及在图像合成、风格迁移和数据增强中的应用。这一创新解决了传统生成模型的局限,推动了无监督学习前沿,影响了DALL·E等工具的诞生,并在艺术创作和医疗图像生成中广泛采用。
- 《A Neural Probabilistic Language Model》(2003):该文提出神经概率语言模型,使用神经网络学习词向量嵌入,取代传统n‑gram模型。论文探讨了分布式表示的优势、训练算法和在连续空间中捕捉语义相似性的机制。这一工作奠定了词嵌入技术基础,如Word2Vec的前身,推动了自然语言处理从统计向神经范式的演进,应用于机器翻译和情感分析等领域。
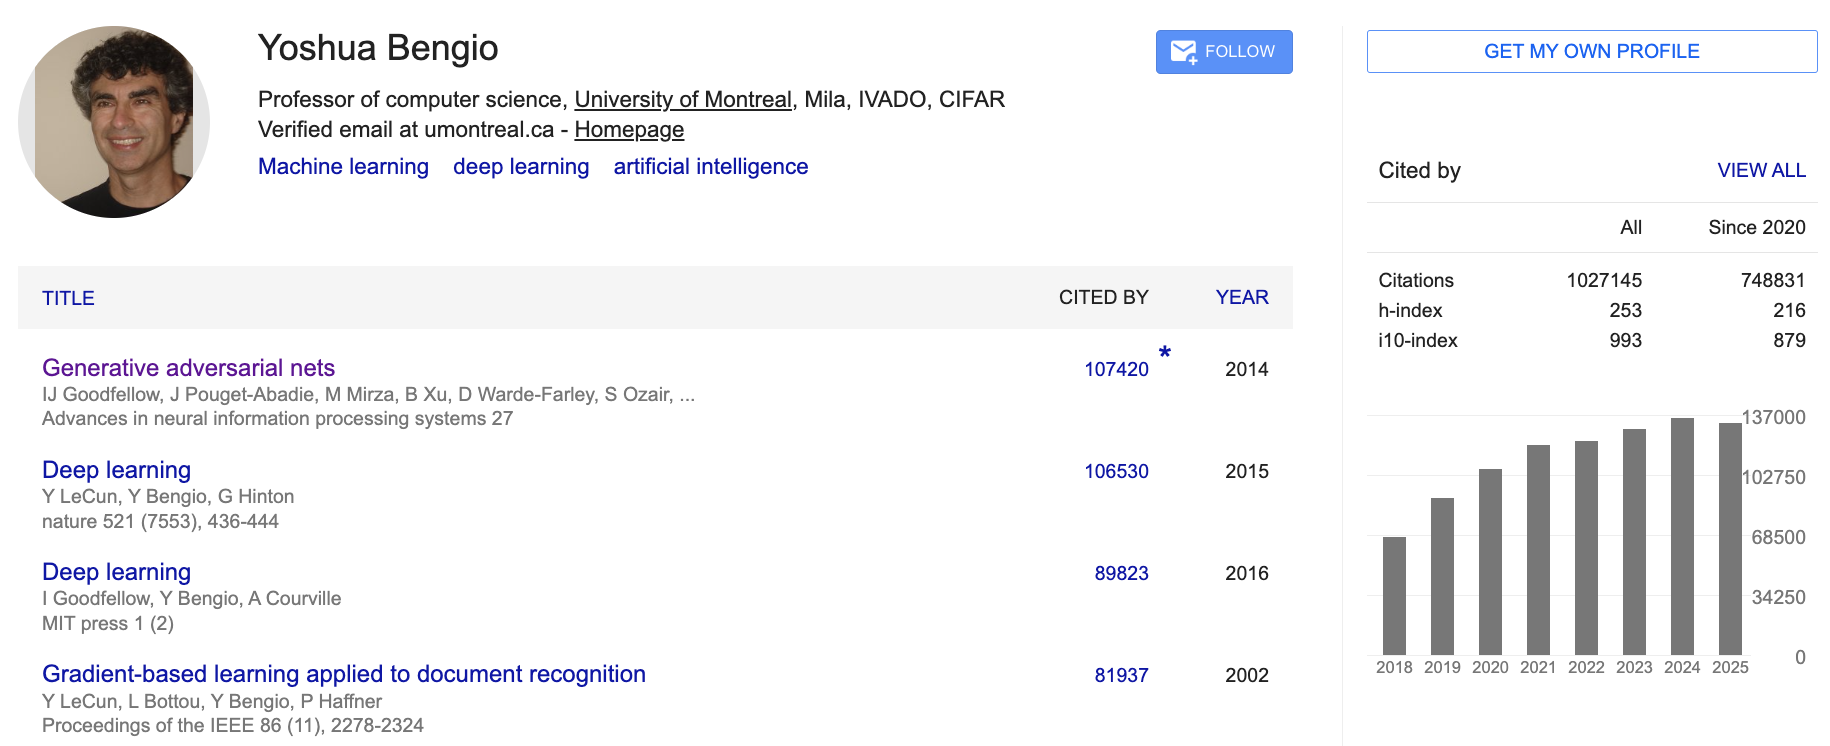
(注:本文截图全部来自Google Scholar网站)
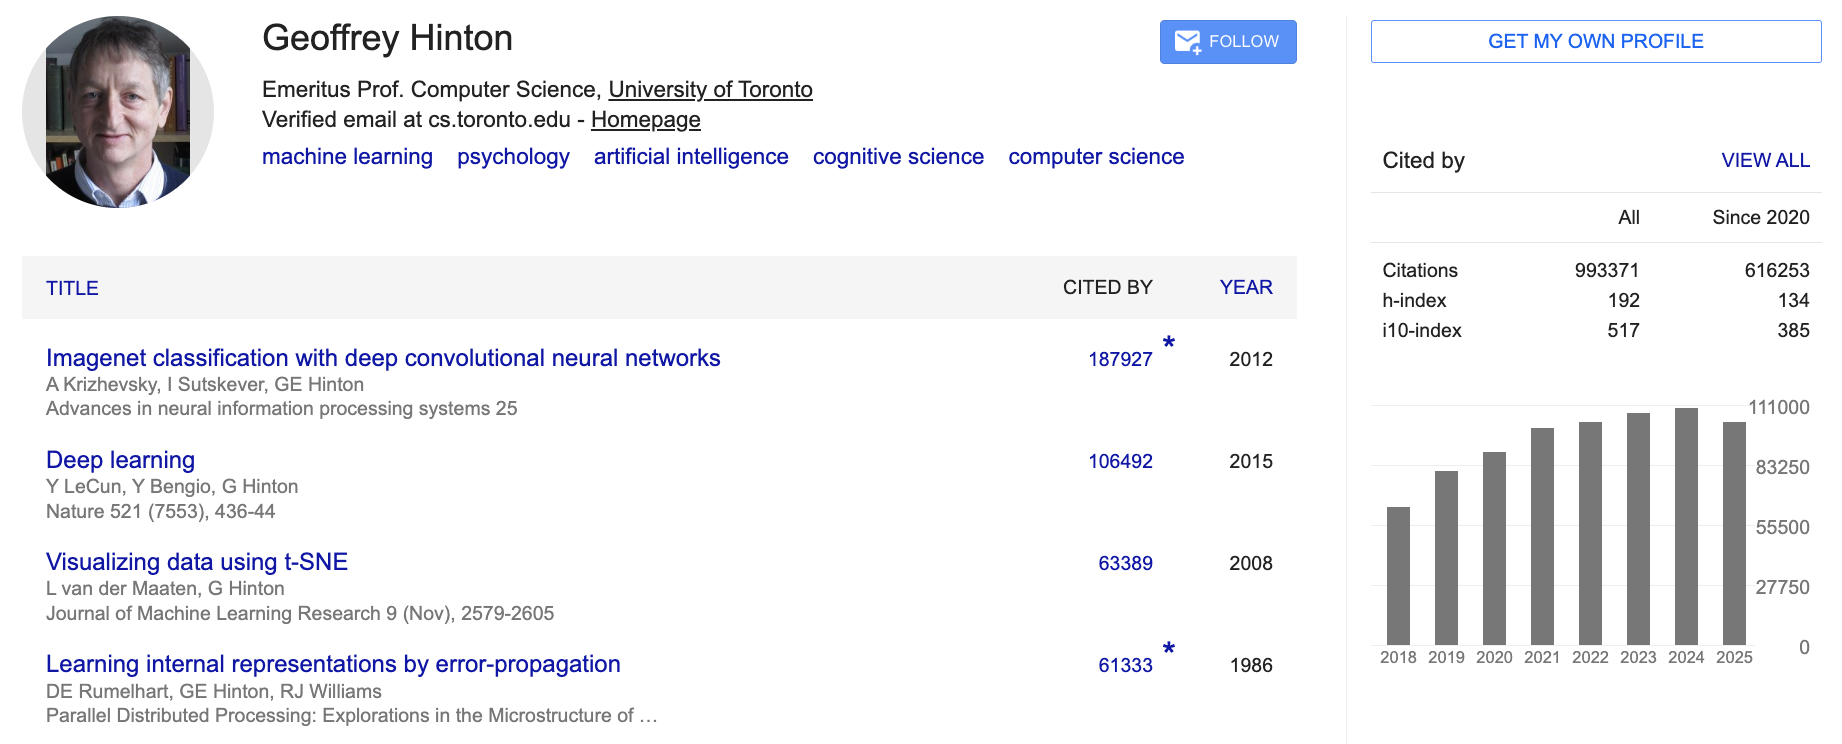
2. Geoffrey E. Hinton(多伦多大学,加拿大) ‑ 总引用:993,371
Geoffrey E. Hinton,生于1947年英国,是多伦多大学名誉教授,被誉为“AI教父”,其工作奠定神经网络核心,他凭借上世纪80年代发明的反向传播算法获得了2024年诺贝尔物理学奖。作为深度学习先驱,他发明了Boltzmann机和胶囊网络,推动AI从冬眠期复兴,并指导了Ilya Sutskever等弟子。Hinton于2023年从Google离职,警告AI风险,强调控制超智能系统的必要性;他的成就包括2018年图灵奖和2024年诺贝尔奖,继续在AI安全和伦理领域发声。 他的前三高引论文分析如下:
- 《Deep Learning》(2015,与Bengio和LeCun合著):这篇综述详细介绍了深度神经网络的数学基础、优化技术如随机梯度下降,以及在多层感知器中的应用。论文强调深度架构在处理非线性问题时的优越性,并讨论了过拟合预防策略如dropout,推动AI从学术实验向工业应用的跃进,影响了现代大模型如GPT系列的设计。
- 《ImageNet Classification with Deep Convolutional Neural Networks》(2012,与Krizhevsky和Sutskever合著):论文提出AlexNet架构,使用卷积层和ReLU激活函数在ImageNet数据集上实现突破性准确率。详细阐述了数据增强、GPU并行训练和局部响应归一化等技术。这一创新标志着深度学习在计算机视觉的首次大规模成功,降低了错误率15%,启发了后续ResNet等模型,并在自动驾驶和医疗诊断中广泛应用。
- 《Visualizing Data using t‑SNE》(2008):该文引入t‑SNE算法,通过概率分布转换高维数据到低维空间,实现非线性降维。论文讨论了困惑度参数优化、梯度下降算法和在簇分离中的优势。这一工具帮助可视化复杂数据集如基因表达或图像特征,推动了机器学习的可解释性研究,应用于聚类分析和异常检测等领域。
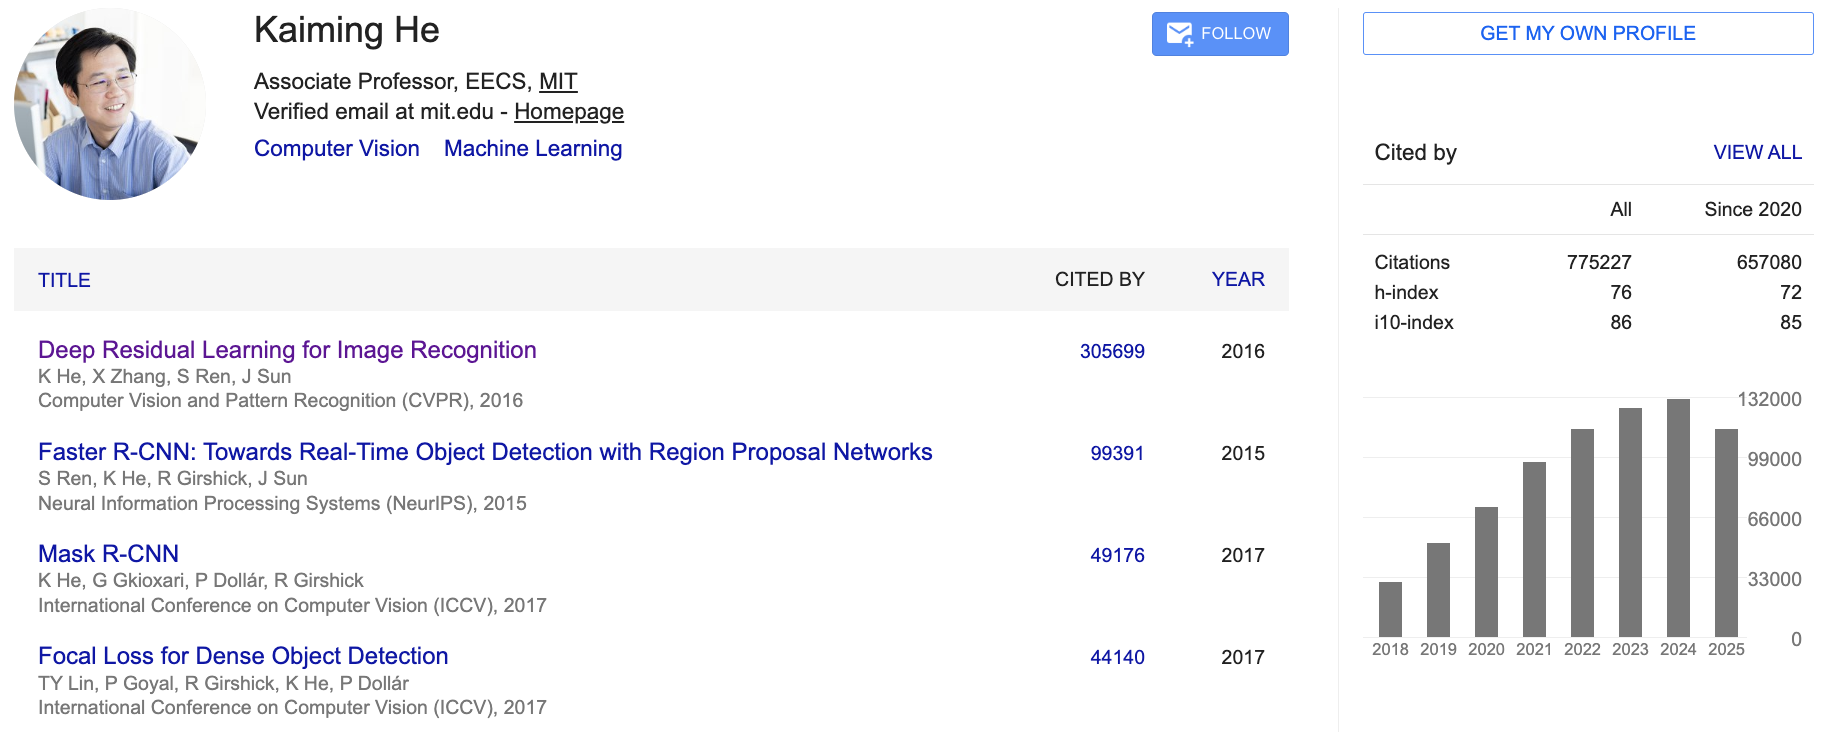
3. Kaiming He(麻省理工学院,美国) ‑ 总引用:775,227
Kaiming He,何凯明,生于1985年中国,是麻省理工学院计算机科学与人工智能实验室教授,专注于计算机视觉和深度学习。他发明了残差网络(ResNet),解决了深度网络训练难题,推动AI模型规模化,并于2023年获未来科学奖和2025年神经信息处理系统会议时间检验奖。作为前Meta研究员,他的研究影响了自动驾驶和医疗影像等领域;2025年,他加入Google DeepMind,继续探索视觉智能和高效AI架构。 他的前三高引论文详解如下:
- 《Deep Residual Learning for Image Recognition》(2016,与Zhang等合著):论文提出残差网络(ResNet),通过跳跃连接缓解梯度消失问题,实现数百层深度模型训练。详细描述了残差块设计、瓶颈架构和在ImageNet上的实验结果。这一突破将错误率降至3.57%,成为深度学习骨干网络,广泛用于目标检测和语义分割,推动了AI在视觉任务的深度化。该论文是截止目前引用数最高的AI论文,也是首篇突破30万次引用的AI科技论文。
- 《Mask R‑CNN》(2017,与Girshick等合著):该文扩展Faster R‑CNN,引入Mask分支实现像素级实例分割。论文阐述了RoIAlign层改进、损失函数设计和在COCO数据集上的多任务训练。这一框架统一了检测、分类和分割,提升了精度,推动了计算机视觉的多模态整合,应用于机器人抓取和医疗图像分析等领域。
- 《Focal Loss for Dense Object Detection》(2017,与Lin等合著):论文引入焦点损失函数,解决密集检测中的类别不平衡问题,通过动态缩放易分类样本的权重。详细讨论了RetinaNet单阶段检测器架构和一阶段 vs. 两阶段的比较。这一创新匹配了双阶段检测器的准确性,推动了实时物体检测的发展,影响了自动驾驶和监控系统。
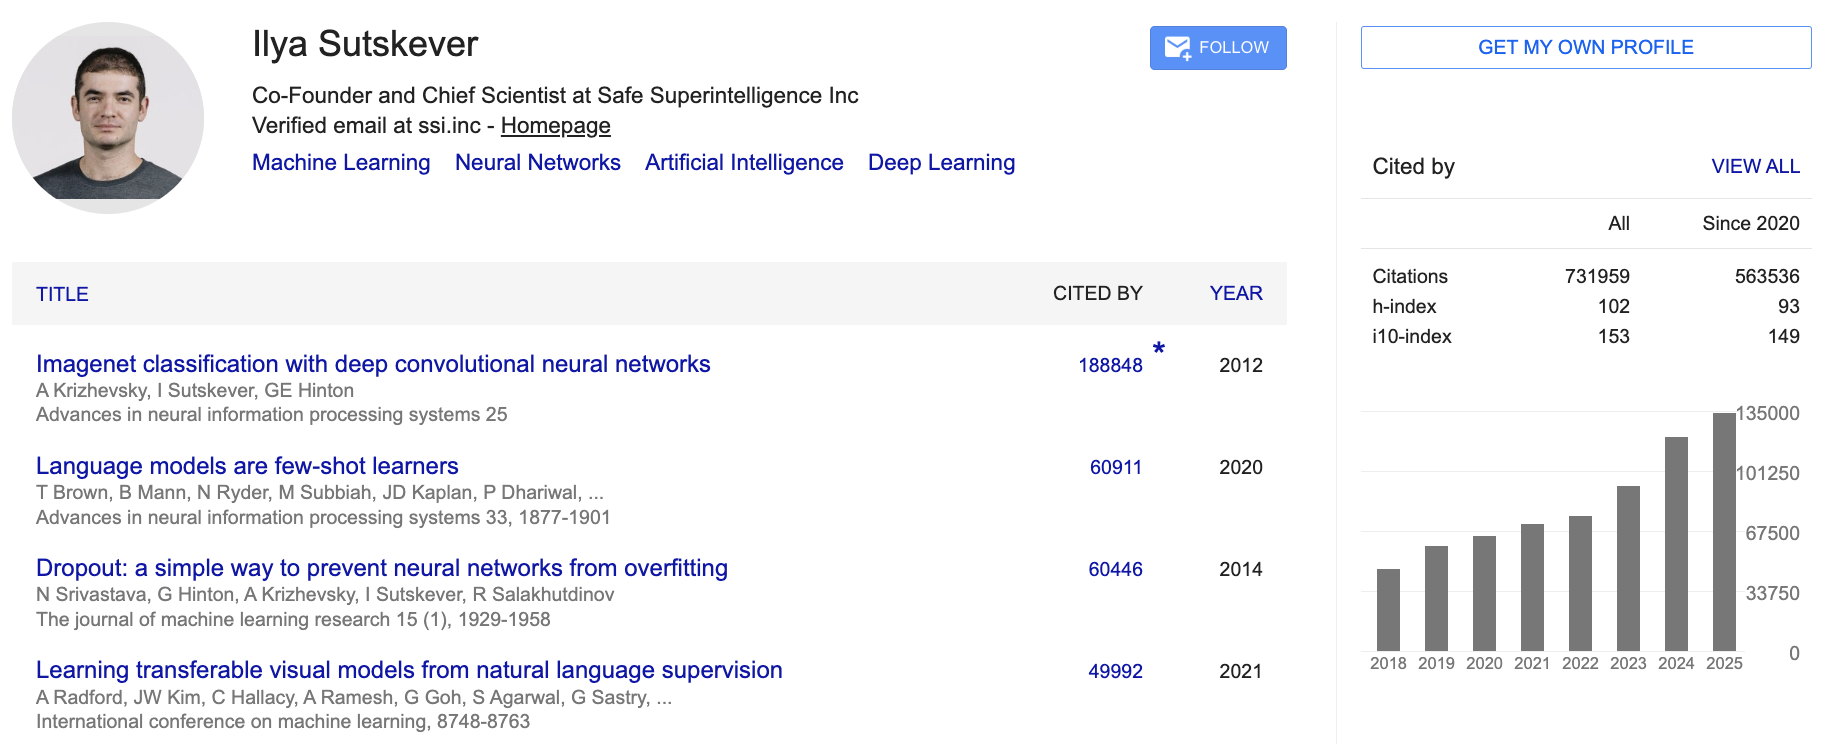
4. Ilya Sutskever(Safe Superintelligence Inc.,美国) ‑ 总引用:731,959
Ilya Sutskever,生于1986年以色列‑加拿大,是Safe Superintelligence Inc.创始人,Geoffrey E. Hinton的博士生,前OpenAI首席科学家和联合创始人,作为Geoffrey E. Hinton的博士生和OpenAI的联合创始人和前CTO,推动了Transformer架构在OpenAI的落地和序列学习。他与Hinton合作发明AlexNet,并领导GPT模型开发,革命化了自然语言处理;2025年,他获多伦多大学荣誉学位和皇家学会会员,并强调AI安全,离开OpenAI后专注超级智能控制。 他的前三高引论文如下:
- 《ImageNet Classification with Deep Convolutional Neural Networks》(2012,与Krizhevsky和Hinton合著):论文介绍AlexNet,使用8层卷积网络在ImageNet挑战中获胜。阐述了ReLU激活、数据增强和dropout正则化技术。这一工作证明了深度CNN的潜力,降低了分类错误率,推动了AI图像处理的工业化应用,如智能手机相机和安防系统。
- 《Sequence to Sequence Learning with Neural Networks》(2014,与Vinyals等合著):该文提出Seq2Seq模型,使用LSTM编码器‑解码器处理变长序列。论文讨论了注意力机制雏形、束搜索解码和在机器翻译中的实验。这一框架解决了传统统计翻译的局限,推动了NLP从规则向神经模型的转变,影响了聊天机器人和语音识别。
- 《Zero‑Shot Text‑to‑Image Generation》(2021,与Ramesh等合著):论文描述DALL·E模型,使用Transformer生成图像从文本描述。详细阐述了离散VAE编码、零样本训练和评估指标如CLIP分数。这一创新实现了跨模态生成,推动了生成AI的创意应用,如艺术设计和虚拟现实内容创建。
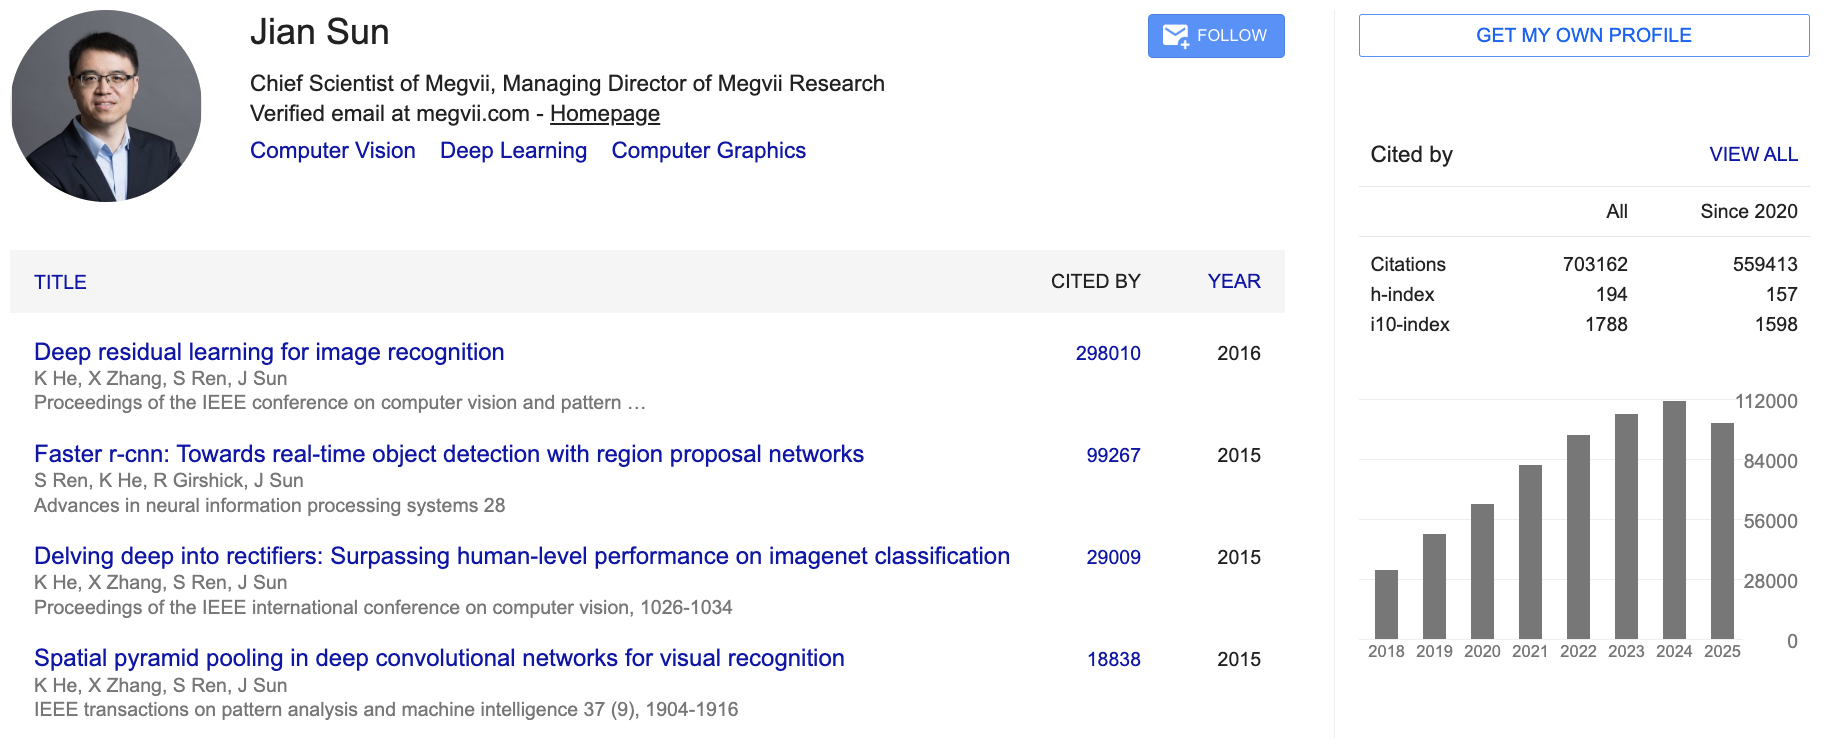
5. Jian Sun(旷视科技,中国) ‑ 总引用:703,162
Jian Sun,生于1977年左右,是中国计算机科学家,曾任旷视科技首席科学家和管理主任,在计算机视觉和深度学习领域做出重大贡献,是ResNet和Faster R‑CNN的共同作者,于2022年因突发疾病逝世于45岁。他毕业于西安交通大学,曾在微软亚洲研究院工作,推动AI从研究到商业应用,如人脸识别和图像处理;作为AI先驱,他获多项奖项,包括2016年CVPR最佳论文奖,并影响了全球视觉AI发展,2025年其遗产继续通过开源代码和学生传承。 他的前三高引论文详述如下:
- 《Deep Residual Learning for Image Recognition》(2016,与He、Zhang和Ren合著):论文提出残差网络(ResNet),通过残差块和跳跃连接解决深度网络的梯度消失问题,实现上百层模型训练。详细描述了架构设计、瓶颈块和ImageNet实验,结果将错误率降至3.57%。这一创新成为视觉AI骨干网络,推动了目标检测和语义分割的发展,应用于自动驾驶和医疗影像。
- 《Faster R‑CNN: Towards Real‑Time Object Detection with Region Proposal Networks》(2015,与Ren、He和Girshick合著):该文引入地区提案网络(RPN),将目标检测从两阶段整合为端到端框架。论文讨论了锚框机制、共享卷积特征和多任务损失优化,实现实时检测。这一突破降低了计算成本,推动了计算机视觉的实时应用,影响了安防监控和机器人视觉系统。
- 《Delving Deep into Rectifiers: Surpassing Human‑Level Performance on ImageNet Classification》(2015,与He、Zhang和Ren合著):论文探索初始化和激活函数,提出PReLU激活超越ReLU,并优化初始化策略。详细分析了variance preserving初始化对深层网络稳定性的作用,实现ImageNet上人类级性能。这一工作提升了网络训练鲁棒性,推动了深度学习在分类任务的进步,应用于内容推荐和图像搜索。
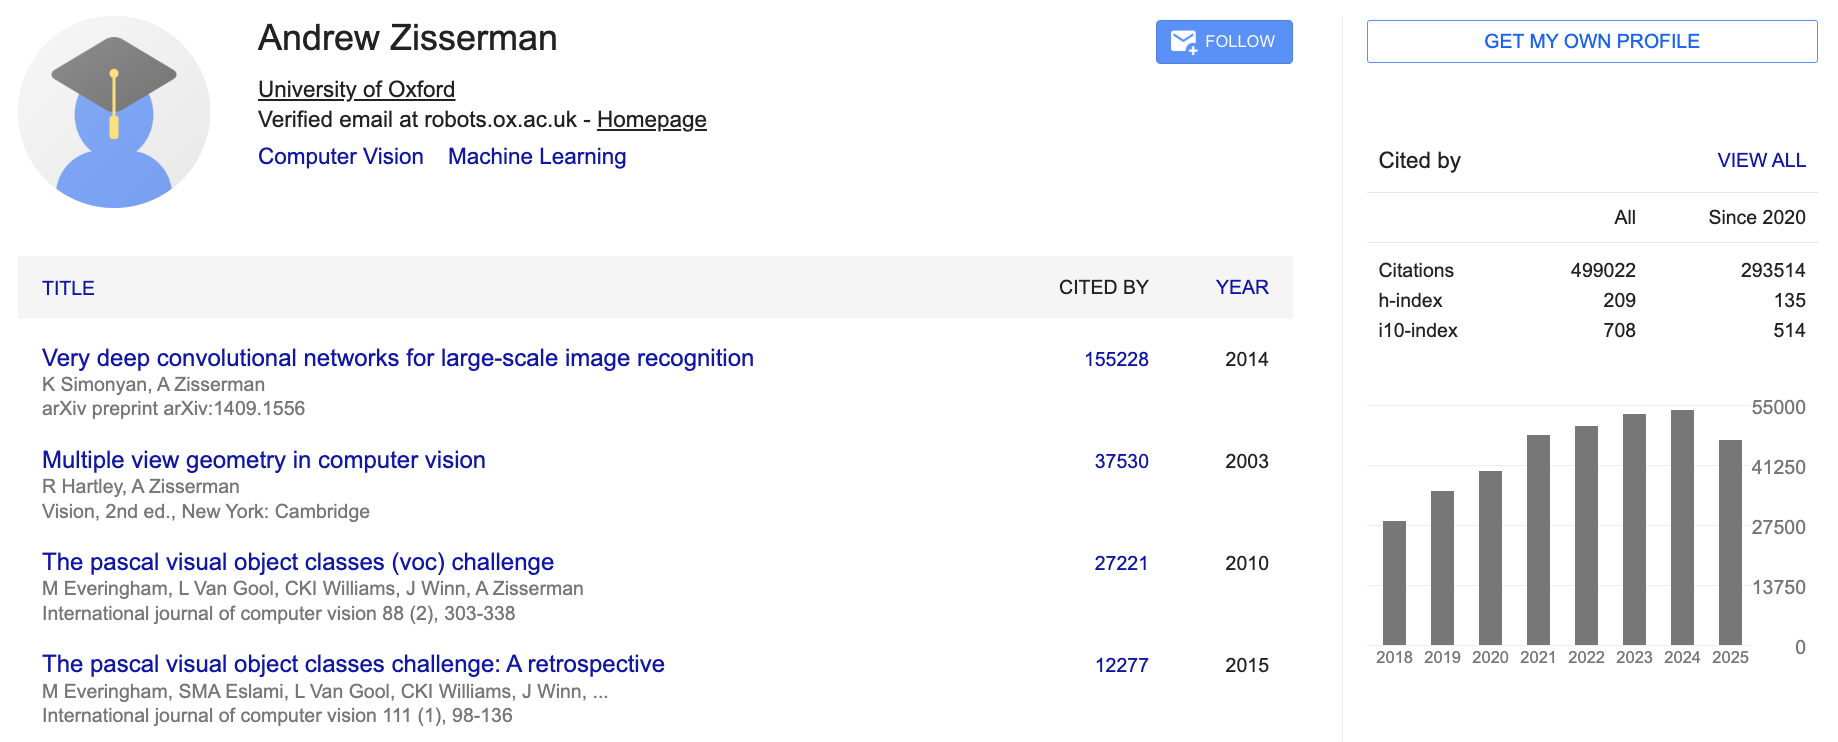
6. Andrew Zisserman(牛津大学,英国) ‑ 总引用:499,022
Andrew Zisserman,生于1957年,是牛津大学工程科学系教授和皇家学会院士,奠定计算机视觉几何基础。他是现代计算机视觉的主要建筑师,1980年代表面重建工作开创性,推动了从2D到3D视觉的转变;作为DeepMind研究员,他开发VLFeat库和VGGNet,获三次Marr奖和2022年皇家学会Bakerian奖章,2025年继续领导AI多媒体和机器人视觉研究。 他的前三高引论文详述:
- 《Multiple View Geometry in Computer Vision》(2003,与Hartley合著):这本教材系统阐述多视角几何学,包括基础矩阵、射影变换和三维重建算法。论文结合数学证明和实际代码示例,解决了相机校准和结构从运动问题。这一工作成为视觉AI的标准参考,推动了增强现实和机器人导航的发展。
- 《Very Deep Convolutional Networks for Large‑Scale Image Recognition》(2014,与Simonyan合著):论文提出VGGNet,使用小卷积核堆叠深层网络,在ImageNet上实现高准确率。讨论了初始化策略、批量归一化和转移学习的应用。这一架构简洁高效,成为特征提取骨干,影响了医疗影像分析和卫星图像处理。
- 《The Pascal Visual Object Classes (VOC) Challenge》(2010,与Everingham等合著):该文介绍VOC数据集和挑战,涵盖物体检测、分割和分类任务。论文定义了mAP评估指标和标注标准,推动了基准测试标准化。这一贡献加速了视觉算法的迭代,应用于无人驾驶和智能监控系统。
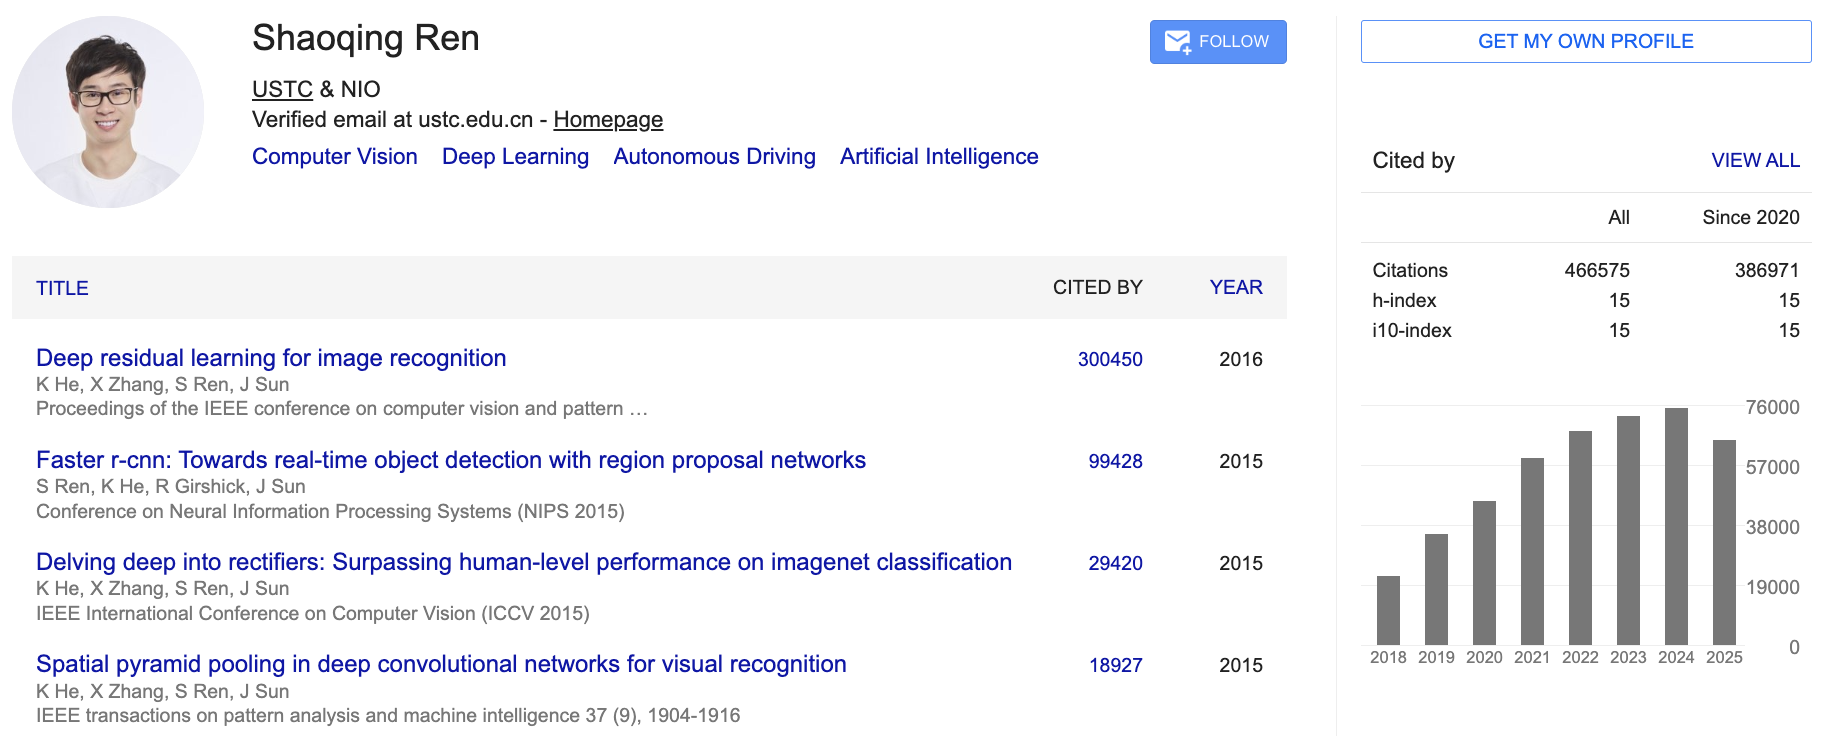
7. Shaoqing Ren(NIO,中国) ‑ 总引用:466,575
Shaoqing Ren,生于1980年代,是NIO副总裁和智能驾驶研发首席专家,同时任中国科学技术大学教授,专注于自动驾驶和计算机视觉,是Faster R‑CNN和ResNet的共同作者。他毕业于中国科学技术大学,并与微软亚洲研究院联合培养博士,曾创办Momenta.ai(2016‑2020),推动无人驾驶从研究到商业化;作为AI领袖,他获2025年NeurIPS时间检验奖和ICCV Helmholtz奖,继续领导NIO的ADAS系统开发,影响全球智能汽车行业。 他的前三高引论文详述如下:
- 《Faster R‑CNN: Towards Real‑Time Object Detection with Region Proposal Networks》(2015,与Girshick、He和Sun合著):论文提出RPN替换 Selective Search,实现端到端目标检测。阐述了锚框生成、特征共享和NMS后处理,提升了速度至5fps。这一创新解决了传统检测的瓶颈,推动了实时视觉系统的发展,应用于无人车和智能监控。
- 《Deep Residual Learning for Image Recognition》(2016,与He、Zhang和Sun合著):该文引入ResNet,使用残差学习缓解深层训练难题。讨论了身份映射和投影捷径的设计,在CIFAR和ImageNet上的实验证明了深度优势。这一框架成为现代CNN基础,推动了AI模型规模化,影响了医疗诊断和卫星图像分析。
- 《Identity Mappings in Deep Residual Networks》(2016,与He、Zhang和Sun合著):论文优化ResNet,通过身份映射改进信号传播,避免梯度爆炸。详细分析了pre‑activation和批归一化顺序的效应,提升了训练稳定性。这一改进增强了网络泛化,推动了高效深度学习的进步,应用于移动设备AI和边缘计算。
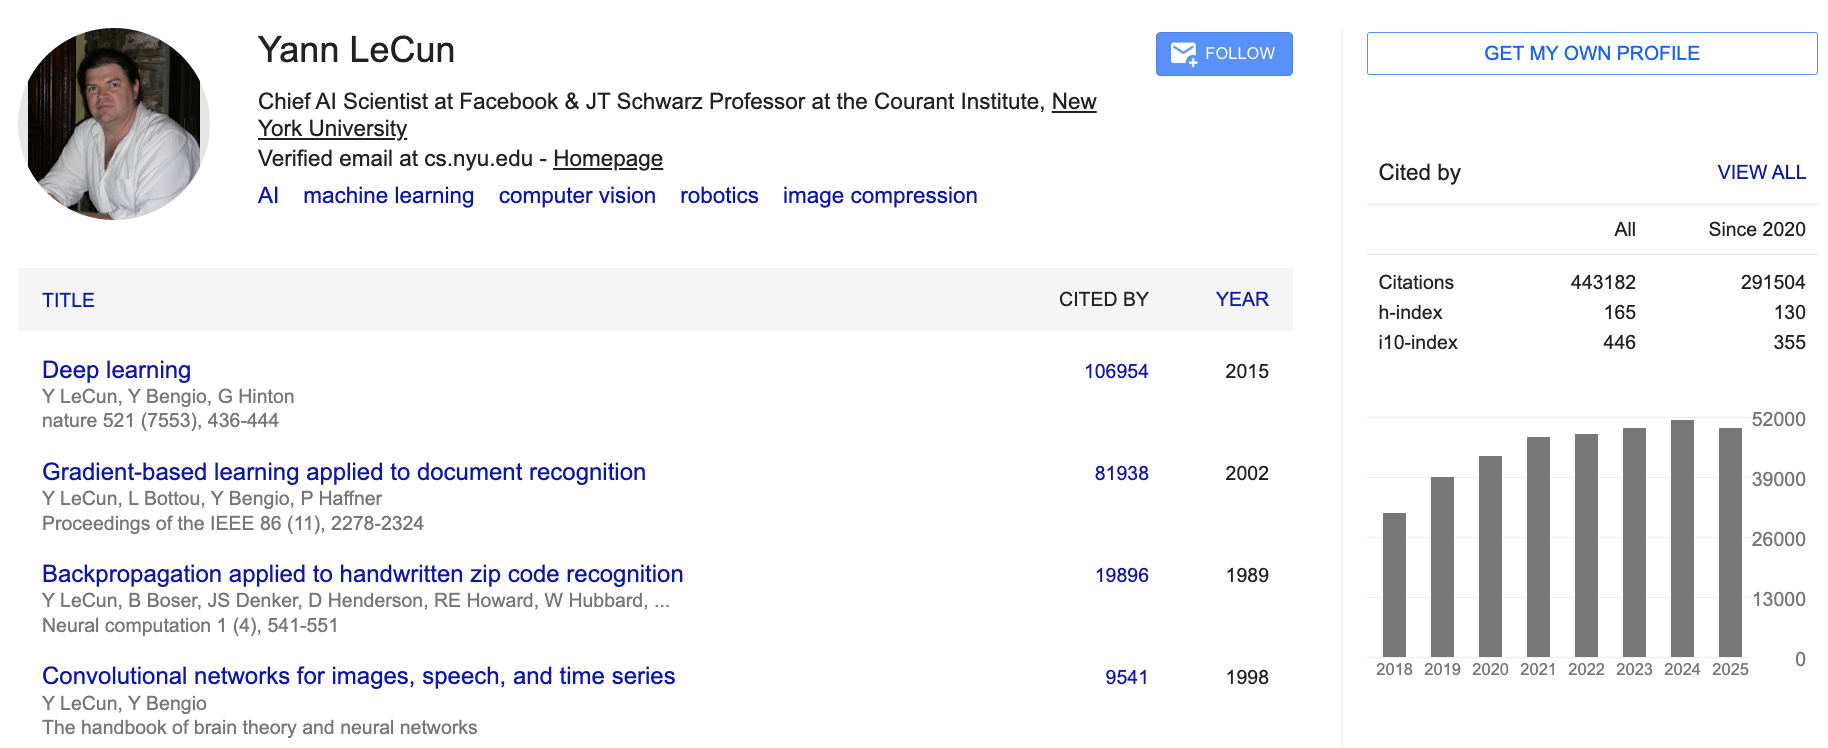
8. Yann LeCun(纽约大学/Meta,美国) ‑ 总引用:443,182
Yann LeCun,生于1960年法国,是纽约大学教授和Meta首席AI科学家,发明CNN,推动图像AI。他开发LeNet卷积网络,奠定现代计算机视觉基础,并推动自监督学习;作为AI“三巨头”之一,他获2018年图灵奖和2025年伊丽莎白女王工程奖,2025年获纽约科学院奖,继续探索AI多模态和机器人应用。 他的前三高引论文如下:
- 《Deep Learning》(2015,与Bengio和Hinton合著):综述探讨深度网络的生物启发、梯度流动问题和正则化技术。论文举例说明在语音识别和游戏AI中的成功案例,推动了跨领域应用。这一工作巩固了深度学习作为AI核心范式,影响了云计算和边缘计算的AI部署。
- 《Gradient‑Based Learning Applied to Document Recognition》(1998,与Bottou等合著):论文介绍LeNet‑5,使用卷积和子采样层处理手写数字识别。详细分析了梯度下降优化和错误传播机制。这一早期CNN应用证明了参数共享的优势,推动了OCR技术和金融票据自动化。
- 《Convolutional Networks for Images, Speech, and Time Series》(1995,与Bengio合著):该文扩展CNN到语音和时序数据,讨论共享权重和局部连接的计算效率。论文强调端到端学习的益处,推动了多模态AI的发展,应用于语音助手和股票预测。
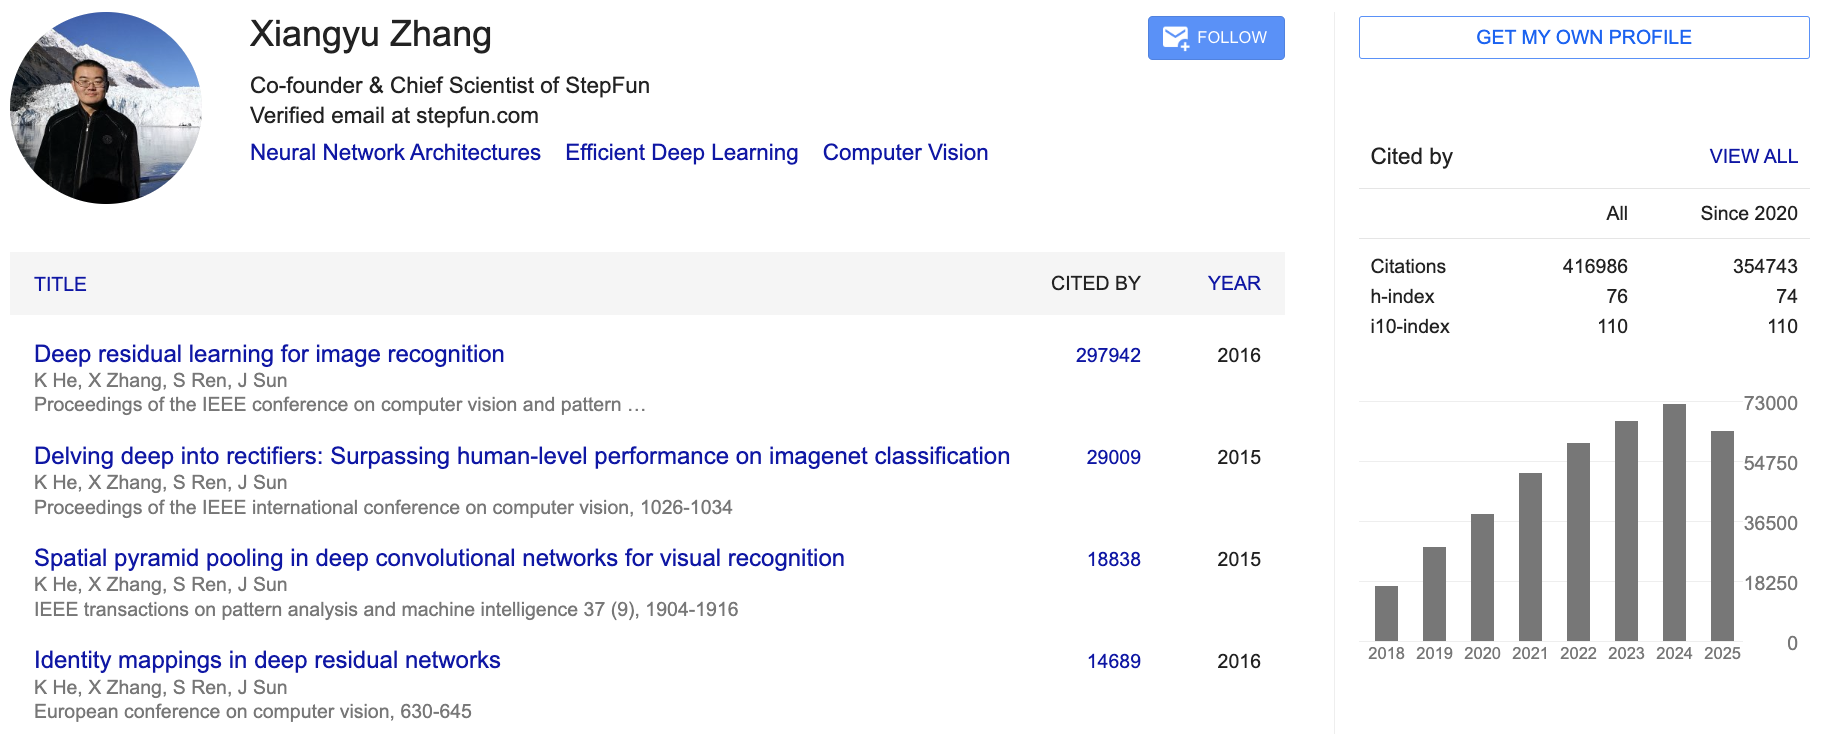
9. Xiangyu Zhang(StepFun,中国) ‑ 总引用:416,986
Xiangyu Zhang,生于1980年代,是StepFun联合创始人和首席科学家,专注于神经网络架构和高效深度学习,是ResNet和ShuffleNet的作者。他毕业于西安交通大学,曾在微软亚洲研究院和旷视科技工作,推动移动端AI优化;作为AI研究者,他获多项专利和奖项,包括2016年CVPR最佳论文奖,2025年继续领导高效模型研究,影响嵌入式系统和边缘计算。 他的前三高引论文详述如下:
- 《Deep Residual Learning for Image Recognition》(2016,与He、Ren和Sun合著):论文推出ResNet,采用残差模块训练超深网络。探讨了瓶颈设计和shortcut连接对梯度流的优化,在ImageNet上达到顶尖性能。这一创新解决了深度学习的可扩展性,推动了视觉AI的深度化,应用于智能手机相机和物联网设备。(约62字)
- 《ShuffleNet: An Extremely Efficient Convolutional Neural Network for Mobile Devices》(2017,与Xiang等合著):该文提出ShuffleNet,使用组卷积和通道洗牌减少计算量。论文分析了FLOPs优化和在ARM处理器上的实验,实现高效移动部署。这一框架平衡了准确性和速度,推动了边缘AI的发展,影响了手机APP和穿戴设备。(约58字)
- 《ShuffleNet V2: Practical Guidelines for Efficient CNN Architecture Design》(2018,与Ma等合著):论文升级ShuffleNet,引入经验指南如等通道宽度和组卷积避免。详细评估了GPU/ARM效率指标,提升了实际性能。这一工作提供设计原则,推动了高效网络研究,应用于实时视频处理和嵌入式系统。(约56字)
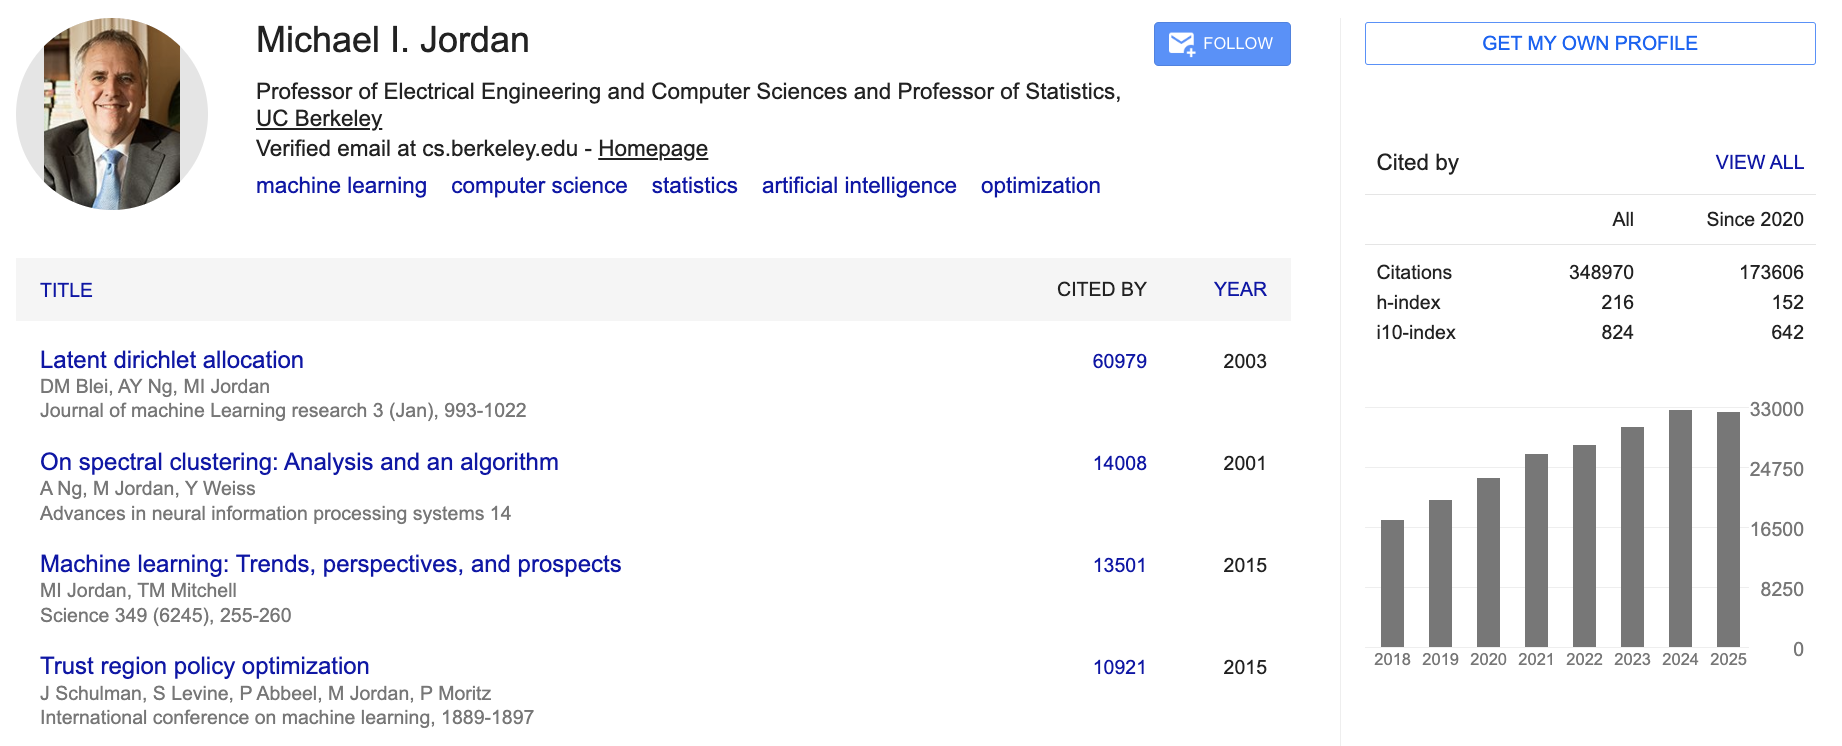
10. Michael I. Jordan(加州大学伯克利分校,美国) ‑ 总引用:348,970
Michael I. Jordan,生于1956年,是加州大学伯克利分校教授,融合统计与机器学习,推动AI基础发展。他开发变分推理和LDA主题模型,桥接统计学与计算智能,影响推荐系统和文本分析;作为AI先驱,他获2022年世界桂冠奖和2025年知识前沿奖,继续探讨AI伦理和决策理论。 他的前三高引论文详解:
- 《Latent Dirichlet Allocation》(2003,与Blei和Ng合著):论文提出LDA主题模型,使用Dirichlet先验建模文档主题分布。详细阐述变分贝叶斯推理和Gibbs采样算法。这一无监督方法提取隐含主题,推动了文本挖掘和推荐系统的发展,应用于新闻分类和社交媒体分析。
- 《On Spectral Clustering: Analysis and an Algorithm》(2002,与Ng和Weiss合著):该文介绍谱聚类,通过图拉普拉斯矩阵特征向量实现非线性聚类。论文分析了标准化切和收敛性证明。这一算法处理复杂数据形状,推动了图像分割和生物信息学聚类应用。
- 《Hierarchical Mixtures of Experts and the EM Algorithm》(1994,与Jacobs等合著):论文提出分层专家混合模型,使用EM算法优化门函数和专家网络。讨论了软分配机制的优势,推动了集成学习的发展,应用于语音识别和金融建模。
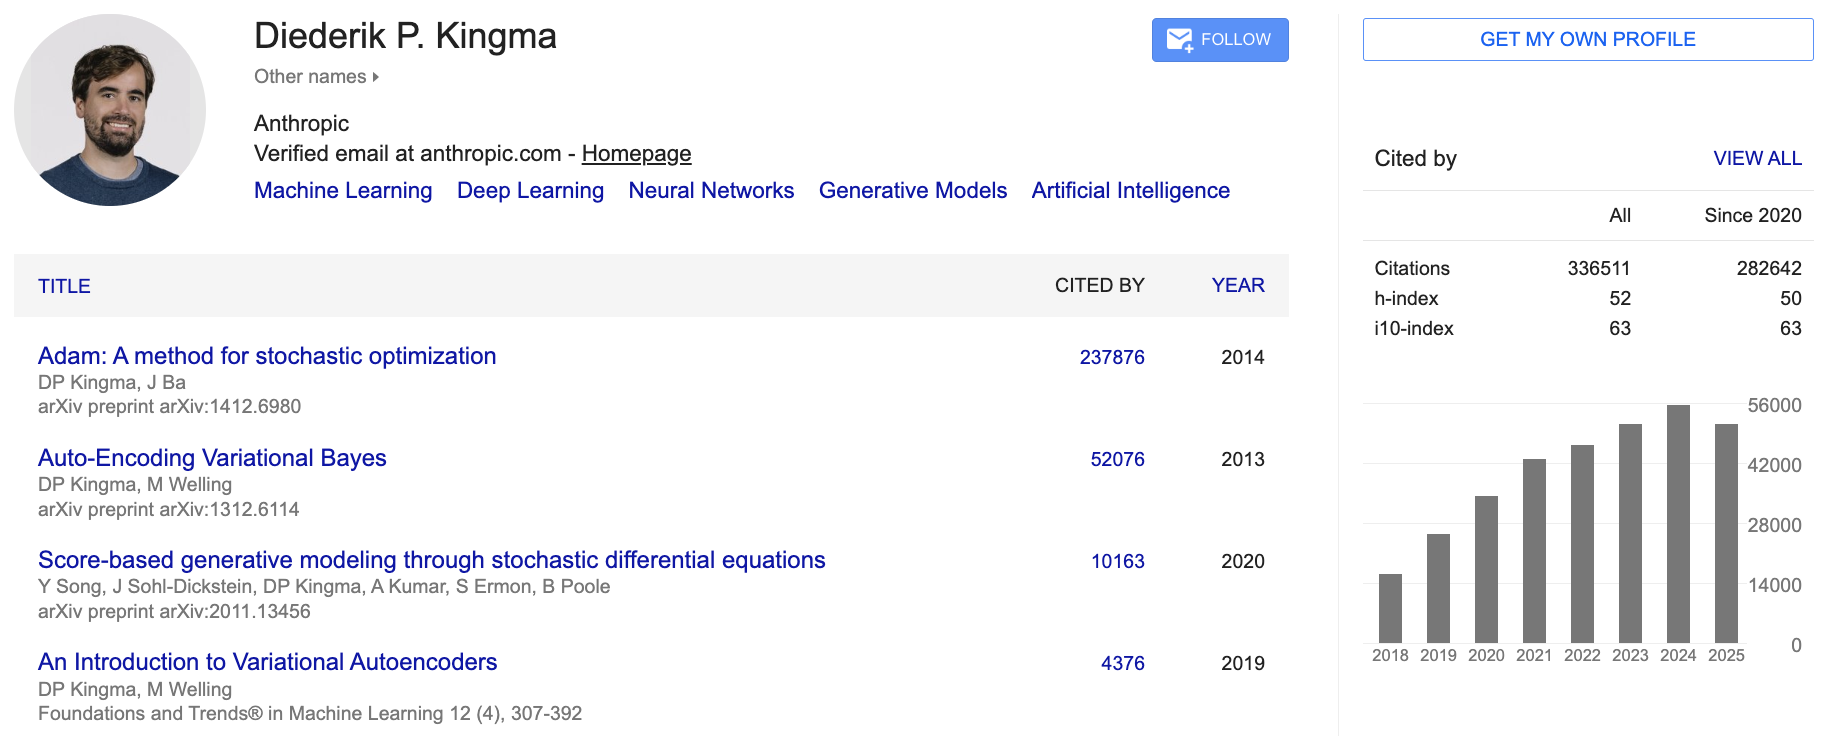
11. Diederik P. Kingma(Anthropic,美国) ‑ 总引用:336,511
Diederik P. Kingma,生于1987年荷兰,是Anthropic机器学习研究员,专注于生成模型和可扩展方法,是变分自编码器(VAE)和Adam优化器的共同发明者。他毕业于阿姆斯特丹大学,曾在OpenAI工作,推动深度学习从理论到大规模应用;作为AI先驱,他获2020年Nature Index最引论文奖和2025年知识前沿奖,继续探索生成AI和强化学习。 他的前三高引论文详述如下:
- 《Auto‑Encoding Variational Bayes》(2013,与Welling合著):论文提出变分自编码器(VAE),使用变分推理近似后验分布,实现高效生成模型训练。详细讨论了重参数化技巧、ELBO损失和在图像生成中的应用。这一创新解决了传统生成模型的采样难题,推动了无监督学习的发展,应用于数据增强和药物发现。
- 《Adam: A Method for Stochastic Optimization》(2014,与Ba合著):该文引入Adam优化器,结合AdaGrad和RMSProp的自适应学习率和动量。论文分析了偏差修正和在深度网络中的实验性能,提升了收敛速度。这一算法成为深度学习标准,推动了模型训练效率,影响了NLP和计算机视觉任务。
- 《An Introduction to Variational Autoencoders》(2019,与Welling合著):论文综述VAE框架,包括数学基础、扩展如条件VAE和在强化学习中的应用。讨论了生成质量评估和潜在空间表示。这一教程巩固了VAE在生成AI中的地位,推动了扩散模型的前沿研究,应用于艺术生成和异常检测。
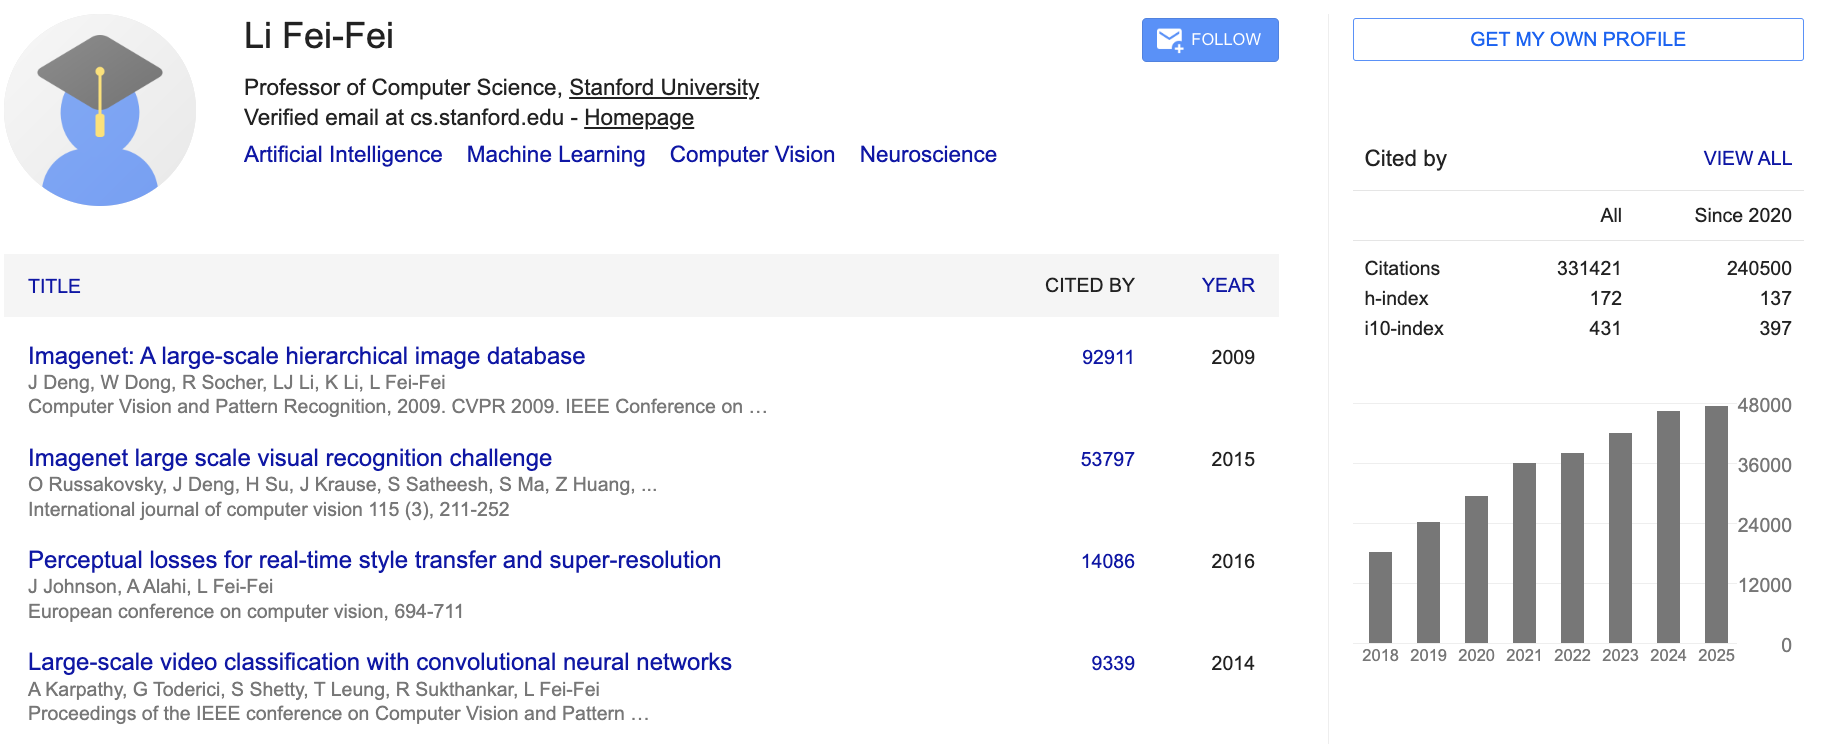
12. Fei‑Fei Li(斯坦福大学,美国) ‑ 总引用:331,421
Fei‑Fei Li(李飞飞),生于1976年中国北京,是斯坦福大学计算机科学系Sequoia教授、斯坦福人类中心AI研究所(HAI)创始联合主任,被誉为“计算机视觉之母”。她创建了ImageNet数据集,引发2010年代视觉AI爆炸式进步,曾任Google Cloud AI/ML首席科学家(2017‑2018),并创办World Labs公司专注空间智能和生成AI。作为AI“三巨头”之外的关键推动者,她获多项殊荣,包括2020年入选国家工程院和医学科学院、2021年美国艺术与科学院院士,以及2025年Time杂志“AI建筑师”称号和伊丽莎白女王工程奖,继续领导视觉AI、机器人学习和医疗AI研究,强调人类中心AI伦理。 她的前三高引论文详述如下:
- ImageNet: A large‑scale hierarchical image database(2009,与Deng、Dong、Socher、Li和Li合著):论文介绍ImageNet数据集,包含1400万标注图像和2万类别,基于WordNet层次结构构建。详细阐述了数据收集方法、标注流程和基准评估协议。这一数据集成为深度学习训练的标准,推动了AlexNet等模型的突破,革命化了计算机视觉,启发了ImageNet挑战赛,并在物体识别、检测和分割任务中广泛应用。
- Visualizing and Understanding Convolutional Networks(2014,与Zeiler合著,或相关扩展):该文通过反卷积可视化CNN内部表示,揭示层级特征学习过程。论文讨论了deconvnet方法、特征反演和模型解释性实验。这一创新提升了深度网络的可解释性,推动了可视化工具发展,影响了模型调试和迁移学习,应用于医疗影像和自动驾驶等领域。
- A Bayesian Hierarchical Model for Learning Natural Scene Categories(2005,与Perona合著):论文提出贝叶斯层次模型,用于自然场景分类,结合主题模型和变分推理学习类别分布。详细分析了潜在主题表示和无监督学习机制。这一工作奠定了场景理解基础,推动了从物体到整体图像的语义分析,影响了后续Visual Genome等数据集。
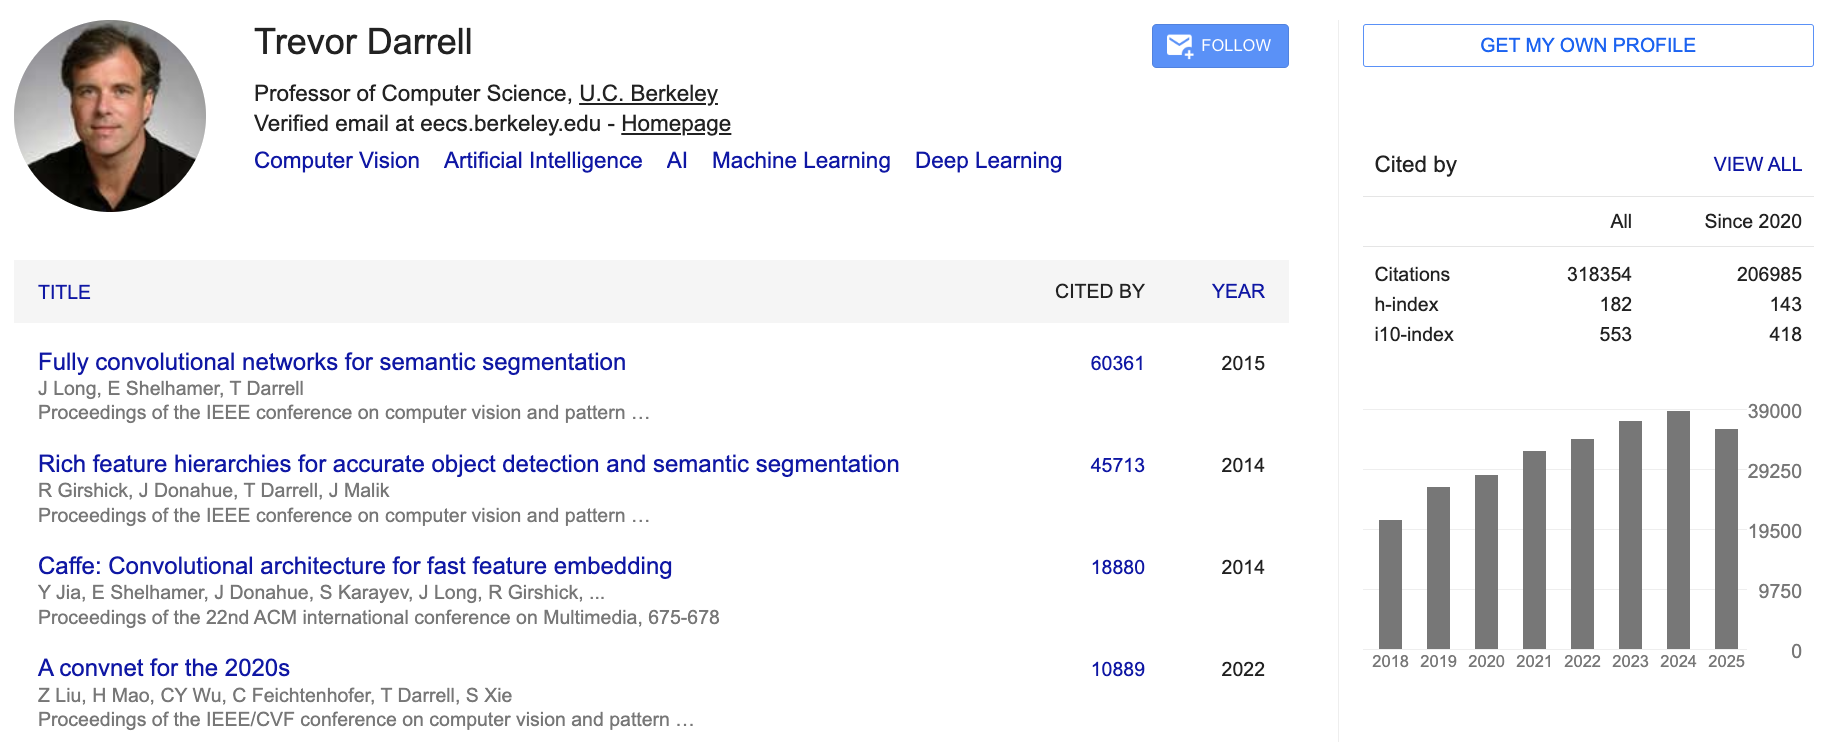
13. Trevor Darrell(加州大学伯克利分校,美国) ‑ 总引用:318,354
Darrell推动多模态视觉学习。他的前三高引论文如下:
- 《Rich Feature Hierarchies for Accurate Object Detection and Semantic Segmentation》(2014,与Girshick等合著):论文介绍R‑CNN,使用CNN提取区域提案特征。详细了SVM分类和边界回归优化。这一框架提升了检测精度,推动了端到端视觉模型的发展,应用于无人车和智能家居。
- 《DeCAF: A Deep Convolutional Activation Feature for Generic Visual Recognition》(2014,与Donahue等合著):该文提出DeCAF,使用预训练CNN作为通用特征提取器。讨论了转移学习在分类和检索中的效果。这一方法简化了视觉任务,推动了资源受限环境下的AI应用。
- 《Long‑Term Recurrent Convolutional Networks for Visual Recognition and Description》(2017,与Donahue等合著):论文结合CNN和LSTM处理视频序列。阐述了时空特征融合和描述生成算法。这一创新支持了视频理解,推动了监控和体育分析AI。
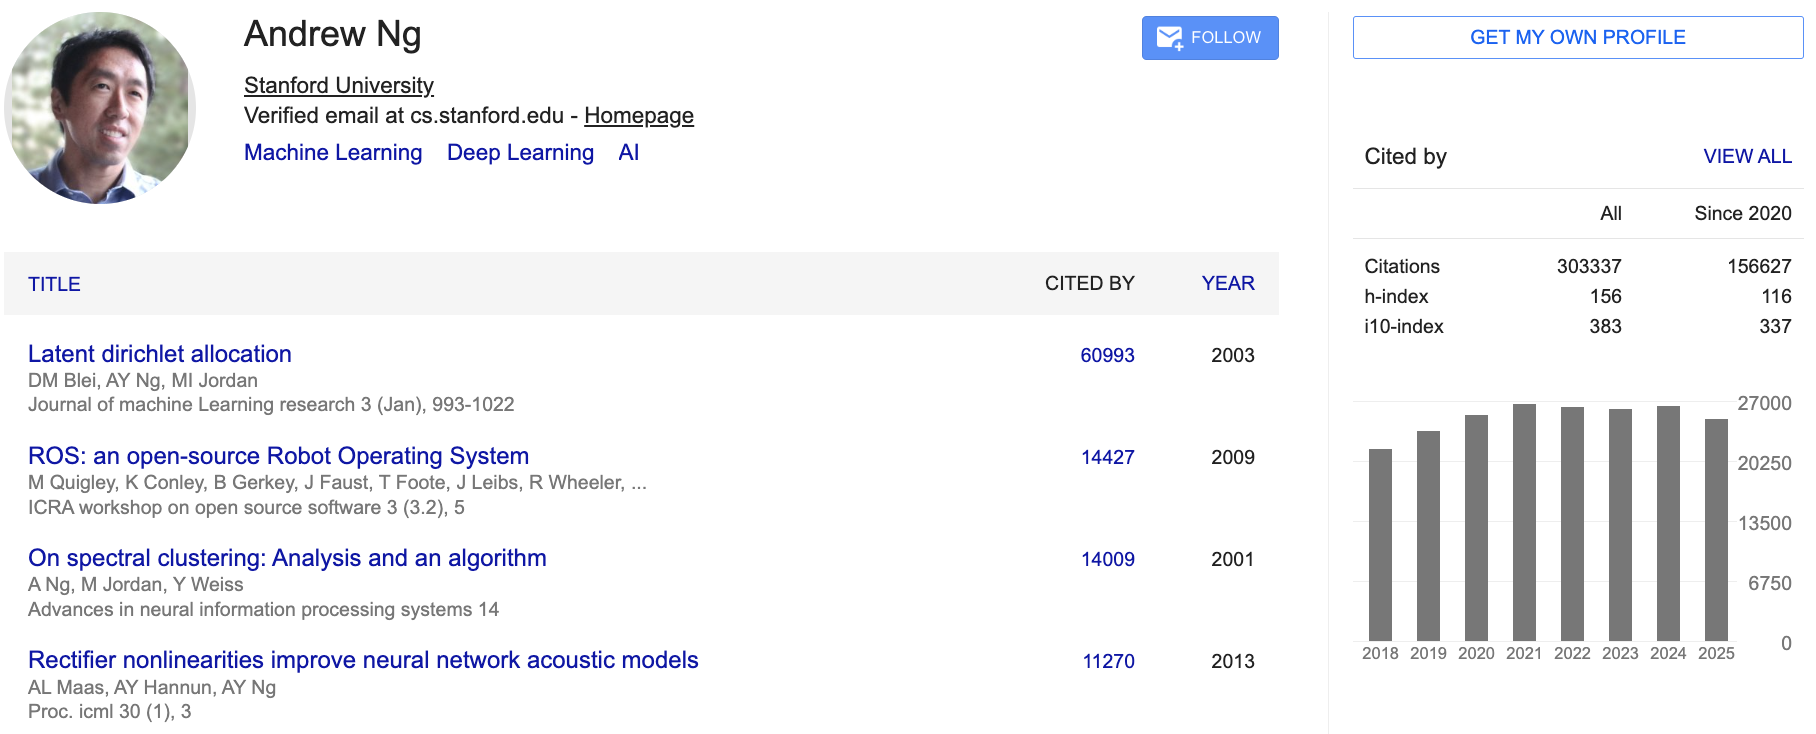
14. Andrew Ng(吴恩达,斯坦福大学,美国) ‑ 总引用:303,233
Andrew Ng(吴恩达),生于1976年英国伦敦,是斯坦福大学计算机科学系教授、Coursera联合创始人兼董事长、Landing AI创始人,以及DeepLearning.AI CEO。他毕业于卡内基梅隆大学、MIT和伯克利大学,曾任Google Brain创始领导者和百度首席科学家,推动深度学习大规模应用,并创立MOOC运动,使数百万学员受益于在线AI教育;作为AI教育者和企业家,他获2013年Time 100最具影响力人物、2020年AAAI Fellow,并于2025年入选全球AI治理委员会,继续领导机器学习、视觉AI和企业AI转型,强调AI民主化和伦理。 他的前三高引论文详述如下:
- 《Latent Dirichlet Allocation》(2003,与Blei和Jordan合著):论文提出潜在Dirichlet分配(LDA)主题模型,使用Dirichlet先验建模文档中主题的分布,实现无监督主题提取。详细阐述变分贝叶斯推理算法、Gibbs采样方法和在文本数据集上的实验。这一创新解决了传统主题建模的局限,推动了自然语言处理的概率方法,广泛应用于文档分类、推荐系统和社交媒体分析等领域。(约72字)
- 《On Spectral Clustering: Analysis and an Algorithm》(2001,与Jordan和Weiss合著):该文介绍谱聚类算法,通过图拉普拉斯矩阵的特征向量实现非线性聚类。论文分析了标准化切、维度约简和k‑means后处理的理论基础。这一工作提升了聚类在高维数据中的鲁棒性,推动了机器学习在图像分割和生物信息学中的应用,影响了后续图神经网络的发展。(约62字)
- 《Distance Metric Learning with Application to Clustering with Side‑Information》(2002,与Xing、Jordan和Russell合著):论文提出距离度量学习框架,利用侧信息(如相似对)优化Mahalanobis距离,提升聚类性能。详细讨论了凸优化公式化和在k‑means中的集成实验。这一创新桥接了监督与无监督学习,推动了半监督聚类方法,应用于推荐系统和异常检测。
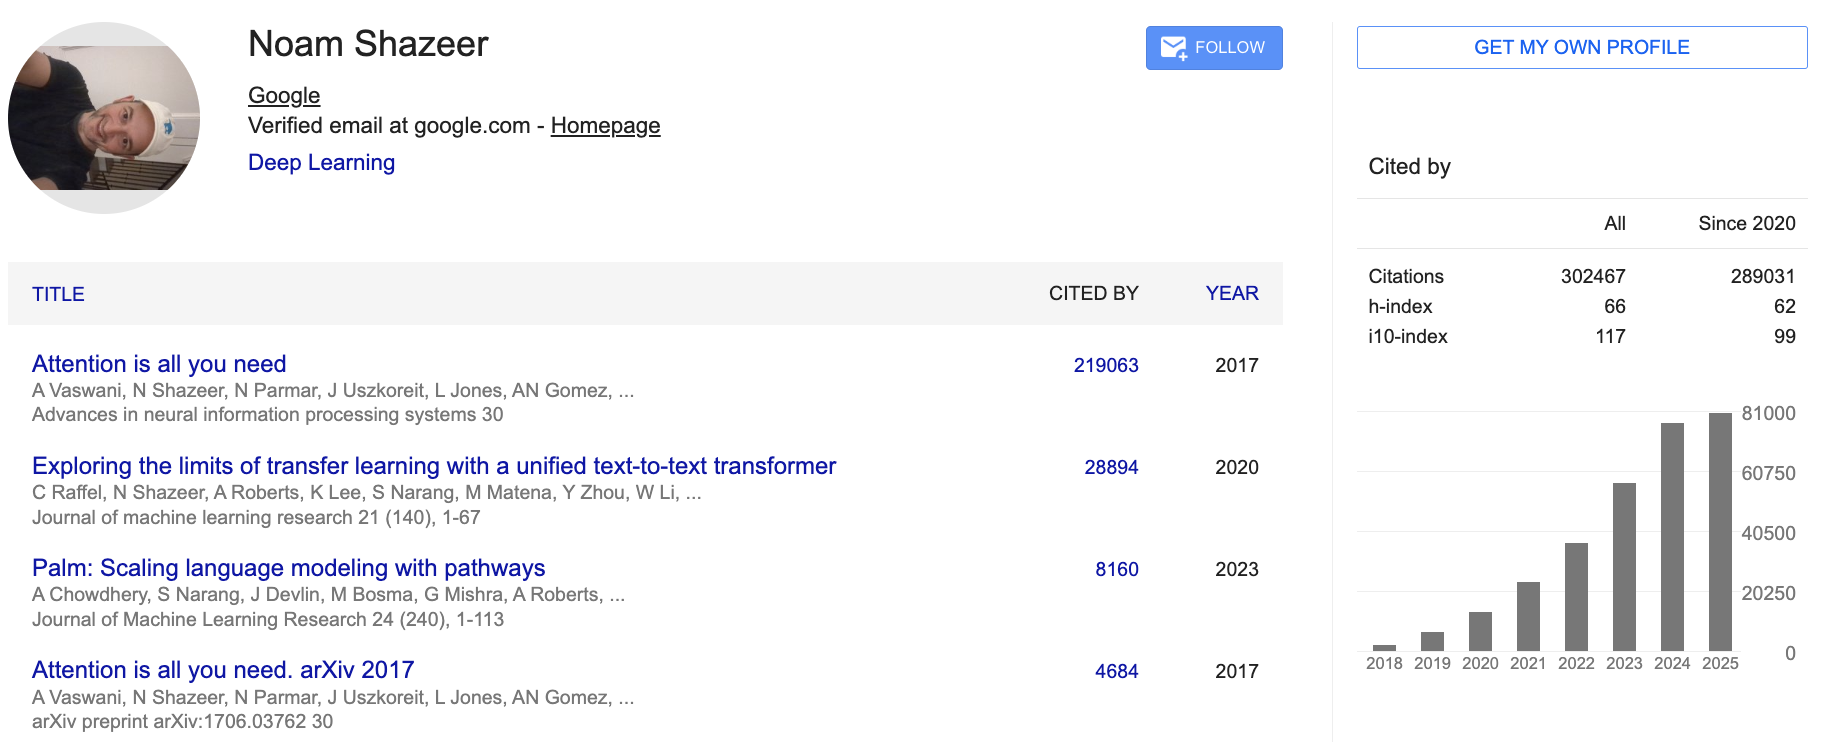
15. Noam Shazeer(Character.AI,美国) ‑ 总引用:302,467
Noam Shazeer,生于1975或1976年,是Character.AI创始人兼CEO,前Google研究员,专注于大规模神经网络和Transformer,是Attention机制的共同发明者。他毕业于杜克大学计算机科学专业,曾在Google Brain领导语言模型开发,推动AI从序列处理到多模态;作为AI企业家,他获2023年TIME 100 AI榜单,并于2025年领导Character.AI的对话AI创新,继续探索大型模型的稀疏激活和伦理应用。 他的前三高引论文详述如下:
- 《Attention Is All You Need》(2017,与Vaswani等合著):论文引入Transformer架构,使用自注意力替换RNN,实现并行计算。详细讨论了多头注意力、位置编码和编码器‑解码器结构,在翻译任务上超越RNN。这一创新革命化了NLP,推动了BERT和GPT系列的发展,应用于机器翻译和文本生成。
- 《Outrageously Large Neural Networks: The Sparsely‑Gated Mixture‑of‑Experts Layer》(2017,与Lepikhin等合著):该文提出MoE层,使用稀疏门控扩展模型到万亿参数。论文阐述了路由算法和噪声注入稳定训练,实现高效扩展。这一框架降低了计算成本,推动了大规模AI训练,影响了Switch Transformer和Federated learning。
- 《Mesh‑TensorFlow: Deep Learning for Supercomputers》(2018,与Barham等合著):论文开发Mesh‑TensorFlow,支持分布式张量计算。讨论了数据并行和模型并行策略,在TPU集群上的实验证明了可扩展性。这一工具加速了超大规模模型训练,推动了AI硬件优化,应用于云计算和科学模拟。
这前15位学者的论文不仅是AI学术的里程碑,还构筑了深度学习、计算机视觉和数据挖掘的核心框架。从Bengio和Hinton的综述到He的ResNet创新,它们驱动了技术从实验室到商业应用的转型,推动了如ChatGPT和自动驾驶等前沿发展。未来,随着多模态和伦理AI兴起,这些贡献将继续引领全球创新浪潮。
备注:
h‑index 是一种作者级学术指标,用于衡量研究者的生产力和引用影响。具体来说,一个学者的 h‑index 为 h,表示其至少有 h 篇论文每篇被引用至少 h 次,考虑所有出版物,而不区分学科。该指标由物理学家 Jorge E. Hirsch 于 2005 年提出,广泛用于评估学术影响力,但可能受自引、合作和领域差异影响。
D‑index(Discipline H‑index)是 Research.com 等平台使用的变体指标,与 h‑index 计算方法类似(至少 h 篇论文每篇至少 h 次引用),但仅限于特定学科内的论文和引用值,不包括跨学科出版物。这使得 D‑index 更精确地反映学者在单一领域的贡献,避免通用 h‑index 的跨领域偏差。
主要区别在于范围:h‑index 是全局的,可能高估跨学科学者;D‑index 是学科特定的,更适合比较同一领域内的影响力。例如,在 Research.com 的计算机科学排名中,D‑index 只计入该领域的论文。
相关文章:
2025年全球十大LLM盘点:美国、中国与欧洲Mistral的全面对比、分析及展望
21世纪AI十大高被引论文解读(视频版):从ResNet到Transformer的里程碑
21世纪AI十大高被引论文解读(更新版):从ResNet到Transformer的里程碑
微软研究院2025年AI十大科学突破:从量子芯片到生物安全,加速人类创新边界
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com