
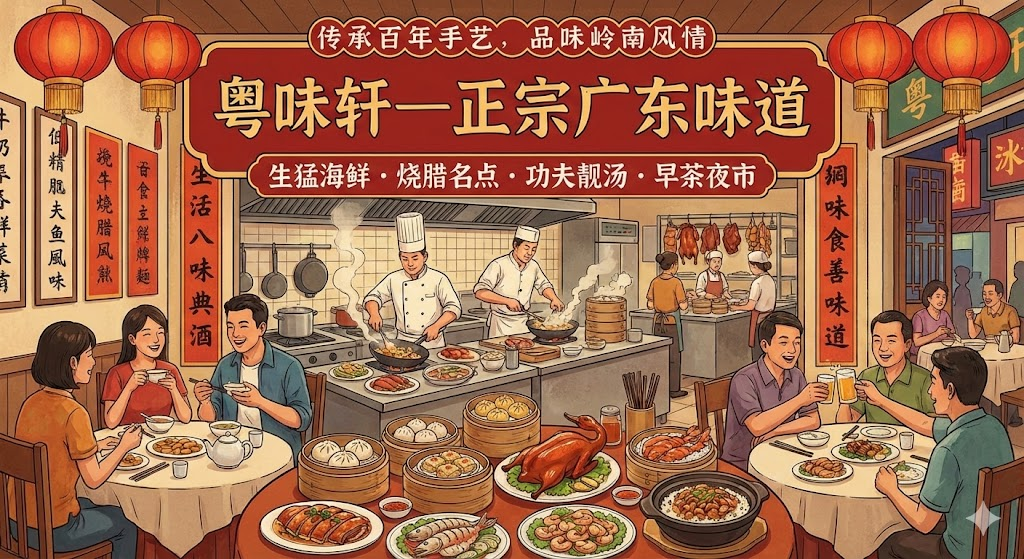
2025年11月20日 — 在Wired的上手评测中,Google名为“Nano Banana Pro”的图像生成模型最引人注意的进步不是更逼真的皮肤或复杂光影,而是它在图像内直接生成可读文本的能力,这被视为本次升级最大的亮点,特别是中文/日文等非字母型文字体系的渲染上。评测者在输入包含品牌名、街头海报或T恤口号的提示词后,输出里的字母比往常更整齐,单词形态完整性有明显提升。
文章列举了多个场景:将一句英文口号渲染到徽标、把菜单文字放到咖啡馆招牌上、以及在卡通角色旁添加说明文本。以前的模型常见字母错位、字符连成一团或生成“看起来像单词”的符号,而Nano Banana Pro在多数样例中能把“coffee”“open”这类短词写成可辨认的字形。Wired记录了多次生成结果:短词成功率高,但长段落或小字号仍会出现字母倒置、重复或奇怪的连笔。
技术层面,报道指出这款模型在架构和训练上进行了轻量化与细化优化,使其在保持视觉细节的同时对字形学习更敏感。上手中测试的分辨率和复杂场景(如多层叠放的广告牌或反光材质)表明,模型对文字的语义关系也有一定“理解”——它会优先把品牌名或提示中的关键词放在视觉焦点上,但偶尔也会把文本变形以适配透视或纹理。
速度方面,Wired在本地云端实例中观察到:生成一张中等分辨率的样图需要几秒到十几秒不等,取决于细节和是否开启多次重采样。相比更大的旗舰模型,Nano Banana Pro在响应时间上更友好,这也意味着它更可能被企业用于实时创作工具或广告制作流水线。
不过,文章同时提醒两点风险:一是更可靠的“可读文本”能力降低了伪造证据、生成虚假广告或误导性物料的门槛;二是商业化应用会推动公司把这类工具整合进设计、营销和电商流程,从而放大滥用速度。Wired提到Google在模型中加入了内容过滤和水印策略,但评测中并未看到能够完全阻止带文本的误导性图像生成。
评测者还详细记录了样图中的小瑕疵:数字在特定字体下出现镜像、标点符号位置偏移、以及跨语言文本(如英汉混排)时的错位问题。这些点提示,尽管在短词与标志生成上已取得突破,但在长文本、高保真排版和多语种一致性方面仍需改进。
结论上,Wired认为Nano Banana Pro是一次“实用主义”的进步:它把生成图像中可读文本的能力提升到足以进入商业试用的门槛,同时保持了较低的计算成本。对于设计师、内容创作者和广告公司而言,这是一个能快速试验视觉创意的工具;对于监管者和平台而言,则意味着需要更快地更新滥用检测与归责框架。
这篇上手报道把焦点放在了一个细节:当AI开始“会写字”——不仅仅是画图——它对创作流程和信息传播的影响要比我们原先想象的更直接、更容易被放大。