
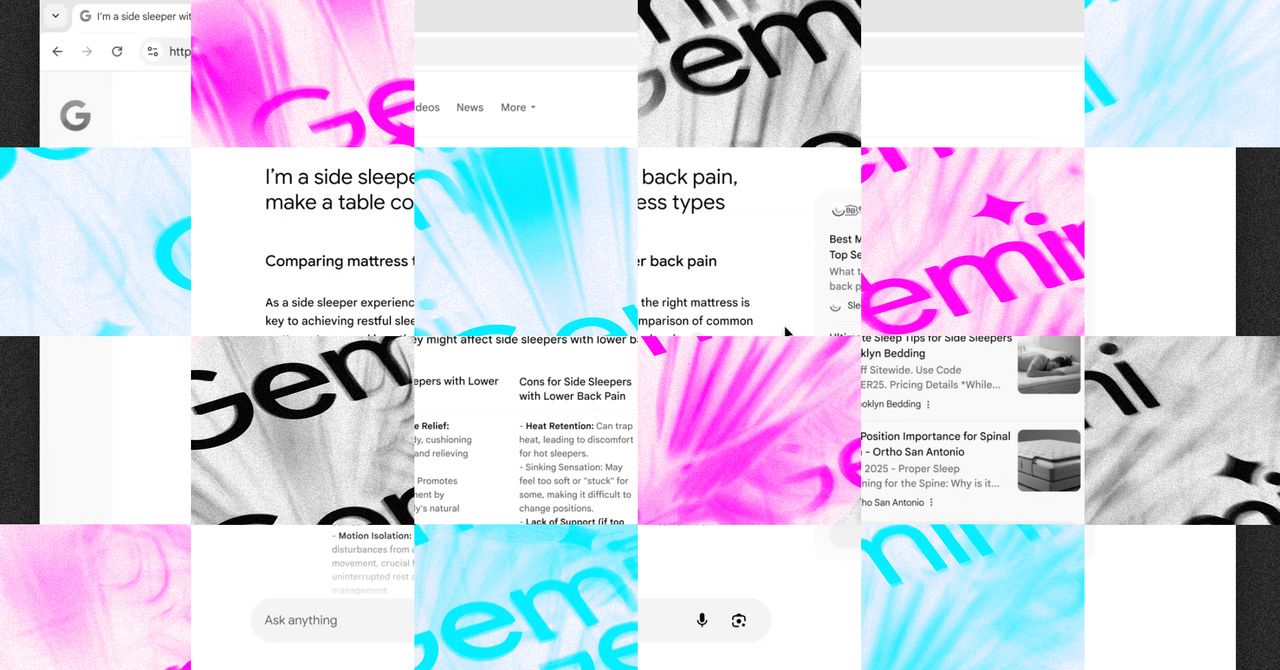
2025年9月18日,谷歌在对外公布的说明中透露,Gemini 已被更深层次地“注入”到流行的 Chrome 浏览器中。用户在浏览网页时,会在浏览器右侧或工具栏看到一个 Gemini 图标,点击即可唤起侧边栏对话界面,从网页摘要到文本改写、答疑与快速生成邮件草稿,许多交互可以在当前页面之上完成而无需切换标签。
WIRED 报道指出,Chrome 的新集成不仅是把一个聊天机器人嵌入浏览器那么简单:Gemini 会尝试理解页面上下文,自动抓取当前标签的文本与结构来生成更贴合的回答。例如,用户在阅读长篇文章或研究性页面时,可一键请求“把这篇文章压缩成三点要点”,Gemini 会基于页面段落给出精简要点并附上原文段落的定位提示,便于核对来源。
这次推送首先面向 Chrome 的稳定版部分用户与测试渠道,谷歌方面并未把全部功能一次性开放——某些高级生成与多模态能力仍需登录 Google 账户或订阅更高阶的 Gemini 版本。WIRED 强调,这样的“浏览器级”AI 是一个拐点("an inflection point for AI in our software"),因为它把模型的能力直接嵌入了用户最常用的软件环境。
与此同时,WIRED 和多位受访技术观察者提到隐私与控制权问题:当浏览器开始在用户与网页之间自动抓取上下文并将请求发往云端 AI 时,有人会寻求“off switch”——即完全关闭此功能的明确选项。谷歌已在设置中提供了若干隐私控制项,但对于什么数据会被短期缓存、用于模型改进或被保留用于个性化,细节仍是用户关心的焦点。
竞争方面,WIRED 把这步棋放在与微软将 Copilot 嵌入 Edge、以及各大浏览器和操作系统厂商加速 AI 功能开发的背景中来看。Chrome 的体量和市场占有率让 Gemini 的集成有放大效应:对于普通用户而言,AI 不再是单独的应用,而是浏览体验的一部分,这既带来效率,也带来对算法偏见、可解释性和滥用风险的新考验。
报道还列举了若干具体交互场景:在电商页面请求比价、在技术文档中快速抽出代码片段和解释、在社交媒体帖文下生成回复草稿、以及将多媒体线索交给模型进行图片与文本联动检索。WIRED 强调,这些功能能显著缩短用户完成任务的时间,但也可能使得越来越多决策依赖于封装在云端的模型。
总的来看,2025年9月18日的这次更新把 Gemini 从独立助手推向平台化服务,标志着“AI 浏览器”不再是概念而是正在落地的产品形态。对于喜欢新奇工具的年轻用户,这代表更顺手的创作与检索体验;对于注重隐私与自我控制的用户,则意味着在设置中寻找那个“off switch”将变得必要。