
几乎一夜之间,Google DeepMind 的 Genie 3 在科技圈刷屏了!!!
Google DeepMind 于 2025 年 8 月 5 日正式发布 Genie 3,这是一款能够根据单一文本提示生成可实时交互的 3D 虚拟世界的 AI 模型。用户可在 720p 分辨率与 24 FPS 的条件下,多分钟地实时探索环境,支持用户和其他 AI 代理参与交互过程。与先前仅支持 10–20 秒的 Genie 2 相比,Genie 3 显著延长互动时长,并具备强记忆能力 — 即使目标不在视线范围内,模型仍能“记住”其位置。
Genie 3 首次实现场景中对象不可见时依然持久存在,这种视觉短期记忆(memory horizon)约为 1 分钟,有些环境甚至可持续保持连贯多分钟。
视频实例演示:直观了解 Genie 3 的能力
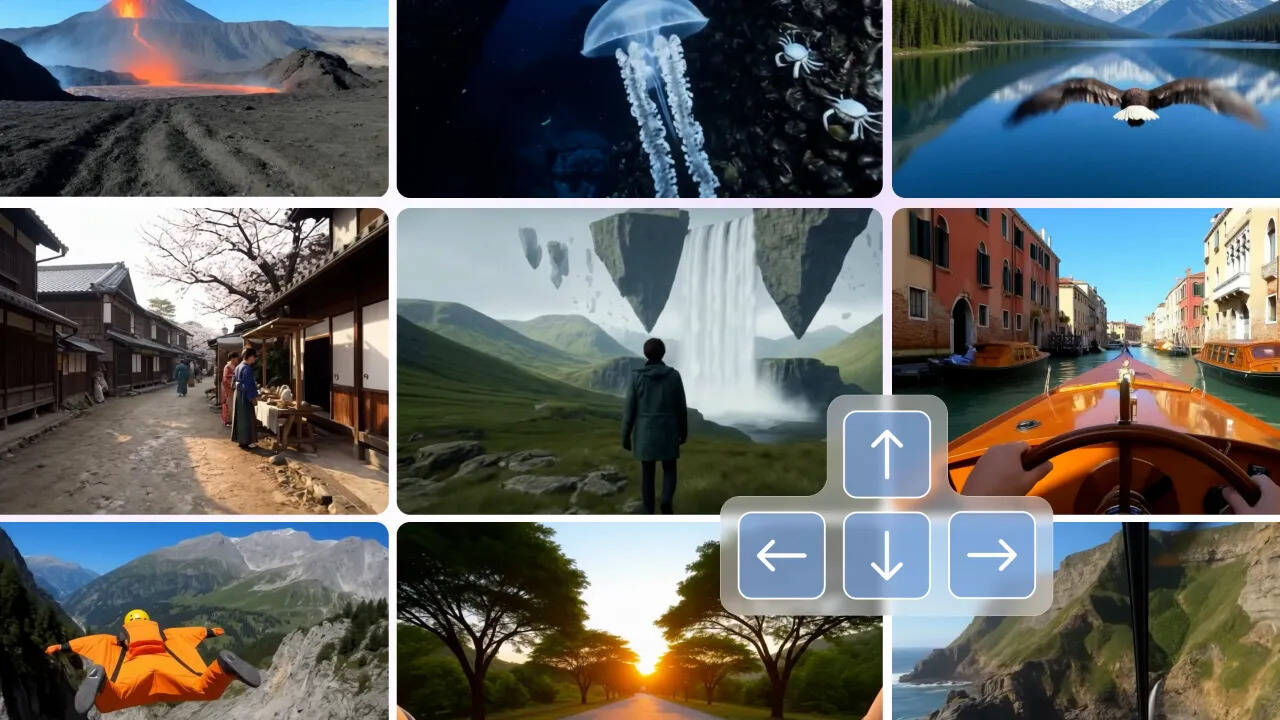
DeepMind 官方发布的视频演示展示 Genie 3 的交互机制:
- 在文字提示下,生成者能够即时创建可探索的虚拟世界;
- 用户可用键盘鼠标移动,推动角色探索环境;
- 环境中对象,如树木、岩石,甚至绘画痕迹,都能随着导航操作保持一致;
- 支持“promptable world events”,用户可随时文本修改环境,例如改变天气、添加角色等。
核心特性剖析
实时生成 + 长效一致性
Genie 3 能以自回归方式逐帧生成画面,每秒响应用户输入进行帧更新;系统内部跟踪用户先前路径与实时动作,确保环境连贯一致。例如重新经过已访问区域时,原先放置的物体依然保持原位,可视为视觉记忆机制的关键突破。
promptable world events
Genie 3 支持文本驱动的“世界事件”,例如用户发出“在雪地里下雪”或“增加一群鹿”的提示后,环境会即时响应,增加互动深度与可塑性。
多样性与物理模拟能力
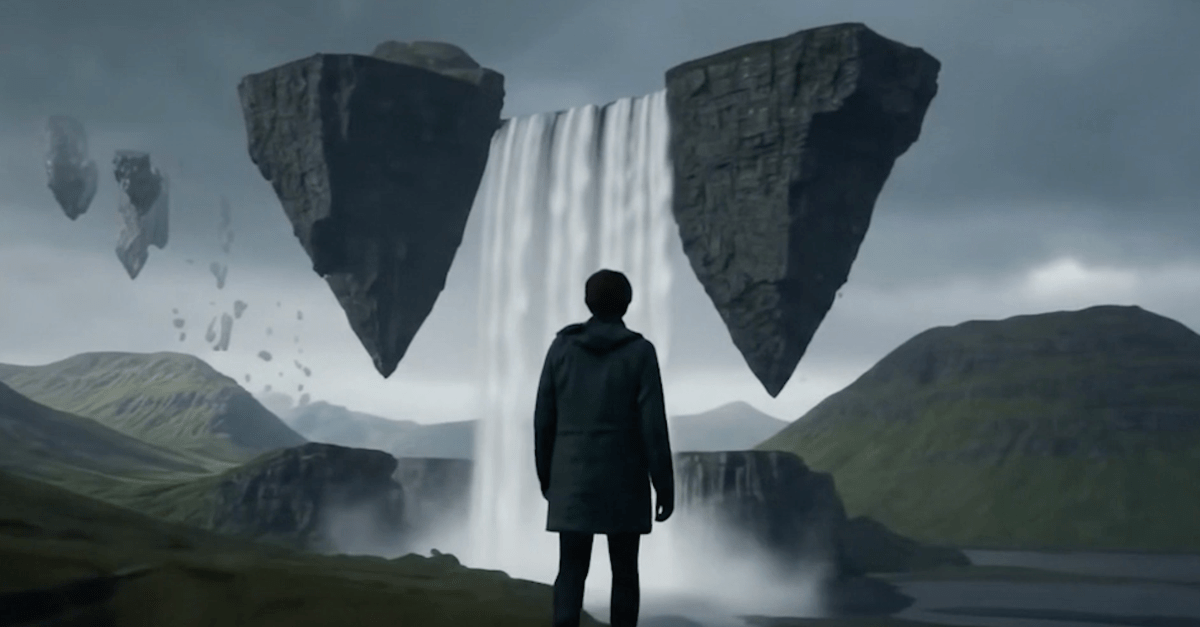
模型能够生成多种风格的真实世界或奇幻场景,例如火山地形、海洋深潜、雪山丛林,甚至未来城市与浮空岛等架构,包含水流、雨滴、风力等物理效果模拟,具有高度视觉丰富性和自然行为表现。
应用于 AGI 和机器人训练
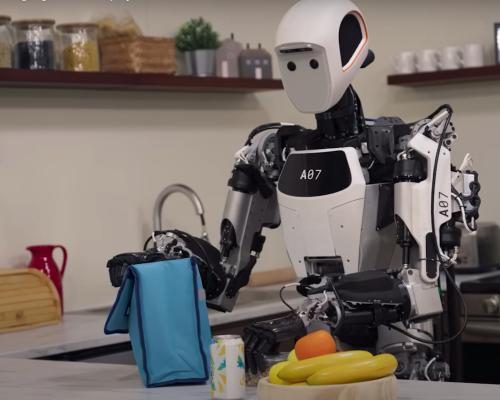
DeepMind 认为此类世界模型在培养可训练 AGI 代理与 3D 环境中自主行动实验中具有关键作用,例如在虚拟仓库环境训练机器人决策、路径规划等任务。其表现已应用于内部代理 SIMA 实验,展示可信度与适用性。
⚠ 限制与待改进方向
- 限制项当前状态动作空间有限用户和 AI 代理可执行的动作仍较基础,复杂交互尚不完善
- 多代理交互模拟多个独立自主行为体(agents)仍具挑战性
- 地理精度不足无法完全模拟真实世界地理位置,只支持虚拟风格场景
- 文本渲染差环境中的可视文本显示仅限于提示输入,清晰度不稳定
- 互动时长限制目前支持连续互动为“几分钟”,不适合超长期会话场景
背景与技术发展脉络
- Genie 1(2024年初)支持 2D 横向世界生成,帧率低、可交互性弱;
- Genie 2(2024 年底)迈入 3D 场景但仅 360p 15 FPS,交互时间短(10–20 秒)且多存在连贯性缺失;
- Genie 3 显著提升至 720p 24 FPS,并支持多分钟连贯互动,成为首个真正可实时交互的世界模型。
这些模型与 DeepMind 的视频生成模型 Veo 3 相辅相成,后者主打短片视频生成(最高支持 4K),但互动性受限;Genie 系列则聚焦交互与环境模拟,是世界模型的重要发展方向。
行业声音与未来视角
- 《卫报》强调 Genie 3 在机器人训练与 AGI 探索中的关键作用,认为其可用于模拟现实场景如仓库、滑雪场等复杂环境,提升智能体决策能力与感知理解能力。
- 科技界评论指出:Genie 3 为迈向虚拟现实与 Holodeck 的重要技术框架,具备潜力用于教育模拟、游戏世界快速生成与 AI 训练环境,但仍需提升 steerability(可操控性)、持续交互能力和真实感表现。
总结与展望
Genie 3 标志着 AI 世界模型的重大进化:真正实现了基于文本提示、具有短期 MEMORY 记忆功能、支持 promptable world events 的高质量、持续互动虚拟世界生成。它不仅在技术上实现突破,也为虚拟训练、教育应用、游戏创作、机器人决策模拟提供了新的可能。
DeepMind 已面向学术界与创意社区开启有限预览,未来或将逐步扩展对研究者、开发者的开放范围。随着分辨率、交互深度与可控性进一步升级,Genie 系列无疑将在生成 AI 和 AGI 研究中扮演中枢角色。
相关报道
Google's new AI model creates video game worlds in real time
Google says its new 'world model' could train AI robots in virtual warehouses
相关文章: