
引言
2026年1月20日,中国AI企业智谱AI(Zhipu AI)正式发布并开源新一代轻量级大语言模型GLM‑4.7‑Flash,同时宣布在智谱开放平台BigModel.cn上线免费API调用。这一举措迅速引发开发者社区热议,被视为“真正免费的编码模型API”和“本地AI编码助手终极指南”的候选者。该模型总参数量30B(300亿),激活参数仅3B(A3B),采用混合专家(MoE)架构和Multi‑head Latent Attention(MLA)机制,在同级别模型中实现性能与效率的双重突破。GLM‑4.7‑Flash将逐步取代前代免费模型GLM‑4.5‑Flash(后者将于1月30日下线,请求自动迁移),为开发者提供低门槛、高性能的云端+本地混合解决方案。 智谱官方公告及多家媒体报道均确认,此次发布是智谱继GLM‑4系列后的一次重要迭代,旨在推动AI从“参数竞赛”向“效率优先”转型。
模型技术架构与核心亮点
GLM‑4.7‑Flash采用MoE(Mixture of Experts)混合专家架构,总参数30B,推理时仅激活3B参数,大幅降低计算需求。关键创新在于首次引入Multi‑head Latent Attention(MLA)机制——这一架构此前由DeepSeek‑v2率先验证有效,如今智谱跟进并优化,显著提升推理效率和长上下文稳定性。 模型支持200K令牌上下文窗口,兼容vLLM、SGLang等主流推理框架,并已适配华为昇腾NPU。量化版本(4bit/8bit)也同步开源,便于消费级硬件部署。
官方定位为“同级别SOTA轻量模型”,专为本地编程、智能体助手、编码任务优化,同时兼顾中文写作、翻译、长文本处理、情感/角色扮演等通用场景。智谱强调,该模型不是简单“压缩版”,而是通过架构创新实现“小而强”:在保持高性能的前提下,将推理成本降至极低。 开发者实测显示,在苹果M5芯片(32GB统一内存)上可达43 token/s,远超同级别模型本地表现。
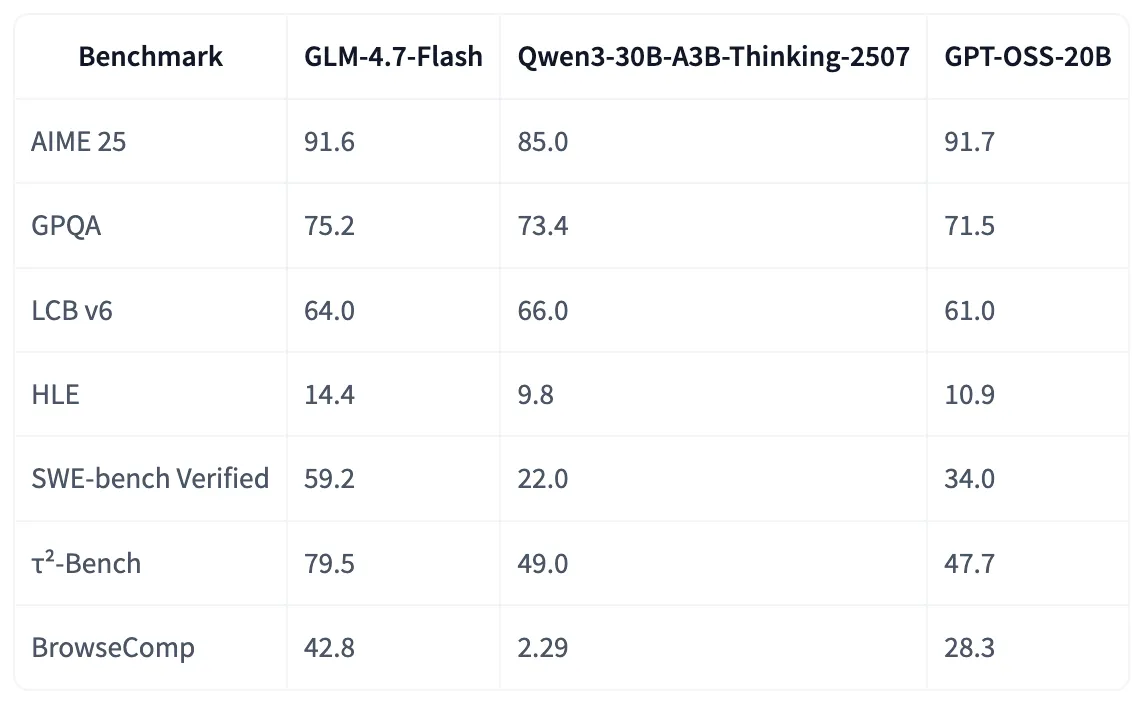
性能基准与社区反馈
在主流基准测试中,GLM‑4.7‑Flash表现出色:
- SWE‑bench Verified:开源同级别SOTA,超越gpt‑oss‑20b、Qwen3‑30B‑A3B‑Thinking‑2507。
- τ²‑Bench:综合得分领先,内部编程实测在前、后端任务均优秀。
- 其他:中文写作、翻译、长上下文、角色扮演场景表现均衡。
MarkTechPost报道称,该模型在轻量部署场景下“平衡性能与效率”,社区测试显示其在UI生成、工具调用和Agentic Coding上尤为突出。 Pandaily补充,GLM‑4.7‑Flash已接入Claude Code、Cline、OpenCode等工具链,成为低成本替代方案。 Hugging Face和Reddit用户反馈,该模型“70B以下最佳体验”,免费API+开源权重极大降低门槛。
API免费调用与使用方式
智谱开放平台BigModel.cn提供GLM‑4.7‑Flash基础版完全免费(限1个并发),高速版GLM‑4.7‑FlashX为付费低价选项。接口兼容OpenAI风格Chat Completions API,支持流式响应、工具调用等。官方文档详尽,包括体验中心、使用指南和接口参考。
使用步骤简要如下:
- 注册/登录BigModel.cn,获取免费API密钥。
- Python示例(兼容openai库):
from openai import OpenAI
client = OpenAI(
    api_key="your_api_key",
    base_url="https://open.bigmodel.cn/api/paas/v4"
)
response = client.chat.completions.create(
    model="glm-4.7-flash",
    messages=[{"role": "user", "content": "写一段Python爬虫代码"}],
    stream=True
)
for chunk in response:
    print(chunk.choices[0].delta.content or "", end="")
- 本地部署:从Hugging Face(zai‑org/GLM‑4.7‑Flash)或ModelScope下载权重,使用vLLM/SGLang运行。
GLM‑4.5‑Flash将于1月30日下线,旧请求自动迁移至新版。
市场意义与影响
GLM‑4.7‑Flash的发布进一步巩固智谱在中文AI生态的领先地位。开源+免费API策略大幅降低中小企业和个人开发者门槛,推动AI从“云端垄断”向“本地普惠”转型。 OSCHINA和知乎社区评价其为“AI工程化大势所趋”的典型代表:轻量模型更适合嵌入智能体、工具链和边缘设备。 与DeepSeek、Qwen等开源模型竞争中,智谱通过MLA架构和免费策略形成差异化优势。
挑战在于:免费版并发限制可能影响高频场景;社区仍需更多第三方基准验证长期稳定性。但整体来看,此次发布标志着中国AI在轻量高效模型领域的重大突破,为全球开发者提供了一个高性价比的选择。
结论
智谱AI的GLM‑4.7‑Flash以30B MoE架构、200K上下文和免费API,实现了“小而强”的典范。它不仅在编程和智能体场景中表现出色,还通过开源生态降低AI使用门槛,推动行业向效率与普惠方向演进。开发者可立即通过BigModel.cn免费体验,或本地部署探索更多潜力。未来,随着社区优化和迭代,这一模型或将成为2026年本地AI编码助手的标杆。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com