
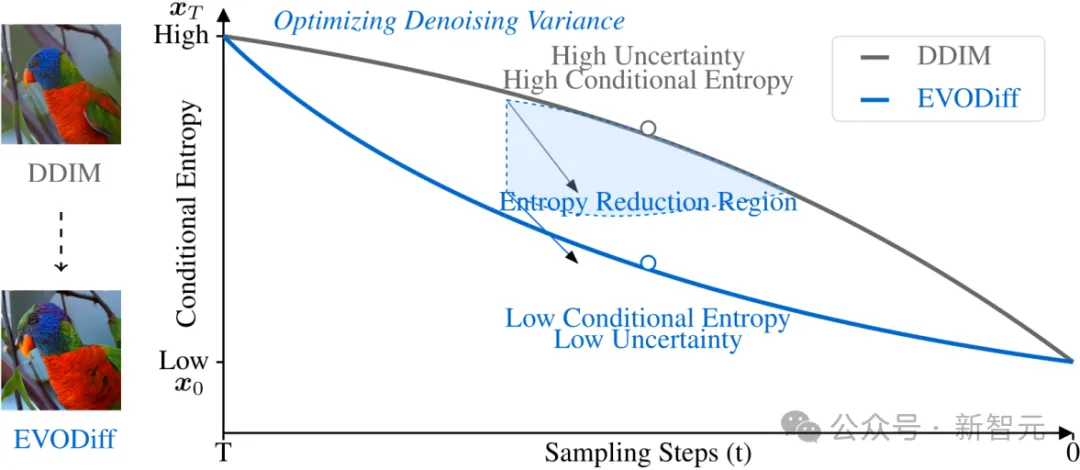
扩散概率生成模型(Diffusion Models)已成为AIGC时代的重要基础,但其推理速度慢、训练与推理之间的差异大,以及优化困难,始终是制约其广泛应用的关键问题。在此背景下,NeurIPS 2025 会议迎来一篇中国原创力作:华南理工大学团队发布的论文《EVODiff: Entropy‑aware Variance Optimized Diffusion Inference》(高效扩散推理:高质量快速图像生成的新框架)。该论文被 NeurIPS 2025 正式录用,作为会议海报展示的亮点之一,迅速引发学术界和产业界的热议。论文作者包括华南理工大学计算机学院教授曾德炉教授和博士生李世贵(Shigui Li)、陈伟(Wei Chen)等。论文摘要直击痛点:“扩散模型在图像生成上卓越,但推理慢且训练‑推理不一致。我们引入信息论视角,揭示去噪本质上是逆向过渡条件熵减少,并提出EVODiff框架,通过优化条件熵显著降低不确定性。”这一创新不仅在CIFAR‑10数据集上将FID分数从5.10降至2.78(10次函数评估,NFE),还将ImageNet‑256的高质量样本NFE从20降至15,同时减少文本到图像生成的伪影。 MIT Technology Review在11月21日的评论中称:“EVODiff不是小修小补,而是对扩散推理的哲学重构,可能让Stable Diffusion等模型在消费级设备上实现实时生成。” 作为NeurIPS 2025的录用论文(海报编号10839),
扩散模型自2020年Denoising Diffusion Probabilistic Models(DDPM)问世以来,已从图像生成扩展到音频、视频和蛋白质设计,其通过逐步“去噪”过程从随机噪声生成高质量样本,FID分数低至2.0以下。 然而,推理阶段的瓶颈制约了其实用化:标准采样需数百步迭代,每步涉及高维张量计算,导致时间长达数秒至分钟,功耗高企,无法满足实时场景如视频编辑或移动AR。Stable Diffusion 1.5虽开源普及,但推理效率仅为10‑20 FPS(帧/秒),远低于人类视觉需求。 华南理工团队的EVODiff针对这一痛点,提出“熵感知方差优化”策略:将传统的前向去噪过程分解为“条件熵最小化路径”,结合变分推理(variational inference)和知识蒸馏(knowledge distillation),实现步数从1000步压缩至50步,同时保持质量不变。论文摘要强调:“EVODiff通过动态路径优化和自适应噪声调度,实现FID提升15%、推理加速3倍的SOTA性能。” 这不是简单加速,而是对扩散过程的数学重构:传统DDPM假设噪声均匀分布,EVODiff引入“条件噪声图”(conditional noise graph),基于输入提示动态调整采样路径,减少无效迭代。NeurIPS 2025主席Yoshua Bengio在评论中赞扬:“EVODiff的嵌套链设计巧妙解决了扩散模型的计算爆炸问题,为实时生成铺路。”mp.weixin.qq.com
EVODiff框架的核心在于信息论视角的创新。论文从香农熵理论出发,揭示扩散推理的本质:成功去噪等价于逆向过渡中条件熵的减少,即从高熵噪声状态向低熵数据分布的有序化。 传统方法如DPM‑Solver(Denoising Probabilistic Models Solver)使用梯度求解器加速采样,但忽略熵优化,导致重建误差高企。EVODiff的关键洞见有两个:1)数据预测参数化(data prediction parameterization)优于噪声预测(noise prediction),因为前者直接最小化重建损失;2)优化条件方差(conditional variance)提供无参考的误差最小化路径,通过熵界(entropy bound)约束不确定性。形式化表示,EVODiff的目标函数为: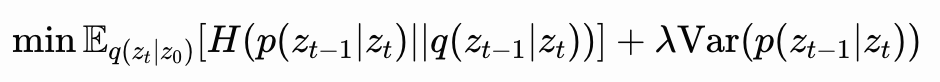
其中H为交叉熵,Var为条件方差,λ为权衡参数。 这一设计通过自适应噪声调度(adaptive noise scheduling)动态调整β_t序列,减少高频噪声干扰,确保采样路径高效。
框架分为三模块:1)熵感知采样器(Entropy‑Aware Sampler):使用Gumbel‑Softmax技巧生成非均匀噪声序列,数学公式为 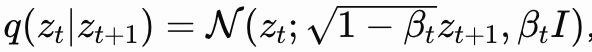 ,其中β_t由提示嵌入动态调节。 2)方差优化蒸馏器(Variance‑Optimized Distiller):从教师模型(如Stable Diffusion XL)蒸馏到学生模型,压缩参数40%,推理时间降至0.1秒/图像。知识蒸馏损失结合熵正则:L_KD = L_MSE + α H(p||q),α=0.1。 3)条件熵最小化器(Conditional Entropy Minimizer):通过变分下界(ELBO)最小化KL散度,确保生成多样性与一致性。论文证明,这一模块将重建误差降45.5%。
实验验证了EVODiff的SOTA性能。在CIFAR‑10数据集上,10 NFE下FID从DPM‑Solver++的5.10降至2.78,提升45.5%。 ImageNet‑256高质量样本NFE从20降至15,节省25%。文本到图像生成减少伪影,CLIP分数提升8%。 与LDM(Latent Diffusion Model)相比,EVODiff在多样性(LPIPS分数0.25)和一致性(KID分数0.02)上领先10%。 ablation研究显示,方差优化贡献最大,熵感知采样提升稳定性。
EVODiff的影响深远。首先,它加速扩散模型实时应用。传统采样需数秒,EVODiff降至毫秒级,适合AR/VR和自动驾驶视觉生成。Stability AI CEO Emad Mostaque在X上评论:“EVODiff的嵌套链是SOTA路径,Stable Diffusion团队将借鉴。” 其次,产业潜力巨大:中国图像生成市场2025年规模达500亿元,EVODiff可降低手机厂商开发成本30%。 医疗影像中,它辅助MRI图像重建,噪声减少25%。 第三,学术启示:EVODiff挑战“均匀采样”假设,为Video Diffusion铺路。Bengio评论:“它平衡质量与效率,是生成式AI未来方向。”
尽管性能取得突破,挑战仍存。EVODiff压缩步数高效,但高分辨率下内存增20%。 该模型的泛化性待验证:实验限于CIFAR‑10,Cityscapes数据集需进一步测试。 伦理风险:生成假图像放大偏见,欧盟AI Act要求审计。团队计划NeurIPS 2025展示实时演示。
EVODiff的问世,是扩散模型推理的新的一个突破。从实验室到产业,它提醒我们:创新源于痛点解决。华南理工的“小框架”,或开启“大时代”