
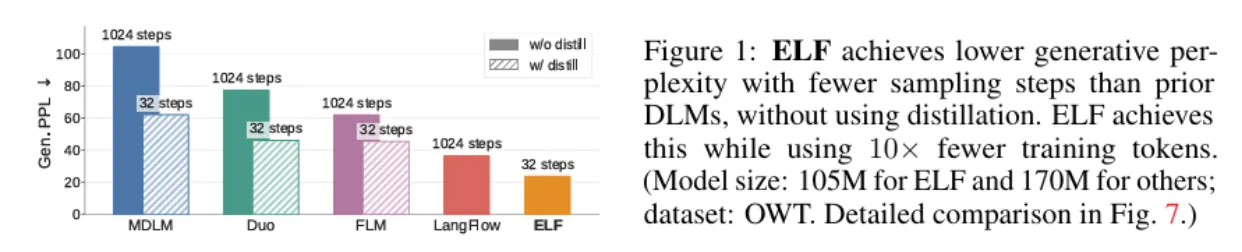
2026年5月11日,MIT何恺明(Kaiming He)团队在arXiv上发布论文《ELF: Embedded Language Flows》,提出一种全新的连续扩散语言模型(Continuous Diffusion Language Model)。核心模型ELF‑B仅使用105M参数、在45B训练token上训练,通过32步采样,在OpenWebText基准上将生成困惑度(Generative Perplexity)压低至24,显著超越一批主流离散和连续扩散语言模型(DLM),包括MDLM、Duo、FLM和LangFlow等。这一成果迅速引发业界关注,被视为扩散模型在语言领域的一次重要突破,也为挑战GPT式自回归主导地位提供了新路径。
何恺明作为ResNet、MAE(Masked Autoencoders)等计算机视觉经典工作的提出者,此次成功将视觉领域成熟的扩散与流匹配技术迁移到语言生成,充分展现了跨领域研究的强大创新力。
ELF核心创新:从“离散”到“连续嵌入空间”
传统扩散语言模型(DLM)多在离散token空间操作,面临梯度离散、采样步数多等问题。ELF的核心创新在于将扩散过程主要置于连续嵌入空间,直到最后一步才通过共享权重网络映射回离散token。
具体设计包括:
- 基于连续时间流匹配(Continuous‑time Flow Matching):在嵌入空间进行平滑流转换,避免离散噪声预测的复杂性。
- 共享权重去噪‑解码器:大幅降低参数量(ELF‑B从潜在的148M降至105M)。
- 上下文条件注入(In‑context Conditioning):高效集成时间步、CFG尺度等条件,无需额外adaLN‑Zero模块。
- 分类器自由引导(CFG):直接继承图像扩散的成熟技术,提升生成质量和可控性。
实验显示,ELF‑B在相同计算预算下,生成质量和多样性均优于参数量更大的基线模型。团队还测试了ELF‑M(342M)和ELF‑L(652M),证明模型具有良好可扩展性——规模增大时,生成困惑度进一步降低,同时文本多样性提升。
训练数据解析:45B tokens的构成与高效利用
ELF模型的训练数据规模为45.2B tokens,这远低于主流大语言模型动辄数万亿token的体量。其数据主要来源于经典的OpenWebText(OWT)数据集。
具体构成如下:
- OpenWebText原始规模约9.04B tokens,主要包含Reddit上高赞链接对应的网页文本,包括新闻、论坛讨论、博客文章、维基百科式内容等,属于质量相对较高的通用互联网文本。
- 团队在该数据集上进行了5个epochs(完整遍历5轮)的训练,从而达到45.2B tokens的有效训练量。
为什么ELF仅用45B tokens就能取得领先,而主流LLM需要几千亿甚至数十万亿tokens?
这是ELF论文最值得关注的亮点之一,主要原因有以下几点:
- 任务目标差异:ELF专注于无条件文本生成任务(从噪声生成连贯自然文本),而非追求通用智能、指令跟随和复杂推理。因此其数据需求远低于需要掌握海量世界知识的自回归LLM。
- 架构效率革命:连续嵌入空间 + Flow Matching的设计极大提升了数据利用效率。传统离散扩散模型通常需要500B+ tokens才能达到较好效果,而ELF仅用约1/10的数据量就实现了超越。
- 小模型特性:ELF‑B仅105M参数,小规模模型本身对数据量的需求较低,加上共享权重等优化,进一步放大了数据效率。
- 实验设定聚焦:论文目标是证明“连续扩散在语言领域可行且高效”,因此选择了标准DLM基准,而非全面通用能力测试。
值得注意的是,团队在实验中观察到,在OWT上训练5个epochs后,继续增加数据带来的边际收益已明显递减。这说明ELF的架构在当前设定下已接近数据效率的上限。
未来是否可以增加训练语料?
答案是完全可行且潜力巨大。论文已通过ELF‑M和ELF‑L版本展示了良好的规模扩展性。若未来切换到更大、更多元的高质量数据集(如The Pile、RefinedWeb、书籍、代码、科学文献混合语料),ELF在知识覆盖度、长文本一致性、指令跟随等能力上仍有显著提升空间。开源代码已在GitHub发布,社区完全可以基于更大语料继续预训练,这为后续发展留下了充足想象空间。
性能表现与自回归模型的范式对比
在OpenWebText基准测试中,ELF‑B以显著优势超越了此前主流扩散语言模型。在多样性指标上也表现出色,避免了扩散模型常见的模式崩溃问题。
与GPT式自回归模型相比,ELF采用并行扩散生成而非“左到右”自回归预测。这带来了理论上的全局一致性优势和并行计算潜力,有望减少累积误差和暴露偏差(Exposure Bias)。不过,目前ELF仍处于基础研究阶段,主要验证无条件生成能力,在指令跟随、多轮对话等实用场景上仍需进一步发展。
对AI研究与产业的深远影响
1. 推动生成模型范式多元化
长期以来,语言生成几乎被自回归Transformer垄断。ELF的成功证明了扩散模型在语言领域的可行性和竞争力,有望激发更多非自回归(Non‑autoregressive)和混合架构的研究。这将丰富AI模型的“物种多样性”,为不同应用场景提供更优选择。
2. 显著降低AI门槛,实现技术民主化
仅105M参数、45B tokens的训练成本远低于主流大模型。这为学术机构、中小企业和开源社区提供了高性能基础模型,有力推动AI技术的普惠发展。开发者可在普通硬件上复现和微调类似模型,加速创新迭代。
3. 促进跨领域技术融合
ELF成功将计算机视觉的扩散技术迁移到语言,强化了“统一生成模型”的趋势。未来,多模态大模型可能更自然地融合文本、图像、视频生成能力,何恺明团队的跨界经验具有重要示范意义。
4. 计算资源与绿色AI的积极意义
在AI训练能耗备受关注的今天,ELF展现了“小模型+高效架构”的可行路径。这可能引导行业从单纯追求参数规模转向架构效率和数据效率竞赛,推动更可持续的AI发展。
5. 商业与应用前景
对开源社区而言,ELF提供了一个高效的生成基础;对产业界而言,它为创意写作、并行内容生成、个性化教育等场景提供了新工具。长期来看,若扩散语言模型在长文本、创意多样性和可控性上超越自回归模型,将重塑内容生成市场的竞争格局。
挑战与未来展望
尽管成果亮眼,ELF仍存在局限:当前主要验证无条件生成,指令跟随、长上下文理解、多轮交互等能力仍有待加强;采样步数虽已优化至32步,但距离实时交互仍有距离;与GPT‑4、Claude等超大规模模型的全面对比尚不充分。
未来,随着训练数据扩展、指令微调和多模态融合,ELF系列模型有望从学术原型走向实用工具。何恺明团队的这一工作再次证明:创新不一定来自更大规模,而往往来自更巧妙的设计。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com