
2026年2月4日,MIT与Harvard联合团队在arXiv上发布了题为《Generative Modeling via Drifting》(通过漂移实现生成建模)的最新论文(arXiv:2602.04770)。该论文由Mingyang Deng、He Li、Tianhong Li、Yilun Du和Kaiming He(何恺明)共同完成,提出了一种全新的生成建模范式——Drifting Models(漂移模型)。这一方法将传统扩散模型和流模型中需要在推理阶段反复迭代的“分布匹配”过程,彻底转移到训练阶段,从而实现真正意义上的高质量单步(one‑step)生成。
论文在ImageNet 256×256数据集上取得了令人震惊的成绩:在潜在空间(latent space)FID达到1.54,像素空间(pixel space)FID达到1.61,单步生成质量超越此前所有单步生成器,并接近甚至在部分指标上超过多步扩散模型。这一成果被社区迅速称为“生成模型领域的范式转变”,标志着AI生成技术从“多步迭代”向“单步高效”的关键跃进。
传统生成模型的痛点:推理阶段的迭代瓶颈
当前主流生成模型(如扩散模型Diffusion、流模型Flow‑based、GAN等)本质上都是在学习一个从噪声分布到数据分布的“推前映射”(pushforward map)。然而,这些模型普遍存在一个根本性缺陷:训练时学习的是固定映射,但推理时却需要通过多步迭代来逐步逼近目标分布。
扩散模型需要数百甚至上千步去噪,流模型虽可单步但训练极其困难,GAN虽单步但模式崩溃问题突出。这种“训练‑推理不对称”导致了生成效率低下、计算成本高昂、实时性差等问题。特别是在需要高分辨率、复杂语义或实时交互的场景中(如视频生成、机器人控制、交互式设计),多步迭代成为难以忍受的瓶颈。
论文作者在摘要中直指这一痛点:“生成建模可以表述为学习一个映射f,使其推前分布匹配数据分布。但现有方法要么在推理时需要迭代,要么训练极不稳定。我们提出Drifting Models,在训练过程中动态演化推前分布,从而自然地支持单步推理。”
Drifting Models核心思想:训练时“漂移”,推理时“一步到位”
Drifting Models的核心创新在于将分布演化过程从推理时间前移到训练时间。
传统方法中,模型学习一个固定映射f:噪声 → 数据,需要在推理时反复应用f(或其逆)来逐步漂移样本。Drifting Models则让映射本身在训练过程中“漂移”(drift):模型不再学习一个静态f,而是学习一系列逐渐演化的映射f_t,这些映射在训练的不同阶段推动分布从简单噪声逐步“漂移”到复杂数据分布。
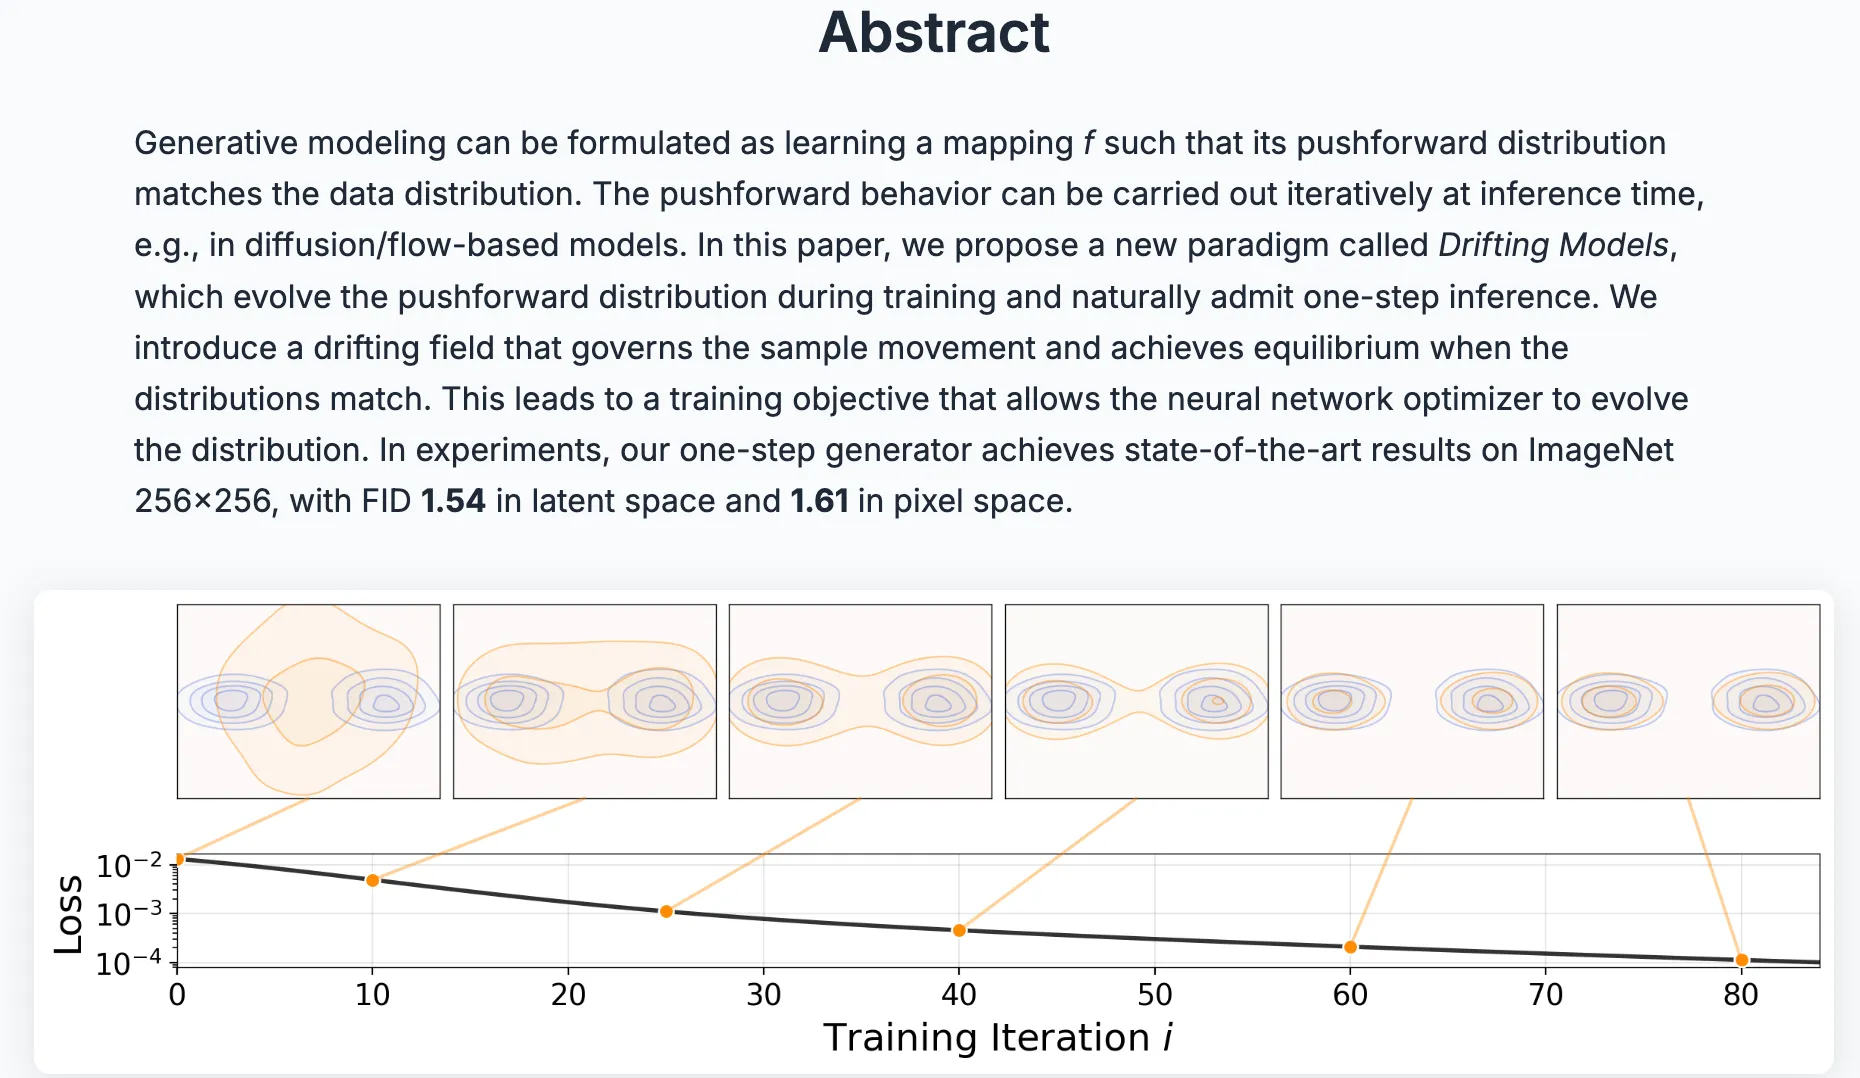
具体而言,作者引入了一种漂移损失(Drifting Loss),通过特征编码器(feature encoder)在多个尺度上计算当前生成分布与真实数据分布之间的“漂移方向”,并用该方向指导模型参数更新。训练过程中,模型的推前分布不断向数据分布“漂移”,最终在收敛时,模型已学会一个直接从噪声映射到高质量数据的单步函数。
如论文图1所示,Drifting Models的训练过程可视化为一条动态演化的“漂移轨迹”:早期阶段分布简单、噪声主导,晚期阶段分布复杂、细节丰富,整个过程无需在推理时重复迭代。
论文还设计了多尺度特征漂移损失(Multi‑scale Drifting Loss),如图3所示,在ResNet的不同阶段提取特征图,对每个特征独立计算核函数(kernel)、漂移向量和损失,最终加权求和。这种设计极大提升了模型对细粒度纹理和高层次语义的捕捉能力。
实验结果:ImageNet单步生成SOTA,机器人任务也表现出色
在标准基准ImageNet 256×256上,Drifting Models取得了当前单步生成器的最佳成绩:
- 潜在空间FID:1.54(此前最佳单步模型约2.1–3.5)
- 像素空间FID:1.61
- 单步生成:仅需一次前向传播(one neural function evaluation)
如论文图4和图5所示,Drifting Models生成的图像在细节、连贯性和多样性上均显著优于此前单步方法,与多步扩散模型(如DiT、SiT)相比,质量差距已大幅缩小,同时速度提升数十倍。
更令人惊喜的是,Drifting Models在非图像任务上也展现出强大泛化能力。论文在机器人控制任务中测试了模型的漂移机制,结果显示其在连续控制和轨迹规划上的表现优于传统强化学习基线,证明了“漂移范式”对连续动态系统的适用性(见论文图7机器人实验结果)。
作者还对比了不同预训练特征编码器(MAE、DINOv2等),结果表明定制MAE编码器在漂移损失计算中表现最佳,进一步验证了方法的鲁棒性。
与现有范式的对比:从“迭代”到“漂移”的范式转变
Drifting Models与现有生成模型形成了鲜明对比:
- 扩散模型:推理多步、训练稳定,但速度慢。
- 流模型:可单步,但训练难度极大,对架构要求苛刻。
- GAN:单步快,但模式崩溃和训练不稳定问题突出。
- Drifting Models:训练时动态漂移,推理单步,兼具稳定性和效率。
论文作者Kaiming He(何恺明)团队长期深耕视觉与生成领域,此次提出Drifting范式,被视为对“生成即映射”经典观点的重新定义。社区迅速跟进讨论,认为这一工作为解决生成模型的“效率‑质量权衡”提供了全新思路。
潜在影响与未来方向
Drifting Models的出现,对AI生成领域具有多重深远意义:
- 实时生成落地:单步高质生成将极大推动实时视频、交互式设计、游戏内容生成等应用。
- 计算效率革命:推理成本大幅降低,有望让高性能生成模型在消费级设备上运行。
- 机器人与具身智能:漂移机制天然适合连续动态系统,或加速具身AI发展。
- 理论启发:将分布演化显式建模到训练过程中,为生成模型提供新的数学框架。
论文也坦诚指出了当前局限:漂移损失对特征编码器敏感,在极高分辨率(如1024²)上的表现仍有提升空间,未来可结合更先进的编码器或混合漂移策略进一步优化。
作者已在项目页面宣布,将很快开源ImageNet训练代码和预训练模型,供社区复现与扩展。
结语:生成模型的“漂移”时代
《Generative Modeling via Drifting》提出的Drifting Models范式,以简洁而深刻的方式重构了生成建模的核心逻辑:不再让模型在推理时“一步步走”,而是让它在训练时“一步步漂移”。这一转变不仅带来了单步生成质量的飞跃,更为AI理解和创造复杂分布开辟了新路径。
在2026年AI技术加速演进的今天,Drifting Models的出现提醒我们:真正强大的生成能力,或许不在于更深的网络或更多的参数,而在于对分布演化过程的深刻洞察。当生成模型从“迭代模拟”走向“漂移塑造”,AI创作的效率与创意边界将被再次打破。
这一工作,由Kaiming He团队与MIT‑Harvard合作完成,再次彰显了中国学者在国际顶级AI研究中的影响力。未来,随着代码开源和社区跟进,我们有望看到Drifting范式在视频生成、3D内容、机器人控制等更多领域的精彩应用。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com