
2026年9月10日,深度求索(DeepSeek)正式发布 DeepSeek V4.1 Flash 模型。这是其全新模型结构系列中的最小尺寸版本,具备原生多模态视觉理解能力。官方明确表示,新架构的设计目标是:能力上限更高、推理速度更快、吞吐更大,并可平滑扩展到更大参数规模的模型。API 已同步上线,模型名称为 deepseek‑flash。
详细情况:架构创新与性能表现
DeepSeek V4.1 Flash 是一款 552B 参数的混合专家(MoE)模型,采用全新的 Causal‑Encoder‑Decoder(CED,因果编码器‑解码器) 结构。输入与输出不对称:输入侧激活参数约 8B,输出侧约 16B,相比已知同规模模型显著降低推理成本。模型原生支持图像与文本联合输入,并自回归生成文本,无需外挂视觉模块。
其他关键技术特征包括:
- 支持最长 100万 Token 上下文;
- 预训练使用约 45T 多模态语料,稀疏注意力在 64K 序列长度上训练,并在后续扩展至 1M;
- 后训练沿用 SFT → 强化学习 → 在策略蒸馏(OPD)流程;
- KV Cache 大幅压缩:相比上一代,HBM 需求降至约 1/4,SSD 需求降至约 1/8,整体缓存规模相对初代模型已缩小数百倍,显著降低长上下文与多轮 Agent 场景的存储与费用开销。
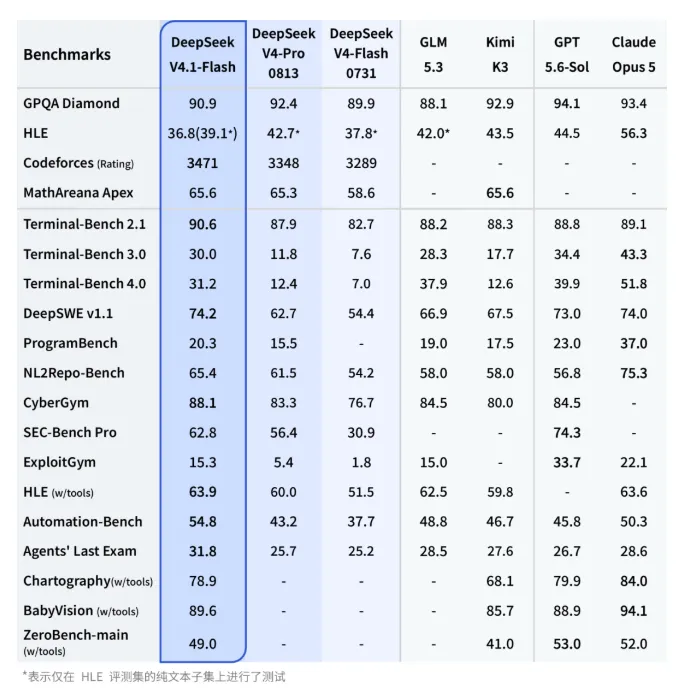
官方公布的部分基准成绩显示,V4.1 Flash 在多项任务上表现突出,例如 GPQA Diamond 90.9、Terminal‑Bench 2.1 90.6、DeepSWE v1.1 74.2、CyberGym 88.1 等,并在综合测试中宣称已全面超越此前的旗舰模型 DeepSeek V4 Pro(涵盖性能、成本、速度与总耗时)。
API 与产品策略调整
V4.1 Flash 上线后,原 V4 Flash 与 V4 Flash Vision Exp 已下线,相关旧模型名暂时路由至新模型。官方计划于北京时间 2026年9月14日 12:00 起,将 V4 Pro 的请求全部路由到 V4.1 Flash,并按 Flash 单价计费,直至后续 V4.1 Pro 正式上线。此举意味着在过渡期内,聊天与 API 流量将高度集中于 V4.1 Flash。
定价同步下调,并继续采用峰谷分时计费:闲时输入缓存命中、缓存未命中与输出价格分别为每百万 Token 0.02 元、1 元、4 元,高峰时段为闲时的两倍。新价格自 9月10日 12:00 起生效。腾讯相关产品与部分合作伙伴已接入新模型。
可能影响:性价比重塑与架构演进信号
1. 对开发者与用户的影响
更低的激活参数、大幅压缩的 KV Cache 与下调后的价格,使长上下文、多轮 Agent 与多模态任务的实际成本明显下降。性能宣称超越前代 Pro,却以 Flash 定位和价格提供服务,进一步强化了 DeepSeek 在“高性价比”赛道的优势,可能吸引更多中小团队与高频调用场景。
2. 对模型产品线的影响
将快速、专家、识图等模式合并,并计划用 Flash 临时承接 Pro 流量,显示公司正加速收敛产品矩阵、简化用户选择。这也暗示新架构的扩展性较强,后续更大尺寸的 V4.1 系列模型有望快速跟进。
3. 对行业竞争格局的影响
在 OpenAI、Anthropic、国产其他厂商持续迭代的背景下,DeepSeek 以全新 CED 结构 + 激进 KV 压缩 + 原生多模态,再次强调“架构创新驱动效率与能力双提升”。若实际体验与基准相符,将进一步压缩中高端 API 的价格空间,并推动更多厂商关注非对称激活、缓存压缩与可扩展架构。
4. 技术演进意义
Causal‑Encoder‑Decoder 与大幅 KV 压缩,是应对长上下文与 Agent 场景成本瓶颈的重要尝试。输入侧低激活、输出侧相对更高的设计,体现了“推理时按需分配算力”的思路。原生多模态从预训练阶段就深度融合,也有利于视觉‑语言任务的一致性表现。
5. 潜在观察点
官方基准与“全面超越 V4 Pro”的表述仍需第三方复现与真实业务验证。路由策略可能导致部分重度 Pro 用户在过渡期体验变化;更大尺寸模型的实际落地时间与开源计划,将决定新架构的长期影响力。
结语
DeepSeek V4.1 Flash 的发布,是深度求索在 2026 年模型迭代中的一次重要节点。它以“最小尺寸新架构 + 原生多模态 + 显著效率提升”的组合,试图在能力、速度与成本之间找到更优平衡,并用实际产品策略(价格下调、流量归并)快速推向市场。
若后续真实使用数据与更大模型验证了新架构的扩展性,这一系列可能成为国产大模型在长上下文、Agent 与多模态场景中的重要技术路线。对整个行业而言,它再次提醒:在参数规模竞赛之外,结构创新与推理效率,正成为决定落地竞争力的关键变量。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com