
2026年4月17日,在经过多篇论文铺垫以及用户的千呼万唤之后,中国AI初创公司DeepSeek正式发布备受期待的DeepSeek V4,这是该公司继V3系列之后又一重量级开源大模型。该模型采用约1.6万亿参数的MoE(Mixture of Experts)架构,在SWE‑Bench Verified等编码基准上取得领先成绩,被业内视为国产开源模型在编程能力上的一次重要突破。DeepSeek V4已通过官方API和Hugging Face平台提供访问,并计划全面开源权重和代码,标志着中国AI企业在高效大模型领域的持续领先。
DeepSeek V4的发布正值全球AI竞争白热化之际。此前智谱AI GLM‑5.1和Minimax2.7的开源已掀起一轮国产模型热潮,DeepSeek V4的亮相进一步巩固了中国AI在开源高性能赛道上的位置。DeepSeek CEO表示,V4的目标是“以极致性价比提供接近甚至超越国际顶尖闭源模型的编码与推理能力”,为开发者、企业和研究者提供更实用的AI工具。
核心创新点:Engram记忆架构与高效MoE设计
DeepSeek V4的最大创新在于其Engram条件记忆架构(Engram Conditional Memory)。这一机制允许模型在处理超过100万token的超长上下文时,仍能高效检索和利用关键信息,显著提升了长文档分析、多文件代码理解和复杂推理能力。与传统向量检索不同,Engram采用条件记忆方式,根据当前任务动态激活相关知识,减少了无关信息的干扰,实现了“记忆即计算”的高效融合。
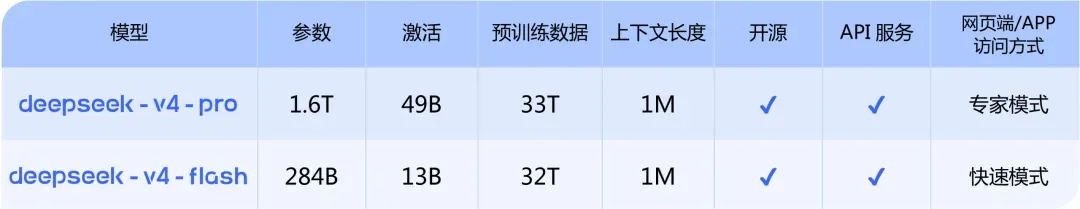
在架构层面,DeepSeek V4本次发布两个版本,其中V4‑pro版本采用约1.6万亿总参数、激活参数约49B的MoE架构,V4‑flash版本采用约284B亿总参数、激活参数约13B的MoE架构,结合DeepSeek Sparse Attention机制,在保持高性能的同时大幅降低推理成本。模型支持1M token上下文窗口,在Needle‑in‑a‑Haystack测试中准确率达到97%,远超标准注意力机制的84.2%。这一设计使V4在处理大型代码仓库、长篇研究报告等场景时表现出色,同时推理成本仅为同级别闭源模型的1/10左右。
编码能力是DeepSeek V4的突出亮点。在SWE‑Bench Verified基准上,V4得分达到80%以上,领先Claude Opus 4.6(约80.8%)和GPT‑5.4(约77.3%)。在HumanEval上得分约90%,在复杂多文件项目中的自主规划和调试能力显著增强。DeepSeek团队表示,这些成绩得益于大规模代码数据清洗和针对agentic任务的专项强化学习,使模型在真实软件工程场景中更具实用性。
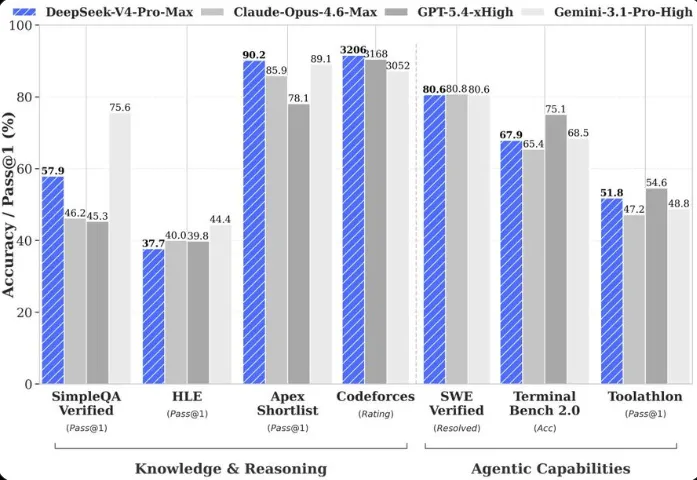
此外,V4还支持原生多模态输入(文本、图像、视频),并在数学推理(AIME 2026得分92%)和通用知识(MMLU得分89%)上表现出色。整体而言,V4以中小激活参数实现了“以小胜大”的效果,体现了DeepSeek在训练效率和模型压缩上的技术积累。
基准指标与性价比优势
根据官方和第三方评测,DeepSeek V4在多项关键基准上取得领先:
- SWE‑Bench Verified:80%+(领先多数开源模型,接近或超越部分闭源顶级模型)
- HumanEval:约90%
- MMLU:约89%
- Needle‑in‑a‑Haystack(1M token):97%
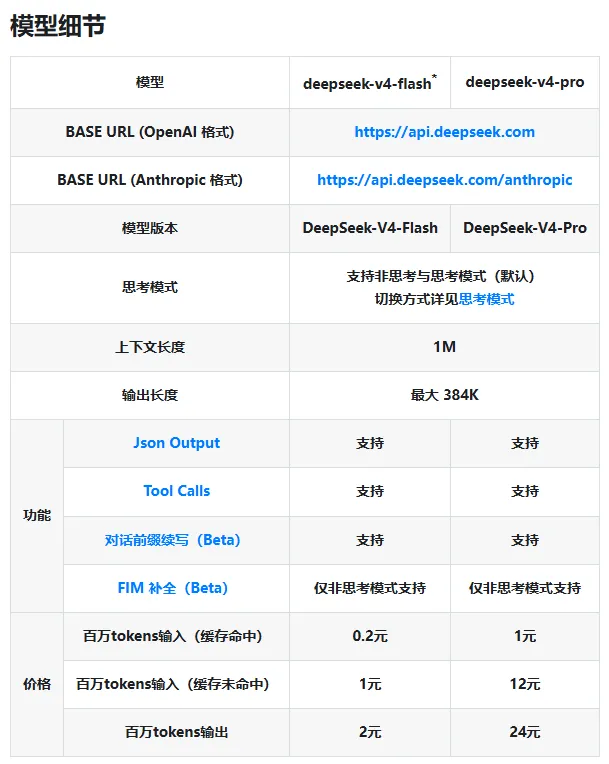
- 推理成本:输入约$0.14/百万token,输出约$1.75/百万token,远低于Claude和GPT系列
这一性价比优势使V4特别适合开发者、本地部署和企业级应用。开源后,社区已开始将其集成到OpenClaw、Cline等Agent框架中,预计将进一步降低AI编码工具的使用门槛。
行业影响:国产开源AI进入高性能时代
DeepSeek V4的发布对全球AI生态产生多重影响:
- 开源社区活力:全面开源将吸引大量开发者参与微调和垂直优化,推动AI Agent、代码助手等工具的爆发式增长。
- 国际竞争格局:V4在编码能力上的领先,进一步缩小了中国AI与国际顶尖闭源模型的差距,也为全球开发者提供了高性价比替代方案。
- 商业化示范:DeepSeek通过开源吸引流量、保留企业级API服务,形成了“开源普惠+商业闭环”的健康模式,为行业提供了新范例。
- 对闭源巨头的压力:OpenAI、Anthropic等公司面临开源高性能模型的竞争,预计将加速自身模型迭代和定价调整。
对中国AI产业而言,V4的成功再次验证了“高效MoE架构+自主算力”的可行性。DeepSeek在华为芯片上的训练实践,也为国内企业自主可控的AI发展路径提供了重要参考。
挑战与未来展望
尽管成绩亮眼,DeepSeek V4作为新模型,在极长上下文、多语言复杂任务和长期稳定性上仍有优化空间。开源后,如何平衡社区贡献与商业化路径,以及如何应对潜在安全风险,也将成为DeepSeek面临的新课题。
DeepSeek团队表示,未来将继续迭代V系列模型,并加强与开源社区的合作。GLM‑5.1、Minimax2.7和DeepSeek V4的接连开源,共同标志着2026年国产大模型进入“高性能开源时代”。随着更多企业跟进,这一趋势有望推动中国AI在全球舞台上占据更重要的位置。
DeepSeek V4的发布,不仅是一次技术突破,更是国产开源AI自信与实力的集中体现。它证明:在算力自主、数据积累和工程优化的共同作用下,开源模型完全有能力在关键基准上追平甚至超越闭源前沿。这一事件或将加速全球AI从“闭源垄断”向“开源普惠+高端竞争”并存的新格局转变。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com