
2026年10月17日,DeepSeek正式发布DeepSeek‑V4.1‑Flash‑1017,并同步开源模型权重。官方将其定位为对9月发布的DeepSeek‑V4.1‑Flash的一次“小幅更新”,但实际在推理、编码、智能体任务及视觉基准上实现了显著提升,同时缩短了任务执行时间与输出长度,进一步优化了性能与成本的帕累托前沿。模型已在DeepSeek官网、App与API全面上线,调用方式与价格保持不变(仍使用deepseek‑flash标识),权重以MIT协议发布于Hugging Face与ModelScope。
核心升级与性能表现
DeepSeek‑V4.1‑Flash‑1017是基于V4.1‑Flash的迭代版本,总参数规模约763B,采用MoE架构,支持100万token上下文与最高38.4万token输出,具备原生多模态(文本+图像)能力。官方强调,新版本通过带自我反馈的强化学习,强化了端到端项目开发能力,能够从简单描述直接生成完整可运行项目。
根据DeepSeek公布的对比数据,新模型在多项关键基准上均有提升:
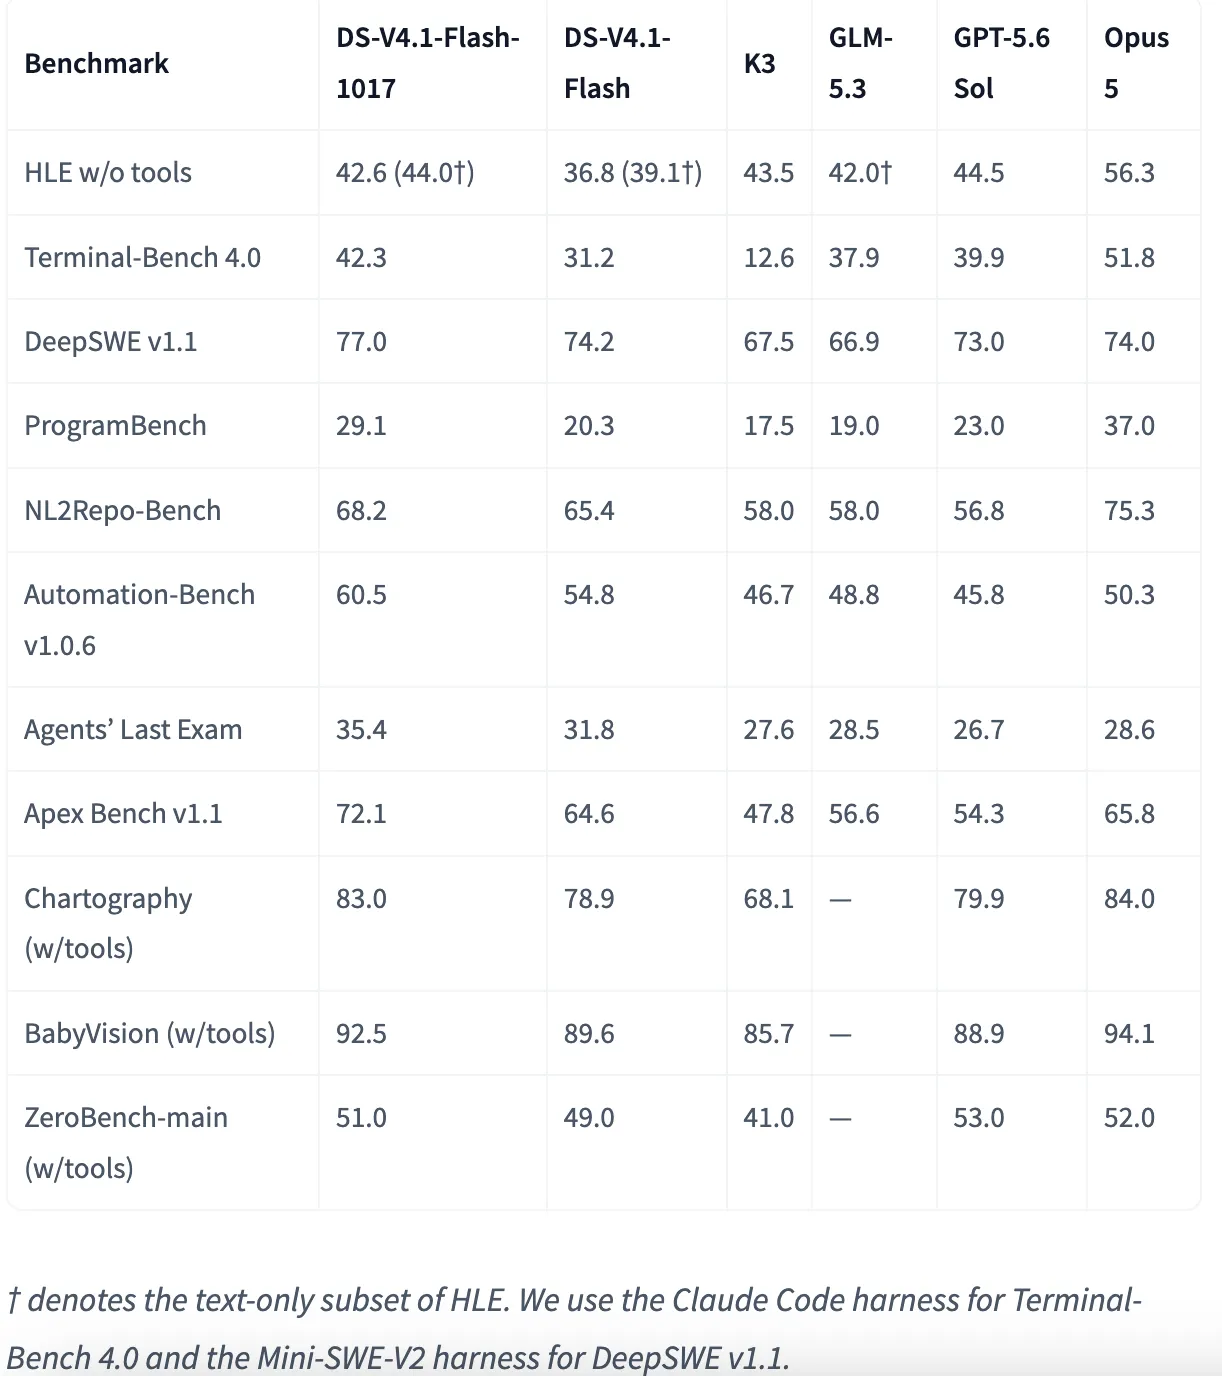
其中,Terminal‑Bench 4.0的大幅跃升尤为引人注目,显示模型在真实终端环境中的多步骤操作、错误恢复与工具调度能力有实质性进步。DeepSWE v1.1达到77.0,在官方对比表中略高于Claude Opus 5(74.0)与GPT‑5.6 Sol(73.0)。需要指出的是,这些均为厂商自测数据,独立第三方验证仍需时间。
更值得关注的是效率改进:模型在完成任务时输出更短、执行更快,从而在多个智能体测试框架下降低了单任务成本。官方称这实现了“性能—成本”的帕累托改进。API定价保持不变,峰值缓存未命中输入约0.30美元/百万token、输出1.20美元/百万token(非高峰半价),实际使用中因输出缩短,整体费用进一步下降。
“愿望驱动编程”与实际演示
官方将新模型的核心能力概括为“Wish‑Driven Programming”(愿望驱动编程)——用户只需提出高层愿望,模型即可自主完成从规划、编码、调试到交付的完整流程。官方展示了多个从零构建的完整项目,包括故宫建筑3D建模、网页版赛车游戏、使用Godot引擎重制《Portal 2》,以及展示史前到现代演变的3D场景“Valley of Ages”。这些演示突出了模型在长程软件工程与多模态理解上的进步。
同时,DeepSeek首次向外部开发者开放了自研搜索引擎驱动的Search与Fetch API,每个端点定价为0.75美元/千次调用。通过DeepSeek Harness、Claude Code或Codex等服务端工具调用时,暂免费至2026年10月31日16:00 UTC。
开源与部署
模型权重以MIT协议在Hugging Face(deepseek‑ai/DeepSeek‑V4.1‑Flash‑1017)和ModelScope同步开源,便于社区进行本地部署与二次开发。由于其参数规模较大,完整运行对硬件要求较高(需多卡并行与优化推理框架,如vLLM),社区已开始跟进量化与适配工作。
可能影响与客观评估
DeepSeek‑V4.1‑Flash‑1017的发布延续了该公司“高性价比+开源”的路线。作为面向智能体与编码场景的轻量级(相对旗舰)模型,它在保持极低API成本的同时,显著拉近了与部分闭源前沿模型在特定任务上的差距,尤其在终端操作与端到端软件开发上。
对开发者而言,这是一次“免费升级”——现有deepseek‑flash调用无需修改代码即可享受更高性能与更低实际成本。开源权重进一步降低了私有部署与定制门槛,有助于推动智能体应用的快速落地。
然而,客观来看,仍需注意几点:首先,基准数据主要为厂商报告,真实复杂场景下的稳定性与泛化能力有待更多独立评测验证;其次,在纯推理能力(如HLE)上仍明显落后于Claude Opus 5等顶级闭源模型;再次,超大参数量带来的部署门槛,对普通个人开发者仍不友好。此外,“愿望驱动编程”虽具吸引力,但实际生产环境中的可靠性、安全性与可维护性仍需长期观察。
总体而言,DeepSeek此次更新再次证明了后训练与强化学习在提升实用智能体能力上的有效性,也巩固了其在高性价比开源模型阵营中的领先位置。对于追求成本敏感、长程编码与智能体工作流的用户,V4.1‑Flash‑1017提供了一个极具竞争力的新选择。未来,社区的实际部署反馈与第三方评测,将进一步检验其真实价值。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com