
在各大AI公司(包括OpenAI、Google、xAI、Anthropic)发布最新模型版本升级之后,中国 AI 初创公司 DeepSeek 再度出手重拳,于 12 月 1 日正式开源推出 DeepSeek‑V3.2 及其高性能变体 V3.2‑Speciale。这两款模型以“推理优先”为设计核心,专为智能代理(agent)时代打造,被誉为“开源 AI 的新王者”。V3.2 作为 V3.2‑Exp 的正式继任者,提供 GPT‑5 级别的平衡性能;V3.2‑Speciale 则在深度推理上更进一步,超越 GPT‑5 并匹敌 Google 的 Gemini 3.0 Pro,在国际数学奥林匹克(IMO)和信息学奥林匹克(IOI)等顶级赛事中斩获金牌级成绩。 这一发布不仅标志着开源模型在复杂推理领域的突破,还以 MIT 许可免费开源和超低成本 API(输入 100 万 token 仅 0.28 美元)重塑了 AI 商业格局,引发业界对中美 AI 竞争的热议。
DeepSeek 的这一步棋来得恰逢其时。2025 年,全球 AI 市场正从“规模竞赛”转向“推理效率”较量。OpenAI 的 GPT‑5 和 Google 的 Gemini 3.0 Pro 以封闭式高性能主导高端应用,但高昂的训练与推理成本(GPT‑5 每百万 token 超 10 美元)令开发者望而却步。 DeepSeek V3.2 系列则以 6850 亿参数规模、128K 上下文窗口和开源权重,直接填补这一空白。目前,V3.2 已全面上线 DeepSeek 的 App、Web 平台和 API 接口;V3.2‑Speciale 暂限 API 访问(专用端点:https://api.deepseek.com/v3.2_speciale_expires_on_20251215),将于 12 月 15 日前限时提供,后续能力将融合进标准版。 两款模型均可在 Hugging Face 上免费下载,支持 LoRA 微调和全参数训练,配备 Python 脚本以兼容 OpenAI 格式,便于开发者快速集成。
技术层面,DeepSeek V3.2 系列的最大亮点在于“DeepSeek Sparse Attention”(DSA)机制,这一创新将传统 Transformer 的二次方注意力复杂度降至近线性水平。 DSA 通过“闪电索引器”(lightning indexer)为每个查询 token 仅选取 top‑k(固定 2048)个关键历史 token 进行核心计算,索引器本身采用 FP8 精度和少头数设计,额外开销微乎其微。在 128K 长上下文下,解码成本较 V3.1‑Terminus 下降 70%,从 2.40 美元/百万 token 降至 0.70 美元。 训练过程分两阶段:首先从 V3.1‑Terminus 冻结权重进行“稠密预热”(dense warm‑up),让索引器模仿稠密注意力分布(2.1B token);随后切换稀疏模式,全参数训练 943.7B token,结合低学习率确保性能平稳过渡。 此外,V3.2 首创“Thinking in Tool‑Use”功能,将推理过程无缝嵌入工具调用,支持思考模式与非思考模式的双重工具交互,适用于代码调试、多步规划等代理任务。
在强化学习(RL)阶段,DeepSeek 投入超过预训练计算的 10%,采用 GRPO‑style 框架:无偏 KL 估计提供纯净奖励信号、离策略序列掩码确保旧 rollout 安全训练、MoE 路由一致性避免采样偏差。 数据合成是另一杀手锏:覆盖 1800+ 环境和 85,000+ 复杂指令,包括搜索代理轨迹、代码解释器和多工具交互,模拟真实场景如行程规划和 Web 研究。 这些创新让 V3.2 系列在代理性能上脱颖而出,例如在多轮交互中保持上下文连贯性,而非简单生成。
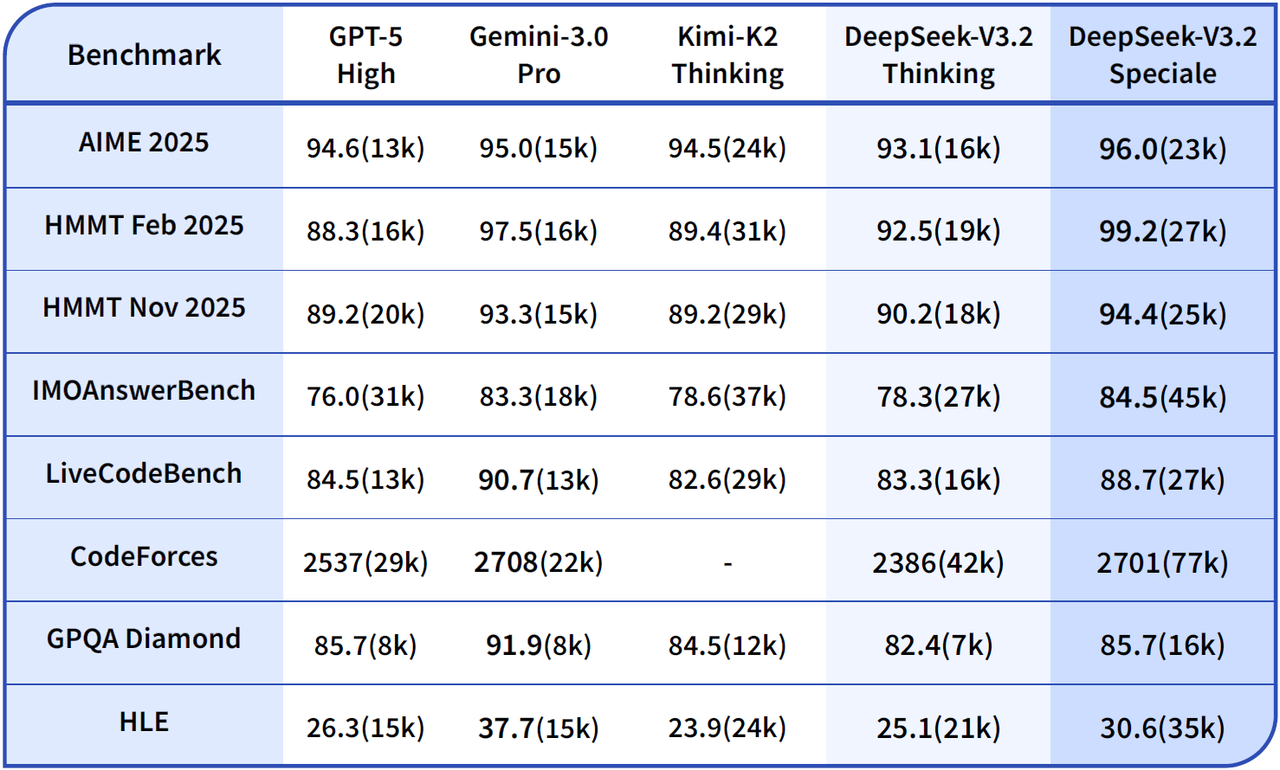
(注:V3.2‑Speciale 版本在处理复杂任务方面表现出色,但需要更高的令牌使用量。目前仅提供 API 接口(不支持工具),以支持社区评估和研究。)
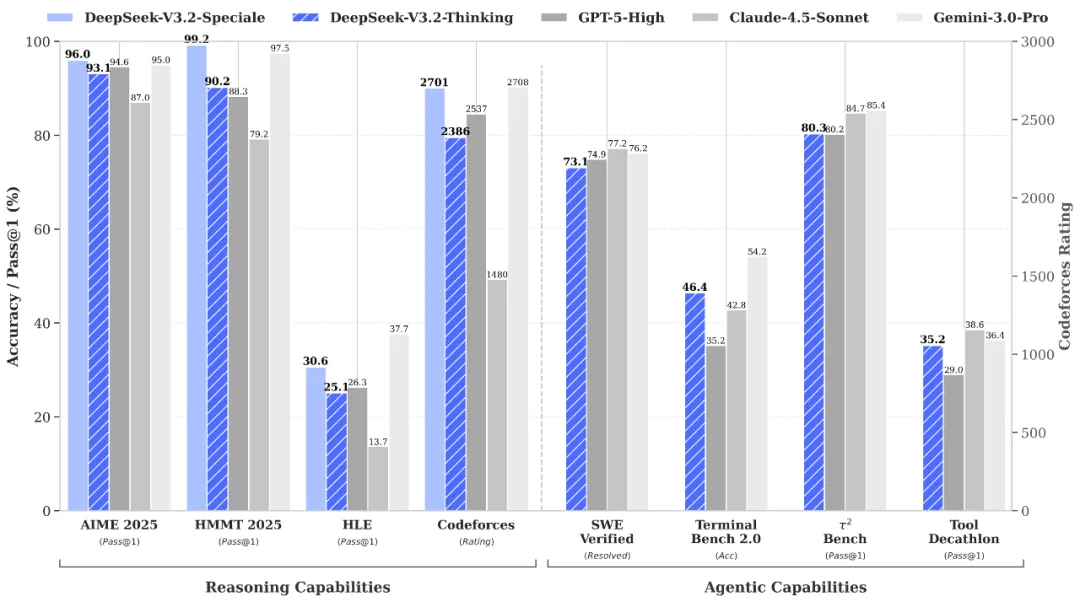
性能基准数据进一步印证其“推理极强”之名。V3.2 在 AIME 2025 上 pass@1 得分 93.1%,HMMT 2025 达 92.5%;V3.2‑Speciale 则飙升至 AIME 96.0%(超 GPT‑5‑High 的 94.6% 和 Gemini 3.0 Pro 的 95.0%),HMMT 99.2%(超 Gemini 的 97.5%)。 在竞赛级任务中,Speciale 变体在 2025 IMO 获 35/42 分(金牌级)、IOI 492/600 分(第 10 名)、ICPC 世界决赛 10/12 题(第 2 名)、中国数学奥林匹克(CMO)金牌。 编码基准上,V3.2 在 SWE‑Verified 修复 73.1% bug(仅略低于 GPT‑5‑High 的 74.9%),Terminal Bench 2.0 达 46.4%(超 GPT‑5 的 35.2%)。 与 Claude 4.5 相比,V3.2 在复杂工具使用基准上仅小幅落后,但整体推理匹配或超过 GPT‑5 基线。 这些成绩得益于合成数据蒸馏,Speciale 在高计算模式下“深度思考”,但需 2‑3 倍 token 消耗。
当然,V3.2 系列并非完美。世界知识(尤其是近期事件)仍落后封闭模型,token 效率在极难证明任务中稍逊,且 Speciale 不支持工具调用,定位纯推理“脑中思考”。 开发者反馈显示,在长上下文下虽高效,但极高负载任务可能需额外错误处理。 尽管如此,其优势显而易见:25‑30 倍于 GPT‑5/Gemini 的成本优势,加上开源许可,极大降低了门槛。
这一发布对行业冲击深远。作为中国 AI 的代表,DeepSeek 绕过美出口管制,以 30 倍于 Gemini 开发成本的资源(约 Google 的 1/30)实现前沿性能,证明开源路径的潜力。 VentureBeat 分析称,这或颠覆 U.S. 科技霸权,推动 AI 从“工业火箭科学”向“大众基础设施”转型。 欧盟数据隐私担忧(德国、意大利已禁相关 App)和美国政府设备禁令虽存,但开源扩散不可逆转。 X 平台上,DeepSeek 官方帖子获超 1 万点赞,用户称其“为 AGI 冬天带来暖色”。 在 Reddit 的 r/LocalLLaMA 子版块,讨论帖获数百赞,开发者赞叹“开源终于追平闭源”。
展望未来,DeepSeek 计划扩展预训练规模,填补知识空白,并探索 10M‑100M 超长上下文。 V3.2 系列的问世,不仅是为代理时代铺路,更预示开源 AI 将主导下一轮创新浪潮。开发者与研究者正蜂拥测试,这一“推理魔盒”能否真正“拜拜” GPT‑5 和 Gemini?答案或在社区评测中揭晓。