
经过相对漫长的等待后,中国杭州初创公司 DeepSeek 在本周一(2025年9月29日)面向开发者和公众发布了其最新的实验性模型 DeepSeek‑V3.2‑Exp,并将其定位为通向下一代架构的“中间步骤”(intermediate step)。公司在官方公告与开发者平台上介绍,V3.2‑Exp 在 V3.1‑Terminus 的基础上引入了名为 DeepSeek Sparse Attention(DSA) 的稀疏注意力机制,旨在提升长上下文场景下的训练与推理效率,同时显著降低计算成本。官方表示该模型已在其应用、网页版与 API 上线,并同步将 API 价格下调 50% 以上,以扩大普及与测试规模。
总结来看,本次DeepSeek‑V3.2‑Exp发布有如下几个亮点:
1、引入稀疏注意力机制(DeepSeek Sparse Attention, DSA)
- 通过在注意力计算中只选择部分关键 token,大幅降低计算复杂度。
- DSA属于对荣获2025年ACL(Association for Computatioanl Linguistics)最佳论文奖‑‑‑ Native Sparse Attention‑NSA的改进版本,该论文原由DeepSeek和北京大学、华盛顿大学合作发表
- 提升长上下文处理的效率与稳定性,适合长文档问答、代码理解、多轮对话等任务。
2、显著降低推理与训练成本
- 在保持输出质量的同时,大幅度降低算力消耗。
- API 定价同步下降 50% 以上,对企业与开发者更加友好。
3、定位为“中间版”或过渡版本
- V3.2‑Exp 被定位为实验性中间版本,用于测试新机制与收集市场反馈。
- 为后续大版本迭代(V3.5 或 V4)积累经验。
4、开源与开发者支持
- 部分代码与推理脚本已在 Hugging Face 与 ModelScope 上开放。
- 方便研究者与工程师快速上手和复现。
5、商业策略:降价 + 扩大用户规模
- 借助价格下调与开放 API 吸引更多开发者使用。
- 在大规模应用与成本敏感场景(如客服机器人、知识库检索)更具优势。
6、适配国产 AI 芯片 🧩
- V3.2‑Exp 针对国产 AI 芯片进行了深度优化,保证在非英伟达 GPU 环境下也能高效运行。
- 有助于提升国产算力生态的利用率,降低对海外硬件的依赖。
从技术角度看,DeepSeek 所谓的 DSA 属于稀疏注意力(sparse attention)家族:通过在注意力计算中只聚焦于一部分关键 token 或采用可学习的索引选择机制,来把注意力计算从典型的二次复杂度(O(n²))向近线性复杂度靠拢。这类方法近年来成为处理超长上下文的主流思路之一,但实现细节与选取策略会直接影响模型的效能与稳定性。DeepSeek 在 Hugging Face 的仓库中同时开源了部分实现与推理脚本,便于社区复现与测试其在不同长度与任务下的表现。
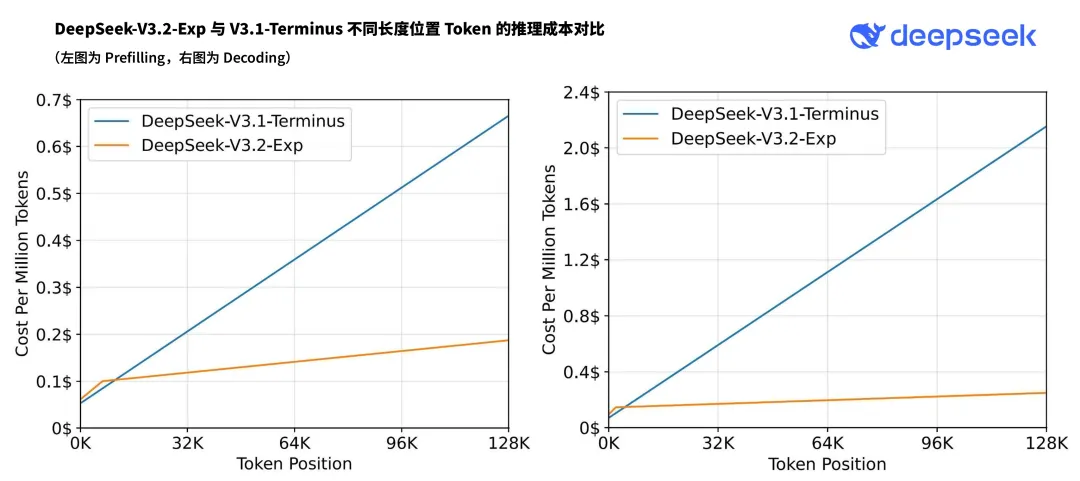
产业影响方面,V3.2‑Exp 并不被 DeepSeek 自称为一次“革命性”升级,而是一次工程与架构验证:在保持相当生成质量的前提下,探索通过架构层面的稀疏化来压缩成本的可行路径。业内观察者认为,如果 DeepSeek 能够在真实产品场景中以更低的计算成本交付近似的体验,它将在成本敏感的应用场景(例如大规模在线 API、聊天机器人、企业私有化部署)中获得明显优势,这也可能拉低市场平均 API 定价并对国内外同行形成压力。该公司的此番策略同时伴随着明显的商业信号:通过降价吸引流量并扩大模型使用样本,从而快速收集真实世界的反馈以继续迭代。
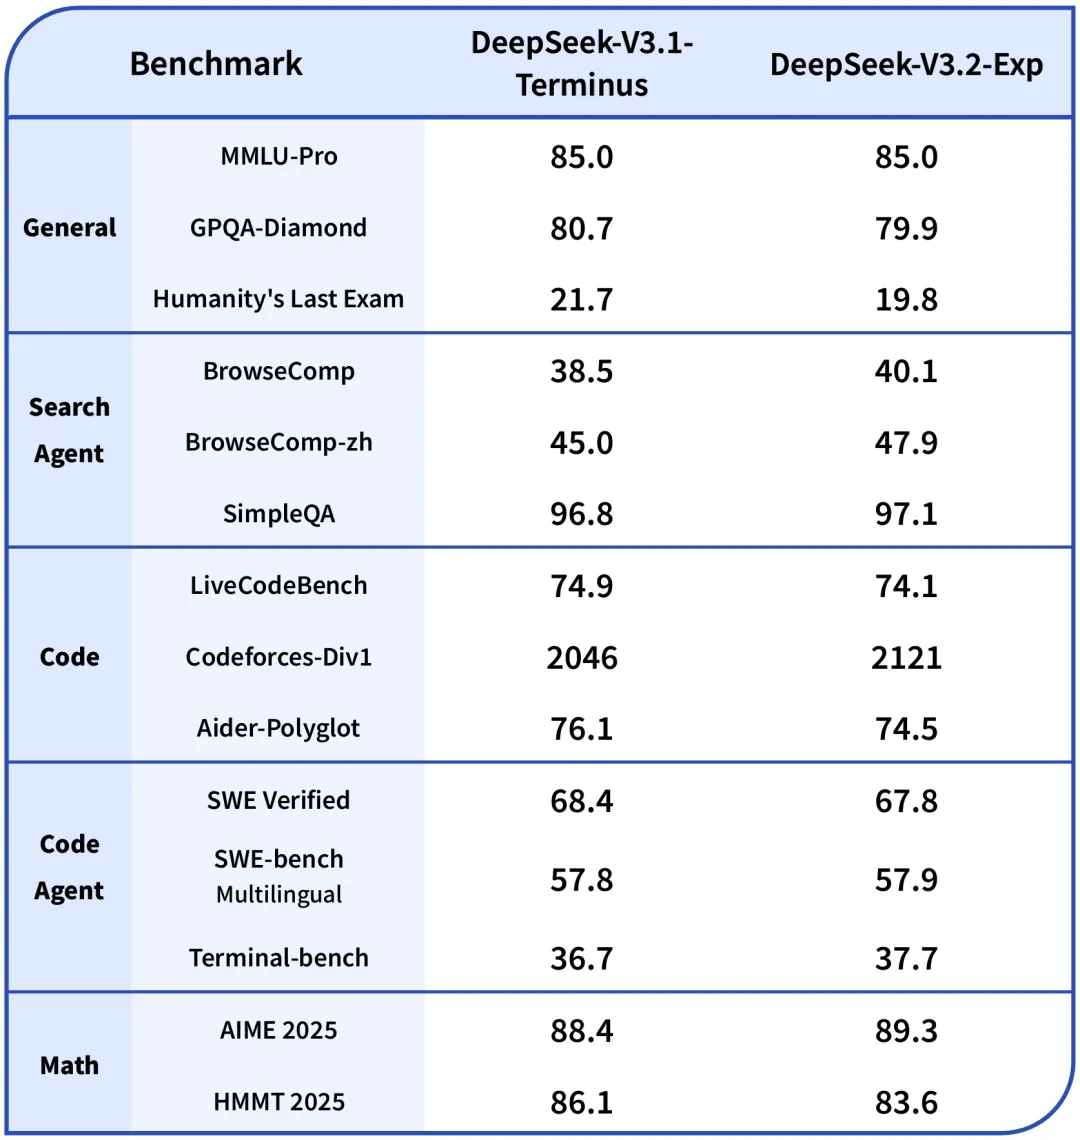
媒体与分析机构在第一时间对 DeepSeek 的发布给出了不同侧重的解读。路透社在报道中指出,V3.2‑Exp 是 DeepSeek 向其“下一代架构”过渡的试验性版本,可能不会像此前的 V3 与 R1 那样掀起完全同等规模的行业震荡,但若能在成本与长上下文处理上取得实效,仍将强化其市场竞争力。彭博与南华早报等也关注到该公司在本次发布中对国产 AI 芯片和去中心化部署的适配策略,认为 DeepSeek 正在试图用工程创新弥补在算力与生态上的差距。
值得注意的是,DeepSeek 近年的开放源代码与“低价”策略并非孤立事件。公司此前就已公开若干代码库、算法细节,并在先前版本中引入了诸如 Native Sparse Attention(NSA)等优化思路以提升长序列训练效率;此次 V3.2‑Exp 则可视为在该路线上的又一次实装检验。与此同时,外界对 DeepSeek 的关注也并不全是正面:此前关于是否存在对某些外部模型方法的不当借鉴的舆论和调查仍有散见报道,这也给其透明度与合规性提出了更高要求。
对开发者与企业用户而言,短期可关注的关键点包括:V3.2‑Exp 在不同任务(例如长文档问答、代码理解、多轮对话)上的质量‑成本权衡表现、DSA 在极长上下文下的泛化稳定性、以及官方开源代码或推理优化工具的成熟度。DeepSeek 把模型放在 Hugging Face 与 ModelScope 等平台上同步发布,意味着研究社区与工程师能够较快地跑通复现实验、对比其他稀疏/高效注意力变体,从而更快地判定该架构的实际价值。
DeepSeek‑V3.2‑Exp 的发布更像是一枚“探针”——既为下一代更大规模、更多创新的架构搜集工程数据,也通过价格策略吸引更广的使用者群体。它既反映了中国 AI 初创公司在模型工程与成本控制方面的持续尝试,也提醒行业关注在追求更低成本同时必须兼顾模型可靠性、数据与方法透明度的长期挑战。未来数周到数月,随着更多基准测试、社区复现结果与产品级别的使用反馈出现,外界将更清楚地评估 DSA 及 V3.2‑Exp 在真实世界中的实际价值。