
引言
2026年1月27日,中国开源AI领军企业深度求索(DeepSeek)正式发布DeepSeek‑OCR 2模型,这一视觉语言模型(Vision‑Language Model,VLM)在文档理解和光学字符识别(OCR)领域实现重大突破。该模型引入“视觉因果流”(Visual Causal Flow)概念,通过动态重新排序视觉token的方式,显著提升了对复杂文档布局的理解能力,在多个国际基准测试中刷新SOTA(State‑of‑the‑Art)纪录。DeepSeek官方GitHub仓库和Hugging Face模型卡同步上线,模型参数规模仅3B,却在视觉文档理解、OCR精度和多模态推理上表现出色,被视为“3B级别最强文档AI”。
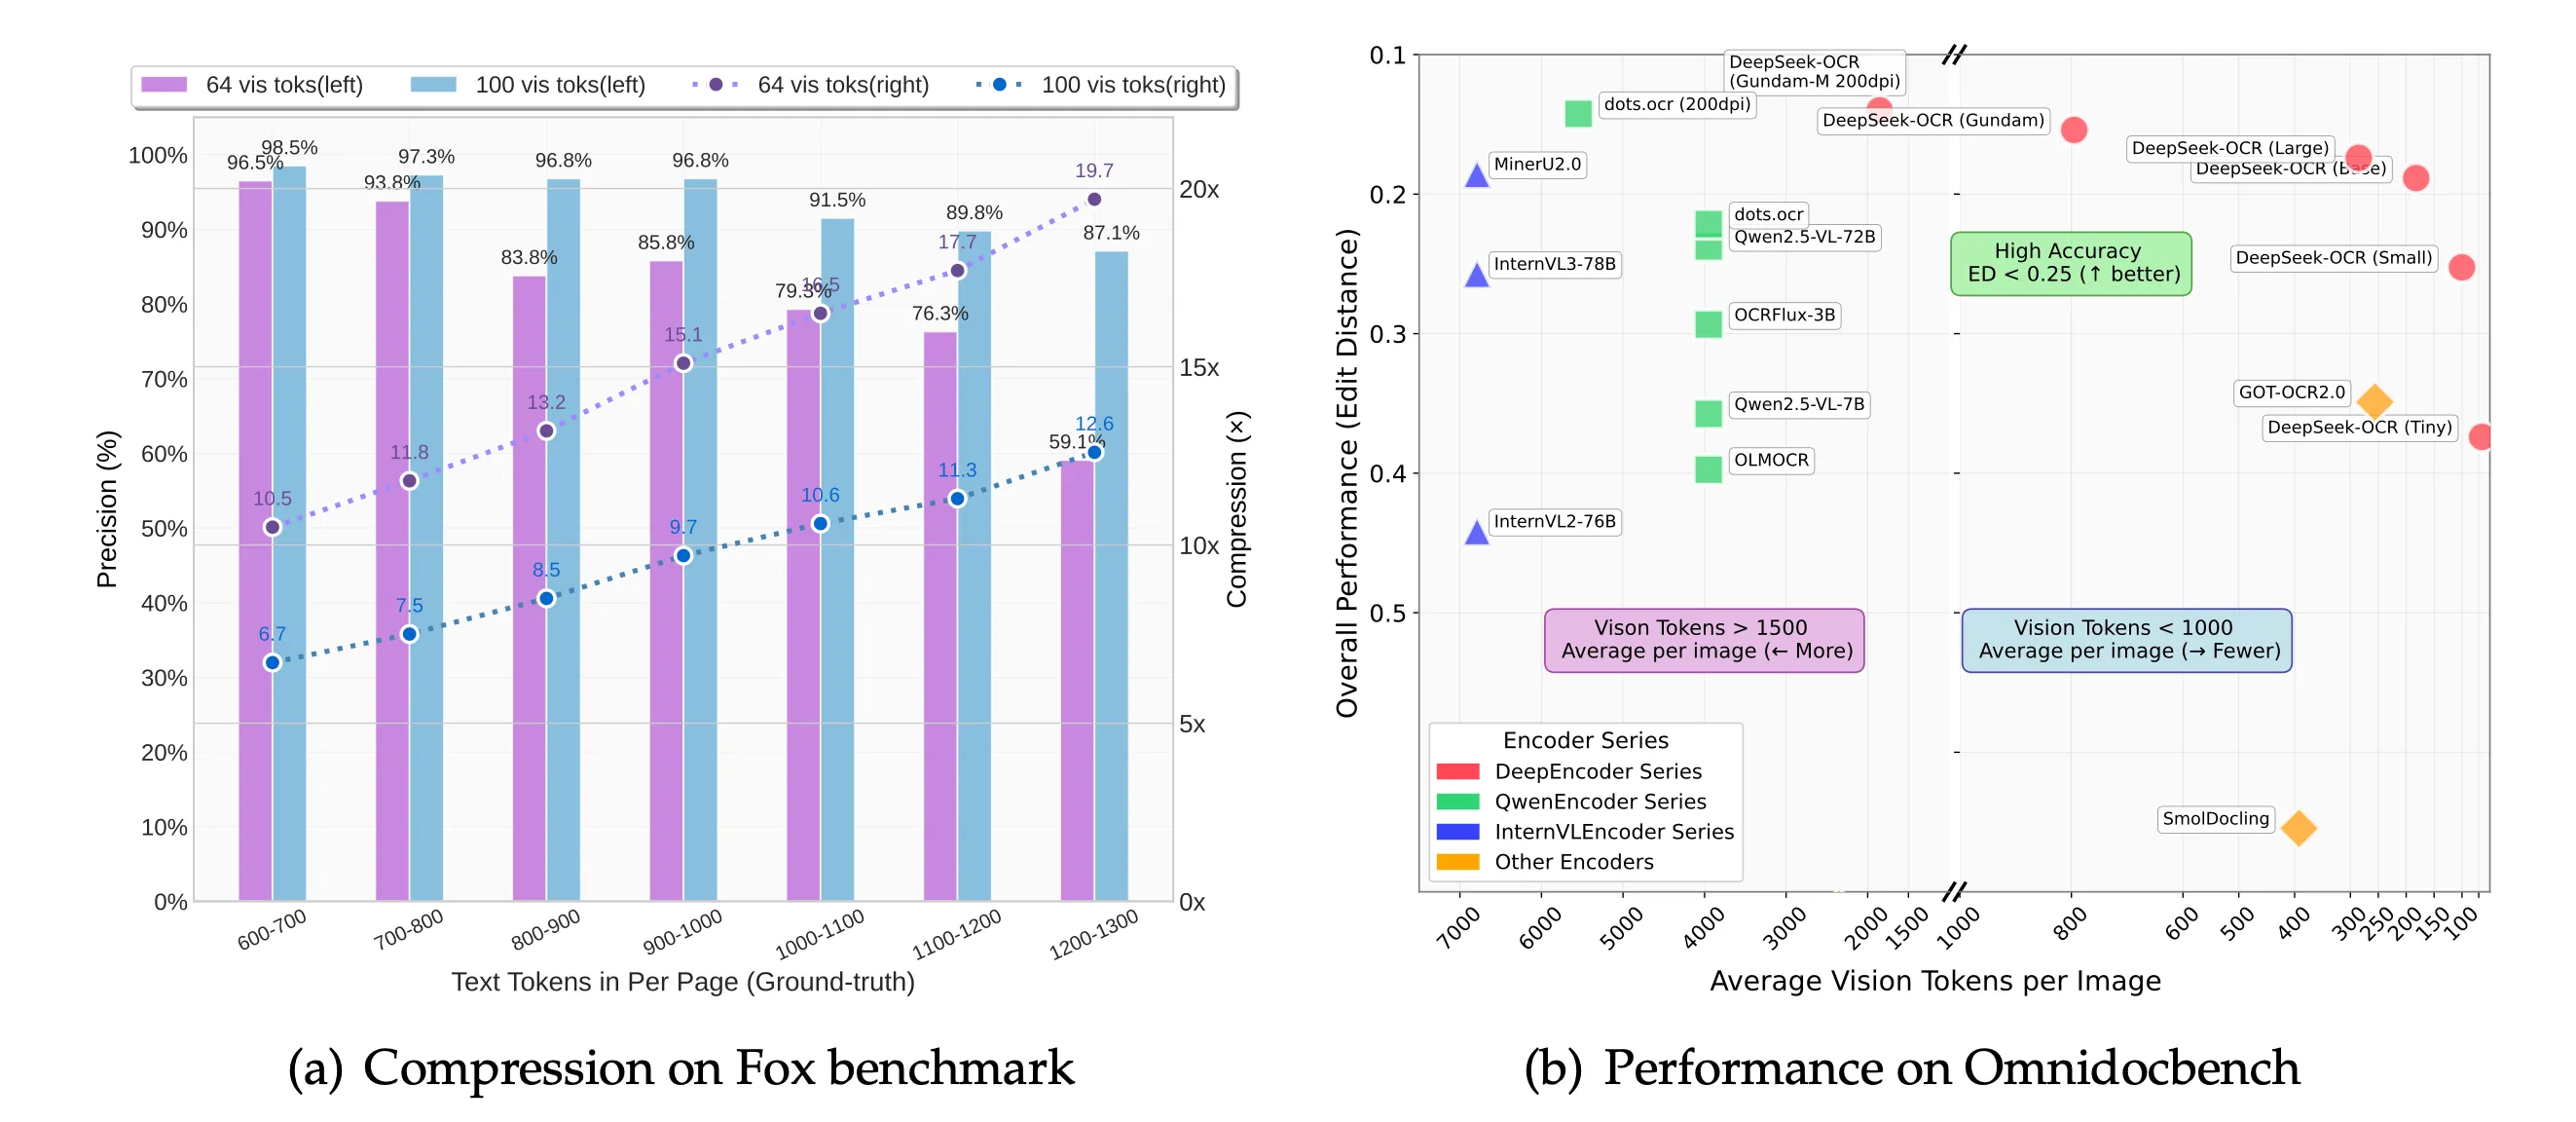
这一发布延续了DeepSeek自2025年DeepSeek‑OCR系列以来对“视觉压缩与长上下文优化”的探索路线。原版DeepSeek‑OCR通过光学压缩实现7‑20倍上下文压缩,而DeepSeek‑OCR 2则聚焦逻辑理解瓶颈,解决传统OCR在表格、公式、交叉布局等复杂场景下的准确率下降问题。Odaily News和AIBase报道称,该模型标志着中国团队在开源VLM领域的又一里程碑,推动文档AI从“字符识别”向“语义理解”转型。
模型规格与整体架构
DeepSeek‑OCR 2参数规模为3B(30亿),采用端到端视觉语言架构,包括视觉编码器(DeepEncoder V2)和语言解码器(DeepSeek‑3B‑MoE‑A570M)。视觉编码器负责将高分辨率文档图像压缩为少量视觉token,语言解码器则基于这些token进行语义理解和文本生成。
核心组件:
- DeepEncoder V2:视觉编码器升级版,替换原版CLIP骨干为Qwen2‑0.5B轻量LLM架构,利用语言理解能力实现语义感知视觉编码。结合窗口注意力(基于SAM)和密集全局注意力,实现局部细节与全局布局的融合。图像通过2层卷积压缩器16×下采样,生成高效视觉token。
- DeepSeek‑3B‑MoE‑A570M解码器:混合专家(MoE)架构,每token激活约570M参数(6/64路由专家+2共享专家),高效推理。
- 视觉因果流(Visual Causal Flow):核心创新模块,动态根据文档内容和语义关系重新排序视觉token,而非固定栅格扫描顺序,实现“像人类一样阅读”文档。
模型支持多语言OCR、复杂布局解析(表格、公式、图表)、结构化提取(HTML/LaTeX/Markdown输出),并兼容vLLM等高效推理框架。
视觉因果流:突破OCR性能瓶颈的核心原理
传统OCR(如Tesseract、PaddleOCR)依赖固定扫描路径(如从左到右、从上到下),在多列布局、交叉引用、图表说明等复杂文档中容易丢失逻辑关系,导致准确率急剧下降。DeepSeek‑OCR 2的“视觉因果流”概念直接针对这一瓶颈,原理清晰易懂:
- 视觉token生成与初始排序 输入高分辨率文档图像,经DeepEncoder V2压缩为少量视觉token(通常100‑800个),初始顺序基于栅格扫描。
- 因果关系建模 模型利用Qwen2‑0.5B的语言理解能力,分析视觉token间的语义关系(如表格标题决定单元格含义、图表标题解释上方图示)。构建因果图(causal graph),识别“谁影响谁”的逻辑流。
- 动态重新排序 根据因果图,模型在推理阶段动态调整token顺序。例如,先处理标题再处理正文,先读图表说明再解析图表内容。这种“像人类阅读”的顺序显著提升理解准确率,避免传统固定路径的“前后矛盾”问题。
- 多轮自反思与扩展 结合测试时扩展机制,模型在必要时进行多轮反思,进一步优化token顺序和语义提取,实现对难题的深度处理。
这一机制本质上是“视觉序列的重构”,通过因果推理打破固定扫描瓶颈。论文《DeepSeek‑OCR 2: Visual Causal Flow》指出,该方法在OmniDocBench等基准上,使用相同视觉token数量时,准确率提升30%以上。
性能表现与SOTA突破
DeepSeek‑OCR 2在多个基准测试中刷新纪录:
- OmniDocBench:使用100个视觉token超越GOT‑OCR2.0(需256个),800个token时大幅领先平均水平。
- OCR精度:压缩比10×时OCR准确率97%,20×时仍达60%,远超传统方法。
- 文档理解:复杂布局(多栏、交叉、公式、图表)识别率领先,化学公式(SMILES)、几何图形解析能力突出。
- 多语言支持:覆盖100+语言,中文表现尤为出色。
AIBase和Odaily News报道称,该模型在视觉文档理解、OCR精度和多模态推理上实现SOTA,参数仅3B却超越许多10B+模型。 与前代DeepSeek‑OCR相比,OCR 2在逻辑理解和动态处理上提升显著,标志着视觉压缩从“量”向“质”的飞跃。
应用案例
DeepSeek‑OCR 2适用于文档数字化、知识提取、自动化办公等领域。
- 法律与金融文档处理:企业用户使用模型解析密集PDF合同,提取条款、表格和签名,准确率超95%,节省人工审核时间。
- 学术论文分析:研究者上传论文图像,模型自动提取公式、图表说明和参考文献,生成Markdown结构化输出,便于后续分析。
- 多语言档案数字化:博物馆使用模型处理古籍、手写文档,支持100+语言,实现高效数字化和语义检索。
- 企业RPA集成:结合Agent工具链,模型自动读取发票、合同,提取关键字段并录入ERP系统。
这些案例在GitHub和ModelScope社区广泛分享,证明模型在实际场景中的实用性。
影响与挑战
DeepSeek‑OCR 2的发布进一步巩固了中国在开源VLM领域的领先地位,推动文档AI从字符识别向语义理解转型。Hugging Face报告显示,中国开源模型下载占比17.1%,DeepSeek系列贡献显著。
挑战包括:
- 计算资源:虽参数高效,但高分辨率文档仍需强大GPU支持。
- 泛化能力:极端手写或低质量扫描文档准确率仍有提升空间。
- 伦理与安全:文档隐私保护需加强,防止敏感信息泄露。
结论
DeepSeek‑OCR 2通过视觉因果流创新,突破了传统OCR的逻辑理解瓶颈,实现3B规模下的SOTA性能。这一发布不仅是技术突破,更是开源生态的典范。未来,随着更多社区贡献和生态整合,它将加速文档AI的产业落地,推动全球AI向更智能、更高效方向演进。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com