
在2026年元旦之际,DeepSeek团队发布的论文《mHC: Manifold‑Constrained Hyper‑Connections》(流形约束超连接)引发了AI社区的广泛关注。这篇由解振达、韦毅轩、曹桓奇和DeepSeek创始人梁文峰联名发表的预印本(arXiv:2512.24880),提出了一种新型架构mHC,旨在解决传统超连接(Hyper‑Connections,简称HC)在大规模语言模型(LLM)训练中的不稳定性问题,同时保留其性能优势。作为DeepSeek‑V3模型的后续创新,mHC通过数学上的“流形约束”恢复了残差连接的核心属性——恒等映射(Identity Mapping),并结合工程优化,实现更高效的训练。这一架构的原理并非高深莫测,而是对神经网络信息流动机制的巧妙优化。本文将用通俗易懂的语言,结合比喻和关键数学细节,逐步拆解mHC的原理,帮助读者理解其从问题发现到解决方案的完整逻辑。
先说老问题:神经网络为什么需要“残差连接”?
要理解mHC,先从神经网络的基本问题说起。深度学习模型如Transformer就像一座高耸入云的大楼,每一层(layer)处理信息后传递给下一层。如果信息直接一层一层传下去,很容易在途中“丢失”或“扭曲”——这就是梯度消失(Gradient Vanishing)或爆炸(Explosion)的问题。2015年,何恺明团队发明了残差连接(Residual Connections),相当于在楼房旁建了一条“直达电梯”或“高速公路”:每一层的输出不是单纯的计算结果,而是输入信号x加上本层计算F(x),即 y = x + F(x)。这里的x就是“原始信号”,直接“跳过”本层,确保信息平稳流动。
为什么这有效?因为它实现了“恒等映射”:如果本层计算F(x)≈0,输出就≈x,信号不变形、不放大、不缩小。数学上,这保持了信号的均值守恒(Signal Mean Conservation)和范数有界(Bounded Norms),让梯度在反向传播时稳定传递。Transformer的每一块(Attention + FFN)都用残差包裹,正是这个设计让模型能堆叠上千层。
HC的创新与痛点:多车道高速公路的“失控风险”
残差连接稳是稳,但信息流动太“单一”——就像单车道高速公路,流量有限。2024年,字节跳动提出超连接(HC):把单条残差流扩展成多条(扩展率n,通常4‑8),让信息在这些“平行通道”间交叉混合。比喻成多车道高速公路:主道还是x,但额外车道可以从主道分流、计算后合并,还允许车道间“换道”(通过全连接或随机矩阵)。
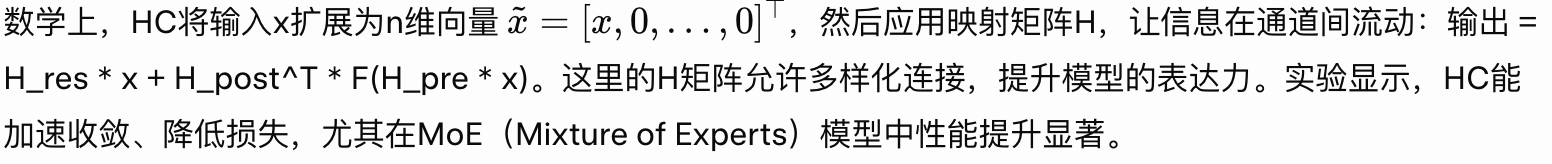
但问题大了:多车道随意换道,导致“交通事故”频发!信号被无限放大(论文中显示放大3000倍以上),训练不稳定——损失曲线突然飙升、梯度范数爆炸、内存访问开销增大。在大模型(万亿参数)中,这直接导致崩溃。根源是HC破坏了残差的恒等映射:H矩阵 unconstrained(无约束),可能让信号缩放失控,就像高速公路上没有限速和护栏,车速随意,结果乱套。
mHC的核心原理:加“护栏”的多车道设计
DeepSeek的mHC就是给HC加“护栏”:把H矩阵约束在一个特殊的数学空间——双随机矩阵(Doubly Stochastic Matrices)的Birkhoff多面体(Birkhoff Polytope)。通俗说,双随机矩阵是这样的权重表:每个元素非负(正向流动),每行和每列的和都=1(总量守恒)。
为什么这有效?因为它让信息混合变成“凸组合”(Convex Combination):输出是输入特征的加权平均,总量不变,不会放大或缩小。比喻:想象信息像水流,多车道混合水,但每桶水倒出后,总水量=1,不会溢出或蒸发。数学上,这确保了:
- 信号均值守恒:E[y] = E[x],平均值不变。
- 谱范数≤1:矩阵的最大奇异值≤1,防止信号指数级放大。
- 组合闭包:多层H的乘积还是双随机矩阵,端到端稳定。
怎么实现这个约束?用Sinkhorn‑Knopp算法:从一个初始矩阵H~\tilde{H}H~开始,反复做行归一化和列归一化(除以总和),迭代20次,就“投影”到双随机空间。公式:
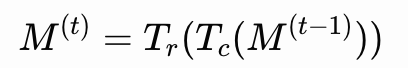
其中T_r是行归一化,T_c是列归一化。这算法1967年就有了,简单高效,只加一点计算开销。
mHC的层传播:先扩展输入为n维x~\tilde{x}x~,标准化(RMSNorm),然后计算三个H矩阵(pre、post、res):pre/post用sigmoid激活(确保非负),res用Sinkhorn投影。最终输出:
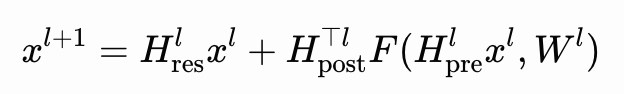
多层累积后,信号稳定流动,不会崩。
为什么mHC不慢?工程优化的“锦上添花”
光有原理不够,大模型训练还得快。DeepSeek加了三招优化:
- 内核融合(Kernel Fusion):用TileLang自定义GPU内核,把矩阵运算和归一化“融合”成一步,减少内存读写。激活用bfloat16(低精度快),参数用float32(高精度准)。
- 选择性重计算(Selective Recomputing):内存贵,别存所有中间结果。只每隔LrL_rLr层存一次主残差,其他重算。块大小公式
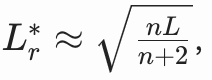
- ,平衡内存和计算(L是总层数,n扩展率)。
- DualPipe扩展:分布式训练中,用高优先级流重叠通信和计算,减少“管道气泡”(空闲时间)。
结果:在n=4时,时间只多6.7%,内存1.05倍。实验证明,mHC在3B‑27B模型上,损失降0.021,基准分升1‑2%。
mHC的深层意义:AI架构的“新范式”
mHC不只是修bug,它证明了“约束即自由”:通过数学空间限制,解锁更宽架构的潜力。比喻:像给孩子加护栏玩耍区,空间大又安全。未来,大模型可能都用类似流形约束,避免规模盲目膨胀。DeepSeek这篇论文,又一次展示了开源创新的力量,对资源有限团队尤其友好。
总之,mHC用流形护栏解决了HC的失控问题,让神经网络的信息流动更稳、更强。这不光是技术细节,更是AI从“野蛮生长”向“精耕细作”的转变。如果你搞AI训练,绝对值得一试!
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com