
在2026年元旦之际,中国AI初创公司DeepSeek发布了重磅新论文《mHC: Manifold‑Constrained Hyper‑Connections》(流形约束超连接),提出了一种名为mHC的全新架构。该论文由解振达(Zhenda Xie)、韦毅轩(Yixuan Wei)和曹桓奇(Huanqi Cao)共同担任第一作者,DeepSeek创始人兼CEO梁文锋(Wenfeng Liang)也位列作者名单之中。这一研究发表于arXiv(预印本编号2512.24880),旨在解决传统超连接(Hyper‑Connections,简称HC)在大规模模型训练中的不稳定性问题,同时保留其性能优势。作为DeepSeek在2025年开源模型DeepSeek‑V3基础上的一次重大创新,mHC架构通过流形约束恢复残差连接的恒等映射属性,并结合基础设施优化,实现更稳定的训练和更好的可扩展性。这一论文的发布标志着梁文峰团队在AI基础架构领域的又一突破,也为大语言模型(LLM)的未来发展指明了新方向。本文基于arXiv原论文、IT之家报道以及Hugging Face论文页面等权威来源,详细解读mHC架构的技术细节、实验结果及其意义。
论文背景与动机:残差连接的演进与挑战
残差连接(Residual Connections)是深度学习模型如ResNet和Transformer的核心组件,由何恺明(Kaiming He)等人在2015年提出。其关键在于“恒等映射”(Identity Mapping)属性,确保信号在深层网络中稳定传播,避免梯度消失或爆炸问题。近年来,研究者通过扩展残差连接来提升模型性能,其中超连接(HC)是一种典型方法。HC通过拓宽残差流(Residual Stream)的宽度(扩展率n,通常为4‑8)和多样化连接模式(如全连接或随机连接),实现了显著的性能增益,而不增加计算复杂度(FLOPs)。例如,在Transformer中,HC可以允许残差分支间的信息交换,提升表示能力。
然而,HC的多样化连接破坏了原始残差的恒等映射属性,导致信号放大/衰减、训练不稳定(损失曲线突增、梯度范数爆炸)和内存访问开销增大。在大规模模型训练中,这些问题尤为突出:损失间隙(Loss Gap)扩大,梯度范数(Gradient Norm)异常波动,限制了HC在万亿参数模型中的应用。DeepSeek团队观察到,传统HC的 unconstrained 映射空间是根源,因此提出mHC框架,通过将残差连接空间投影到特定流形(Manifold)上,恢复恒等映射,同时保持HC的多样性优势。这一动机源于对模型拓扑架构设计的深入思考,旨在为基础模型的演进提供新路径。
mHC架构的技术细节:流形约束与投影机制
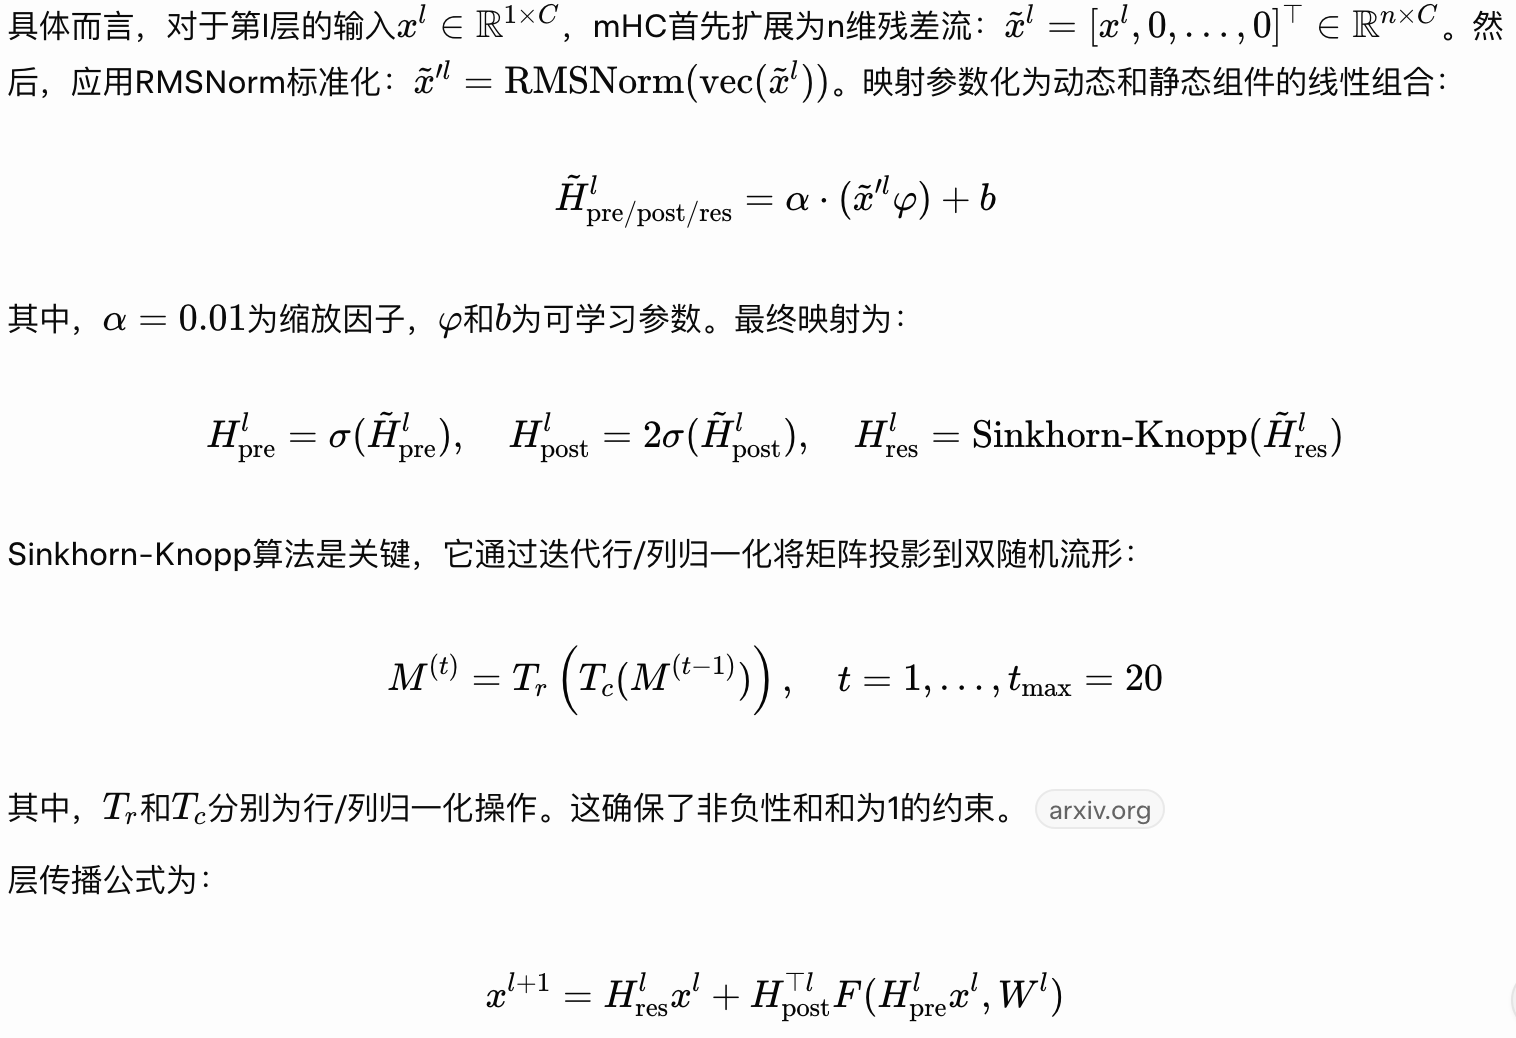
mHC的核心是一个通用框架,将HC的残差连接空间约束在双随机矩阵(Doubly Stochastic Matrices)的Birkhoff多面体(Birkhoff Polytope)上。双随机矩阵满足行和列和均为1的非负矩阵,确保残差映射为特征的凸组合(Convex Combination),从而实现信号均值守恒(Signal Mean Conservation)和范数有界(Bounded Norms)。
Sinkhorn‑Knopp算法是关键,它通过迭代行/列归一化将矩阵投影到双随机流形:
多层组合下:
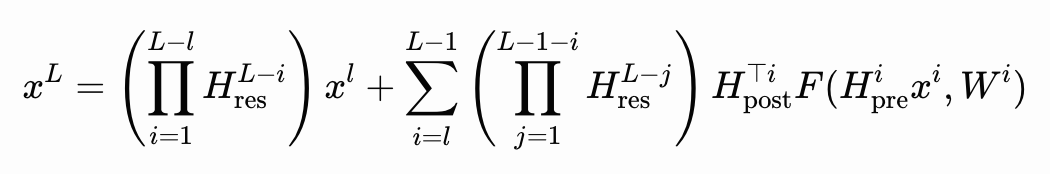
由于双随机矩阵的组合闭包性(Compositional Closure),产品矩阵仍为双随机,确保端到端稳定性。mHC的凸组合解释允许特征融合,同时界定谱范数(Spectral Norm)≤1,避免信号爆炸。
此外,mHC结合基础设施优化:内核融合(Kernel Fusion)使用TileLang自定义混合精度内核(bfloat16激活、float32参数);选择性重计算(Selective Recomputing)每LrL_rLr层存储一次主残差,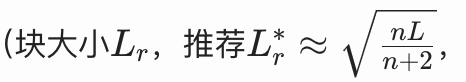 DualPipe扩展通过高优先级计算流重叠通信和计算。这些优化使mHC在n=4时仅增加6.7%时间开销。
实验设置与结果:大规模验证的性能跃升
论文在MoE(Mixture of Experts)模型上验证mHC,模型规模为3B、9B和27B参数,扩展率n=4。数据集按模型大小比例配置(如27B使用262B tokens),使用AdamW优化器、RMSNorm和RoPE位置编码。基准包括BBH、DROP、GSM8K、HellaSwag、MATH、MMLU、PIQA和TriviaQA。
结果显示,mHC显著提升稳定性:消除HC的损失突增和梯度范数波动(论文图5)。在性能上,mHC在8个基准中均优于基线和HC,例如在27B模型上,最终损失降低0.021,在BBH上提升2.1%,DROP上提升2.3%(论文表4)。计算缩放实验(图6a)证明mHC在3B‑27B规模下优势持续;令牌缩放(图6b)显示更多训练数据进一步放大收益。传播稳定性分析(论文图7)显示,mHC的最大增益幅度(Amax Gain Magnitude)从HC的~3000降至~1.6。映射可视化(论文图8)证实mHC避免了HC的极端值。
与基线相比,mHC在下游任务中平均提升1‑2%;与HC相比,避免不稳定,实现更好收敛。内存分析(论文表2)显示,通过重计算,mHC峰值内存仅为基线的1.05倍。
局限性与未来方向
尽管创新,mHC仍有局限:Sinkhorn‑Knopp的有限迭代导致轻微偏差;扩展率n增加内存访问;重计算块需与管道阶段对齐;仅探索双随机流形,其他流形未验证。未来,研究者可扩展到其他流形,或应用于更大模型如万亿参数级。arxiv.org
影响与意义:AI架构设计的启示
梁文锋署名的这一论文,不仅是DeepSeek在开源生态中的又一贡献,还为大模型训练提供了实用框架。作为DeepSeek‑V3的延续,mHC有望集成到未来模型中,提升稳定性与效率。IT之家报道称,这一架构“暴力优化AI架构”,在27B参数模型上仅增6.7%开销,却显著降低损失。在全球AI竞赛中,中国团队的创新凸显自主技术崛起。
总体而言,mHC通过流形约束深化了对拓扑设计的理解,推动基础模型从规模竞赛向架构优化转型。这一新年论文预示2026年AI将迎来更稳定、可扩展的时代。
▶️ 喜欢这篇内容?创作真的很辛苦!
欢迎关注我们的 YouTube 频道:
AI Rosetta
你的点赞、订阅和分享,是对我们最大的支持!🙏
更多AI新闻请访问:
https://www.airosetta.com